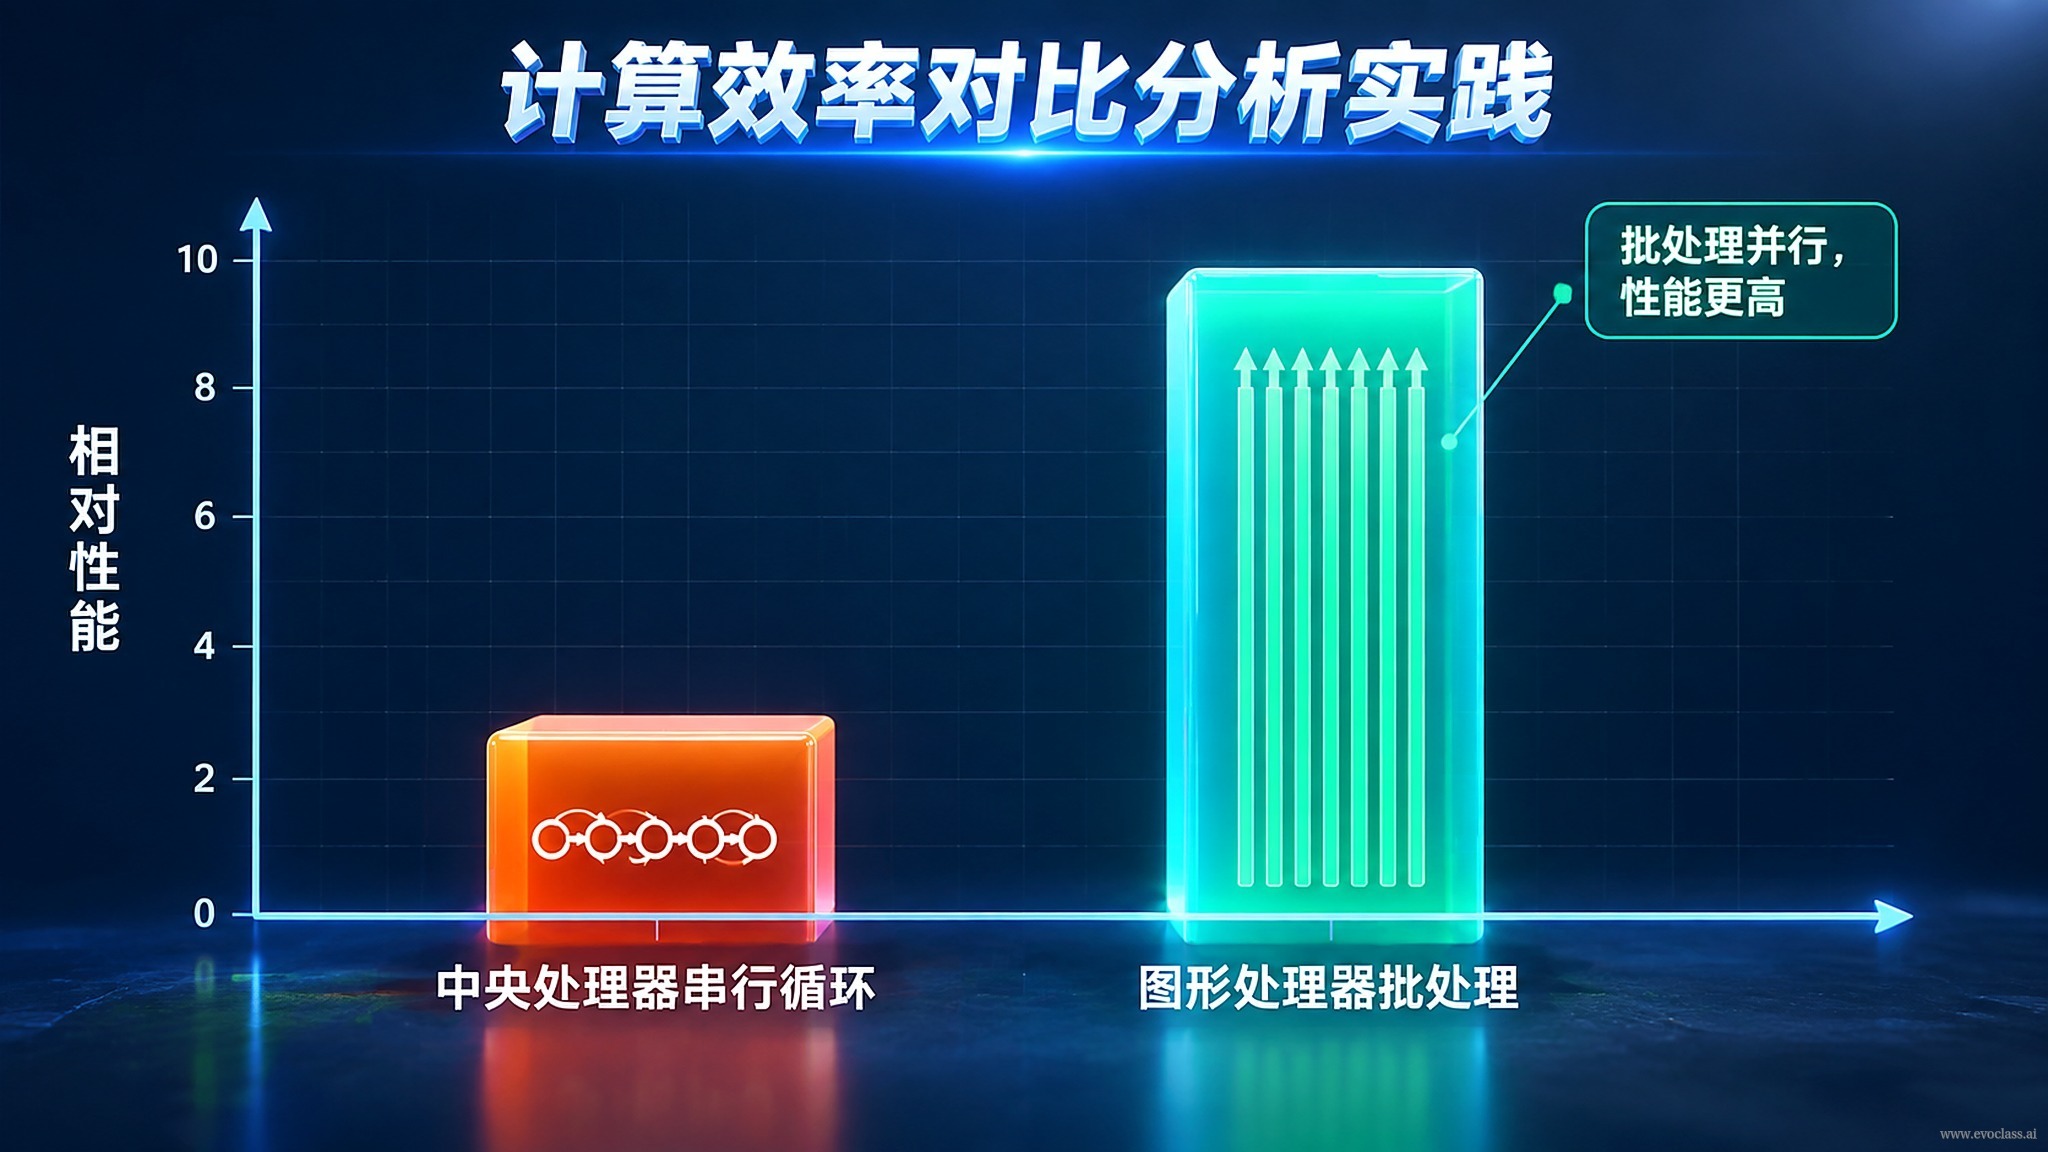
Trang này đưa "so sánh hiệu quả tính toán" vào một bài thực hành có thể tái lập:trên cùng một bài toán tiến hóa, so sánh hiệu quả đầu-cuối giữa duyệt tuần tự từng cá thể trên CPU truyền thống và xử lý theo lô tensor trên GPU của EvoX. Mục tiêu không phải là ghi nhớ kết luận "GPU nhanh hơn", mà là hiểu rõ tốc độ tăng từ song song hóa tensor đến từ đâu, cái giá phải trả là gì và giới hạn nằm ở đâu.
Hai đường cơ sở, cùng một bài toán
- Cơ sở tuần tự trên CPU: dùng vòng lặp gọi hàm đánh giá cho từng cá thể, mỗi thế hệ cần N lần lập lịch, cập nhật trạng thái và tổng hợp kết quả riêng lẻ. Việc điều khiển vòng lặp, chi phí trình thông dịch và truy cập bộ nhớ phân tán sẽ làm loãng năng lực tính toán thực tế; số lượng cá thể càng nhiều, tỷ lệ của những chi phí "phi tính toán" này càng cao.
- Triển khai đối chiếu bằng tensor trên GPU: EvoX tổ chức quần thể, đầu vào đánh giá và trạng thái vận hành thành tensor, thực thi đánh giá và toán tử theo lô trên GPU, một lần gọi bao phủ toàn bộ tập ứng viên, từ đó giảm mạnh số vòng lặp tuần tự và số lần lập lịch.
Giao thức đo lường: để phép so sánh có thể tái lập
Một phép so sánh có thể tái lập phảicố định bài toán, quy mô quần thể, số thế hệ lặp và hạt giống ngẫu nhiên, sau đó ghi lại: thời gian thực mỗi thế hệ, tổng thời gian, thông lượng (đánh giá/giây), tỷ lệ tăng tốc, cùng mức sử dụng GPU và dung lượng bộ nhớ GPU. Trước khi đo thời gian cầnkhởi động nóngđể loại trừ ảnh hưởng của lần biên dịch đầu tiên và việc cấp phát bộ nhớ GPU, đồng thời tại điểm đo thời gian phải thực hiệnđồng bộ thiết bị, đồng thời thống kê riêng thời gian tính toán và thời gian truyền dữ liệu giữa máy chủ và thiết bị. Thiếu bất kỳ khâu nào, tỷ lệ tăng tốc thu được đều có thể bị sai lệch.
Khác biệt đến từ đâu và bị ràng buộc bởi điều gì
- Nguồn lợi ích: song song theo lô, toán tử tensor hóa và song song trong thiết bị giúp một lần gọi xử lý toàn bộ tập ứng viên, hoàn thành nhiều đánh giá hơn trong một đơn vị thời gian.
- Điều kiện ràng buộc: kích thước lô, số chiều bài toán, mức độ vector hóa được của hàm đánh giá, chi phí sao chép giữa máy chủ và thiết bị cùng chi phí khởi động kernel đều ảnh hưởng đến tốc độ tăng cuối cùng. Lô quá nhỏ sẽ bị chi phí khởi động "ăn mất" lợi ích; nếu hàm đánh giá không thể vector hóa thì xử lý theo lô gần như không phát huy được tác dụng.
Kết luận thực hành
Trình tự đúng là:trước tiên xác minh hàm đánh giá có thể xử lý theo lô hay không, rồi mới so sánh triển khai CPU với GPU. Lợi thế hiệu quả cuối cùng phải quy về "đạt được nhiều thế hệ hơn hoặc nhiều phương án ứng viên hơn với cùng ngân sách tính toán", và dựa vào đó để quyết định cách triển khai cũng như thiết kế thí nghiệm, thay vì chỉ theo đuổi một con số tỷ lệ tăng tốc đẹp mắt.
So sánh hiệu quả giữa CPU tuần tự và GPU xử lý theo lôTrong phép so sánh, cơ sở tuần tự trên CPU đánh giá từng cá thể theo vòng lặp, mỗi thế hệ cần N lần lập lịch và cập nhật trạng thái, chi phí trình thông dịch và truy cập bộ nhớ làm loãng năng lực tính toán thực tế; GPU xử lý theo lô tổ chức quần thể và đầu vào đánh giá thành tensor, một lần gọi bao phủ toàn bộ tập ứng viên. Tỷ lệ tăng tốc bị ràng buộc bởi kích thước lô, mức độ vector hóa được của hàm đánh giá và chi phí sao chép giữa máy chủ và thiết bị.