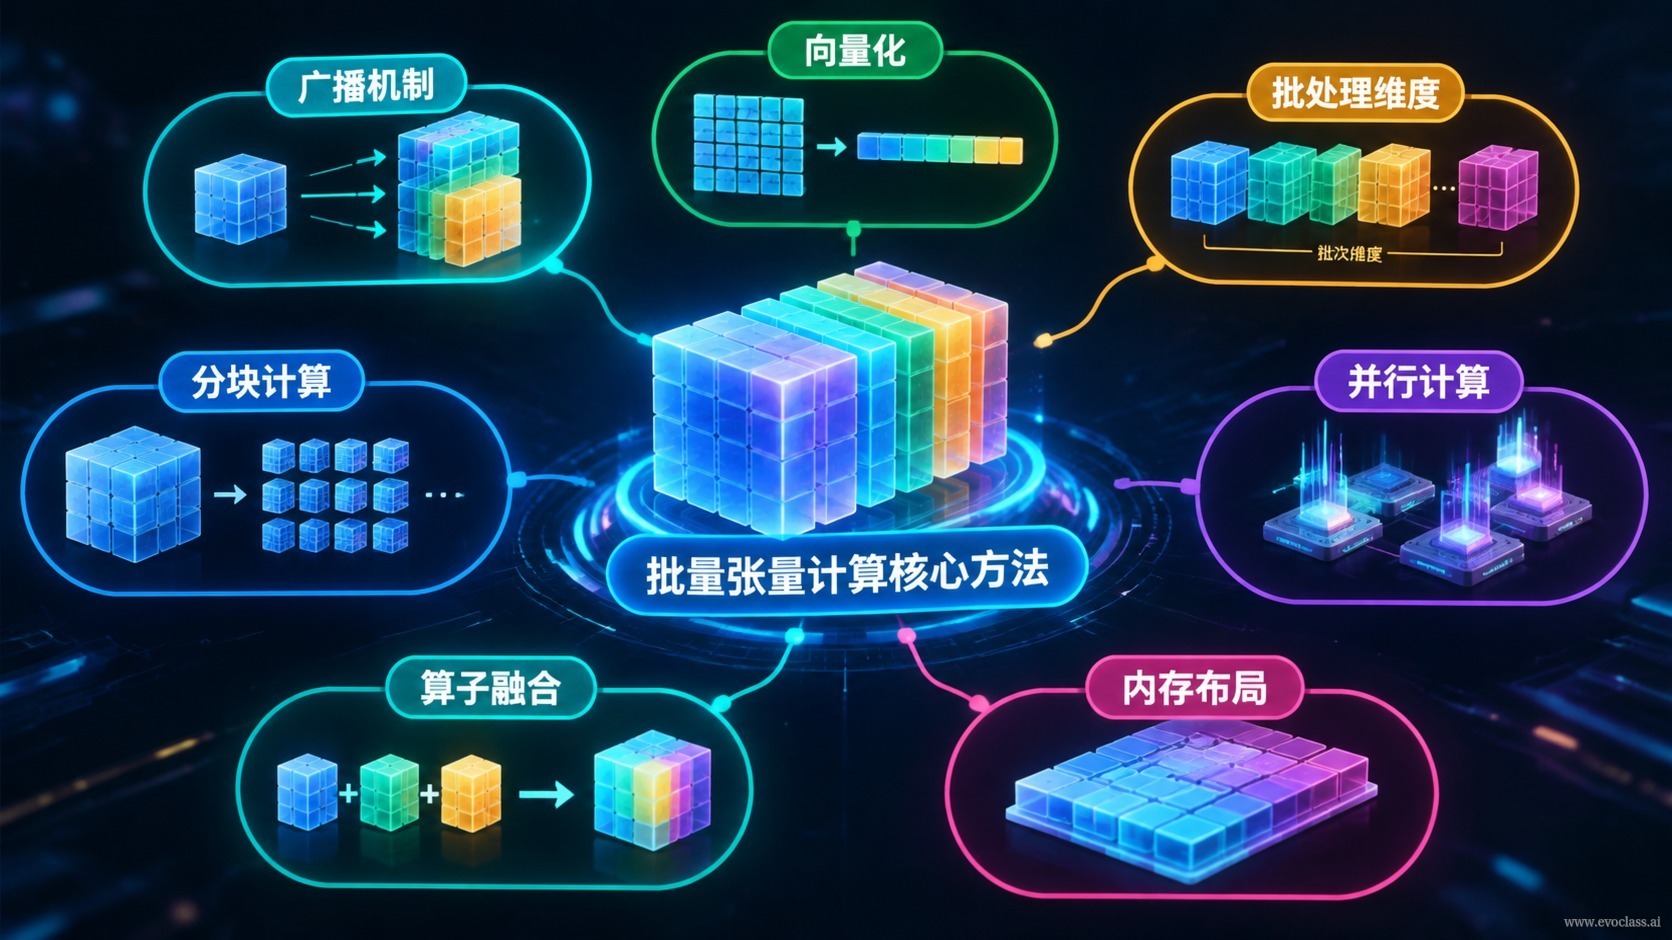
Trong nền tảng tensor hóa của EvoX,tính toán tensor theo lônằm ở tầng biểu đạt thuật toán: nó ánh xạ thống nhất các ứng viên, đánh giá và trạng thái trong vòng lặp tiến hóa thànhtensor có chiều lô, rồi giao cho các toán tử theo lô thân thiện với GPU và đồ thị tính toán đã biên dịch để thực thi. Mục tiêu rất rõ ràng — chuyển đổi “tiến hóa tuần tự từng cá thể” thành “tiến hóa song song toàn bộ quần thể”, để sức mạnh tính toán thực sự tác động vào chính quá trình tìm kiếm, thay vì bị tiêu tốn vào việc lập lịch và khởi động.
I. Biểu diễn quá trình tiến hóa thành tensor
Quy ước chiều lô N biểu thị số ứng viên (cá thể), khi đó ba yếu tố trong tiến hóa có thể được biểu diễn trực tiếp thành tensor:
- Tensor ứng viên: Quần thể X được tổ chức thành [N × D], D là số biến quyết định của một ứng viên.
- Tensor mục tiêu: Mục tiêu và ràng buộc F được tổ chức thành [N × M], M là số mục tiêu/ràng buộc; trong trường hợp đa mục tiêu, mỗi mục tiêu là một cột khác nhau của F.
- Đại lượng trạng thái: Số thế hệ, giá trị tối ưu hiện tại, bước nhảy v.v. được duy trì bằng bộ đệm vô hướng hoặc tensor nhỏ, thay vì ghi lại từng cá thể bằng đối tượng Python.
Như vậy, lai ghép, đột biến, chọn lọc, đánh giá đều được xử lý theo lô dọc theo chiều N, trong vòng lặp tiến hóa không còn xuất hiện rẽ nhánh và luồng điều khiển theo từng cá thể.
II. Toán tử theo lô: từ N lần gọi đơn ứng viên đến một phép toán theo lô
Ba biểu thức tối giản có thể đối chiếu, phác họa hình thái cơ bản của toán tử theo lô:
- Đột biến: X′ = X + σ·randn(X), cả lô ứng viên trong một phép toán theo lô đều nhận nhiễu ngẫu nhiên riêng, σ điều khiển cường độ nhiễu.
- Chọn lọc: idx = topk(F, k), chọn ra chỉ số của k ứng viên đứng đầu trong một lần từ độ thích nghi của N ứng viên.
- Đánh giá: Y = fθ(X), thay thế N lần gọi đơn ứng viên bằng một lần lan truyền xuôi theo lô hoặc mô phỏng theo lô.
Điểm mấu chốt không nằm ở một toán tử cụ thể nào, mà ở chỗ tất cả ứng viên chia sẻ cùng một đồ thị toán tử tensor: một lần gọi theo lô có thể cắt giảm chi phí trình thông dịch và chi phí khởi động kernel, khiến sức mạnh GPU/đa nhân thực sự tác động vào quá trình tìm kiếm tiến hóa. Xử lý ràng buộc và vượt biên cũng có thể được thực hiện bằng tensor mặt nạ trong cùng một phép toán theo lô, không cần rẽ nhánh riêng cho từng ứng viên.
III. Tối ưu đồ thị tính toán và chỉ số thông lượng
Viết quá trình tiến hóa nhiều thế hệ thành đồ thị luồng dữ liệu có thể biên dịch còn có thể khai thác thêm hiệu năng:Hợp nhất toán tửgiảm số lần khởi động kernel,Song song trong lôcho mọi ứng viên thực thi đồng thời,Thực thi bất đồng bộcho tính toán và truyền dữ liệu xen kẽ lẫn nhau,Tái sử dụng bộ nhớgiảm cấp phát tensor trung gian. Tương ứng, chỉ số hiệu năng cũng nên chuyển từ “độ trễ một bước” sangứng viên/giây hoặc thế hệ/giâycủa thông lượng — thực thi theo lô thì một lần gọi xử lý cả lô ứng viên, chỉ thông lượng tổng thể mới phản ánh trung thực hiệu suất tìm kiếm.
Sơ đồ tư duy phương pháp cốt lõi của tính toán tensor theo lôSơ đồ tư duy biểu diễn quá trình tiến hóa thành tensor có chiều lô: quần thể X là N×D, mục tiêu và ràng buộc F là N×M, lai ghép, đột biến, chọn lọc, đánh giá đều được xử lý theo lô dọc theo chiều N. Đột biến, chọn lọc topk và đánh giá lan truyền xuôi theo lô chỉ cần một lần gọi theo lô, chỉ số hiệu năng cũng chuyển từ độ trễ một bước sang thông lượng ứng viên/giây.