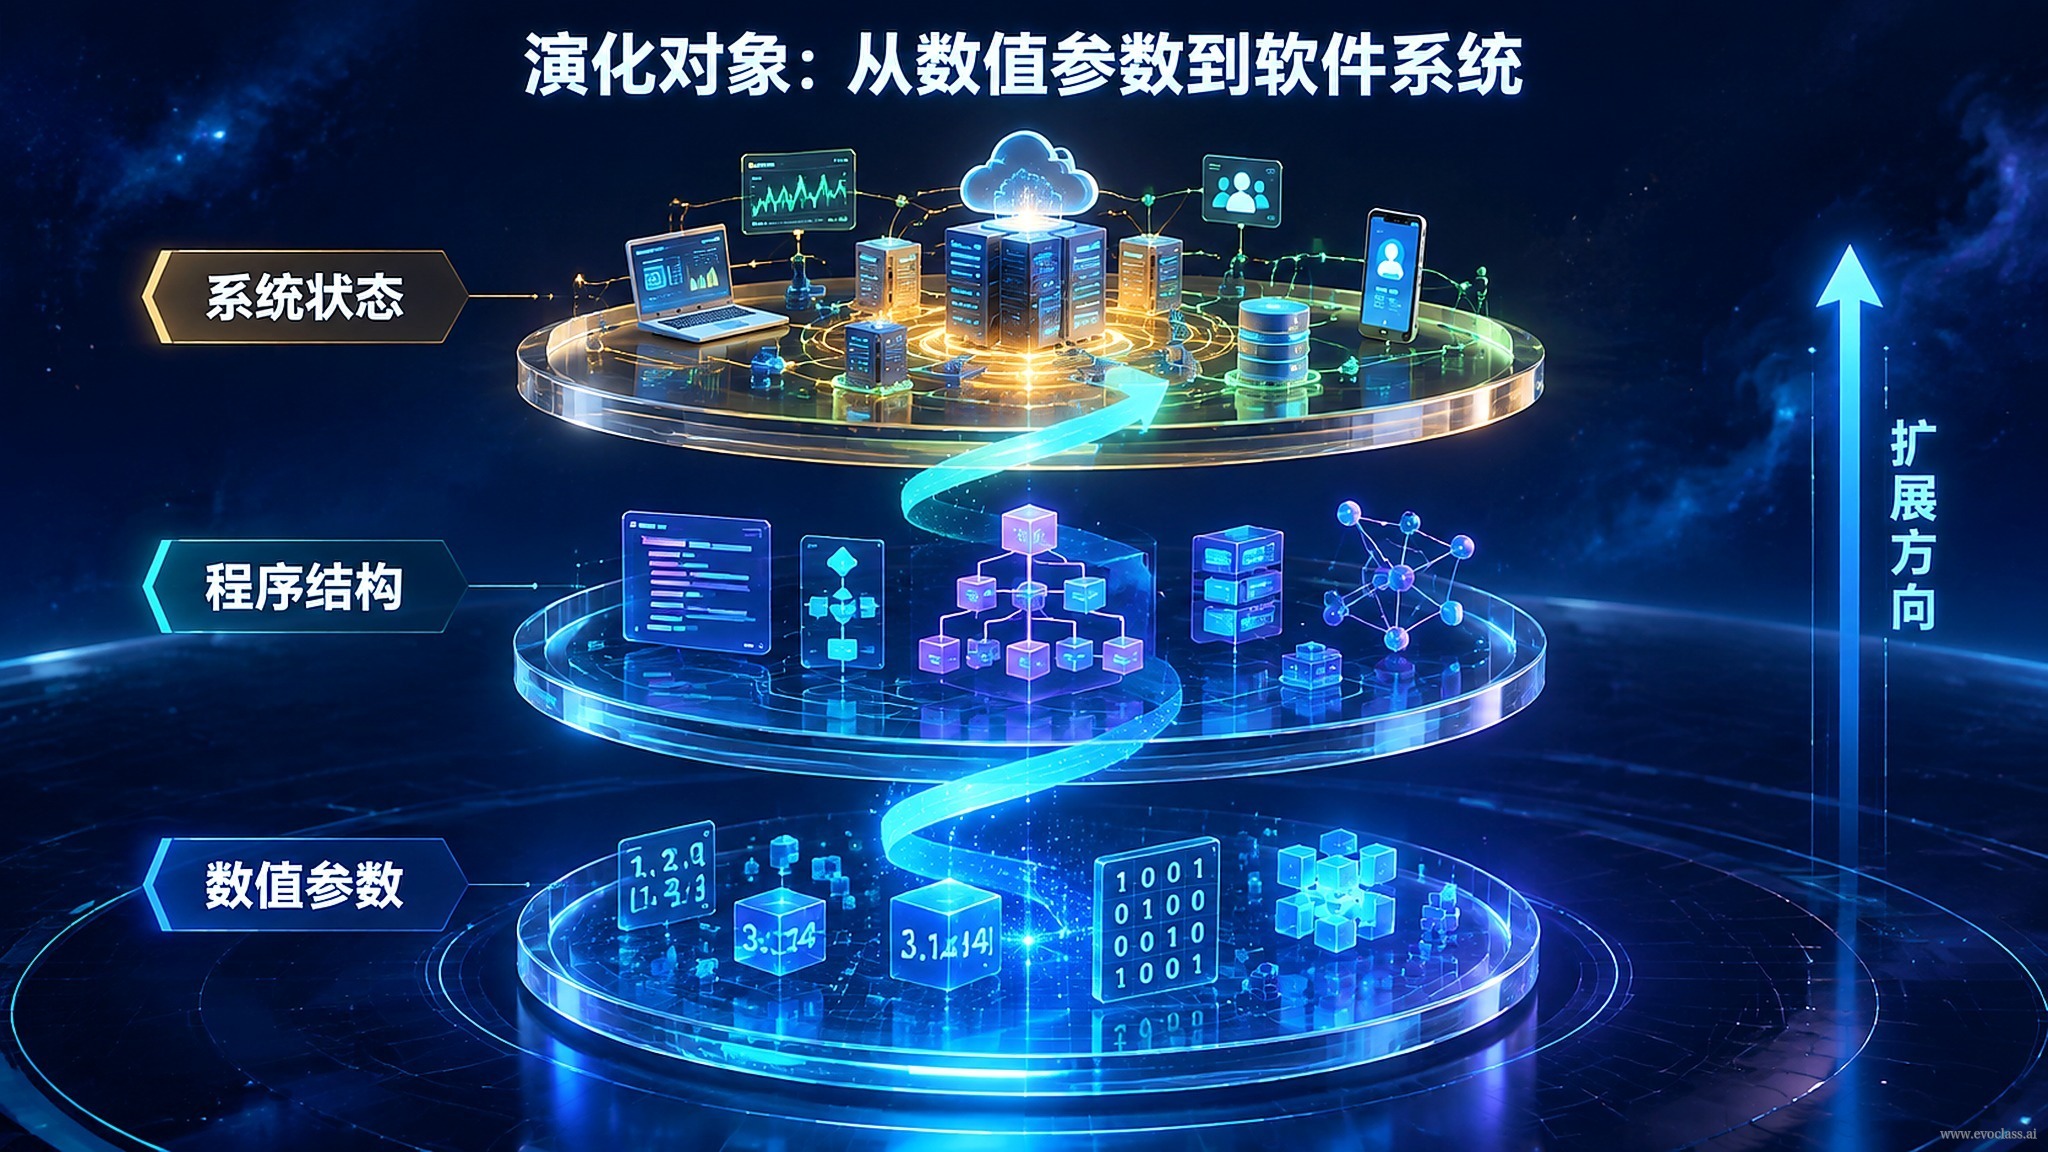
在演化計算的早期實踐中,被「演化」的對象幾乎都是數值參數——學習率、批次大小、正則強度、權重初始化方式。搜尋空間就是一組數字,評價方式就是一次訓練加一次驗證。隨著算力規模提升與大模型能力的成熟,可被演化的對象明顯擴展:程式、模型結構、演算法機制,乃至一整塊軟體工程狀態(配置、依賴版本、介面契約、部署與運行策略)。
這條擴展路徑可以用一條清晰的箭頭鏈表示:數值參數 → 程式與模型結構 → 軟體工程狀態與系統級候選。層級越靠右,表達力越強,能覆蓋的變化類型越多,系統級演化也因此成為可能。
三層演化對象,各自的代價不同
- 數值參數層:候選就是一組數字,生成便宜、評價快,但它只能回答「調得好不好」,無法補上一個本來就缺失的機制。
- 程式與模型結構層:候選是網路結構、算子組合、提示工作流或程式碼補丁,變化會改變「系統能做什麼」,而不只是「做得多準」。
- 軟體工程狀態層:候選是配置、依賴版本、介面契約與部署策略,直接決定系統能否穩定運行、能否被復現。
重心轉移:從「如何生成候選」到「如何執行與評價」
當候選從數字變成程式,「生成候選」這一步反而不再是瓶頸:大模型可以批量產出結構、機制與補丁。真正決定演化是否有效的,是執行與評價機制——誰能把候選真正跑起來,誰能在可接受的成本內判斷它是否值得保留。
表達力越強,評價負擔越重。一個數值參數只需一次訓練就能打分;而一個程式碼補丁需要沙箱隔離、回歸測試與基準對照,才能回答三個問題:它是否真的有效、是否帶來風險、結果能否復現。沙箱、回歸測試與基準正是用來約束成本、風險與可復現性的工程裝置,也讓變化可以被穩定地保留或淘汰。
工程權衡:候選變多不等於演化變好
在團隊實踐中,常見路徑是先調學習率與超參數,再逐步擴展到搜尋網路結構、算子組合、提示工作流或程式碼補丁。每擴展一層,都要同步回答:評價要花多少算力與時間?失敗的候選會不會污染現有系統?同樣的結果下次還能復現嗎?只有在表達力、評價成本、可復現性與安全性之間取得平衡,系統級演化才真正可行。
常見誤區
把「候選更多」直接等同於「演化更有效」。候選數量增加只擴大了搜尋範圍;只有當執行與評價機制足以篩掉無效變化時,更多的候選才會轉化為更好的系統。
演化對象的三層擴展圖中箭頭鏈從數值參數指向程式與模型結構,再指向軟體工程狀態與系統級候選:越往右可改變的對象越多、表達力越強。但代價同步上升,數值參數只需一次訓練打分,程式碼補丁則要沙箱隔離、回歸測試與基準對照才能判斷有效性、風險與可復現性。
演化對象的三層擴展
圖中箭頭鏈從數值參數指向程式與模型結構,再指向軟體工程狀態與系統級候選:越往右可改變的對象越多、表達力越強。但代價同步上升,數值參數只需一次訓練打分,程式碼補丁則要沙箱隔離、回歸測試與基準對照才能判斷有效性、風險與可復現性。