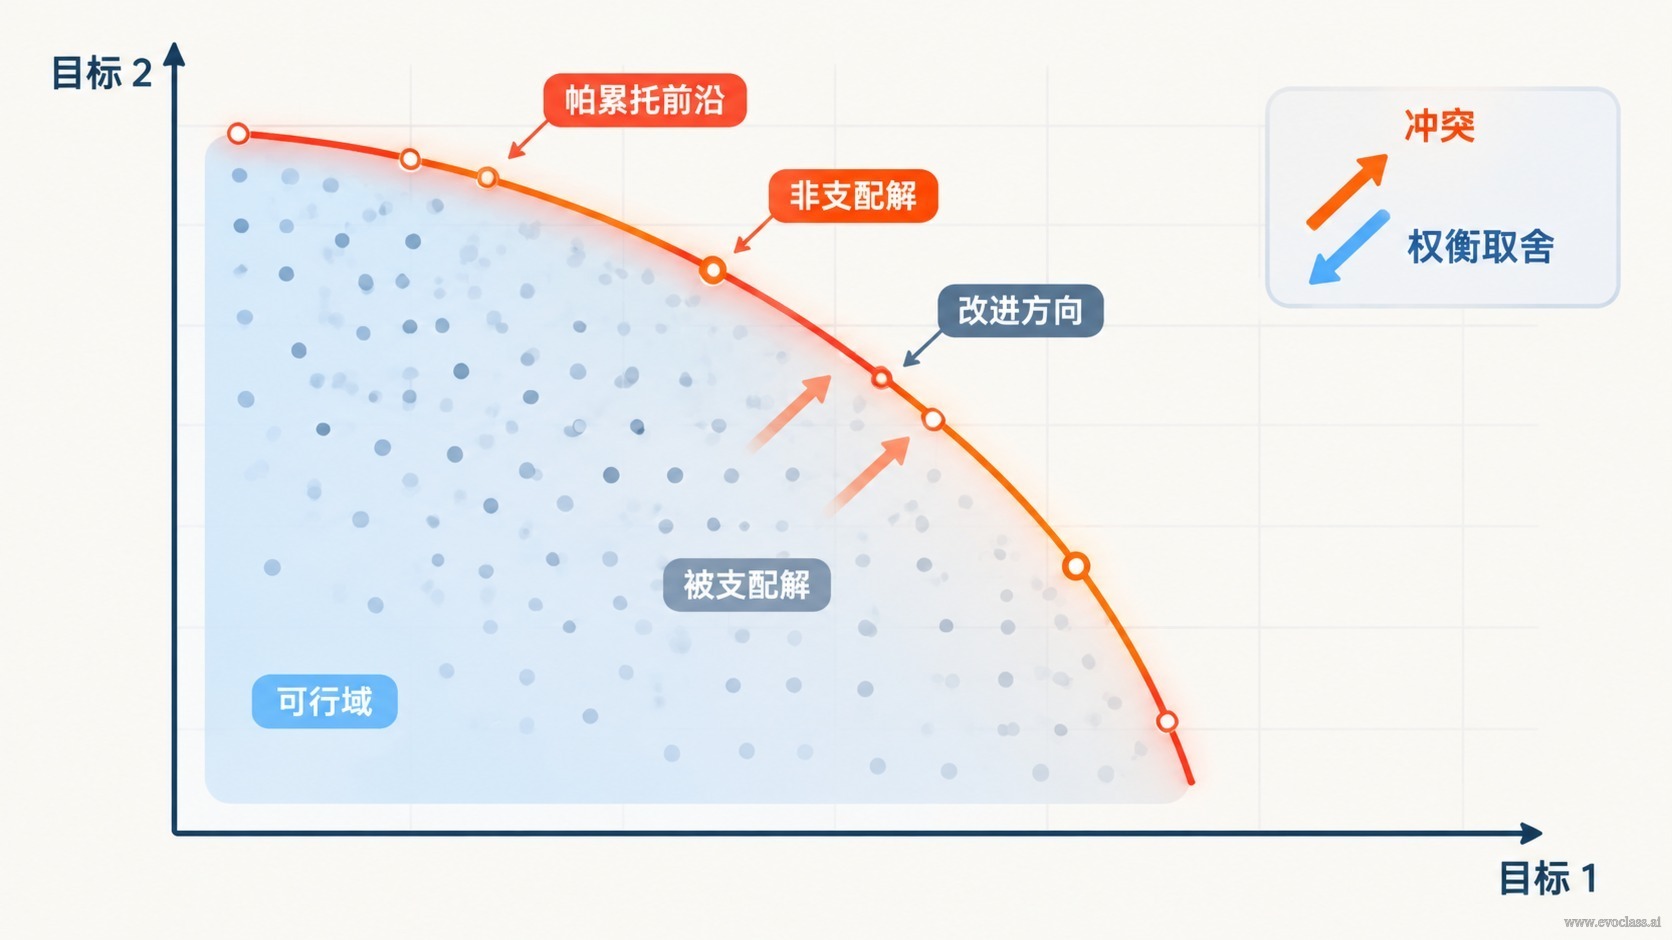
在真實世界的 AI 系統工程中,我們幾乎不會遇到只有一個目標的問題。提高模型精度往往增加推理時延與算力成本;增強魯棒性可能犧牲峰值效能;降低能耗又可能限制模型容量。這些目標相互牽制、不可完全公度,因而不存在唯一最佳解,只存在一組不可支配的權衡解——即逼近 Pareto 前沿。
核心概念
- 多目標牽制:一個目標改善往往導致另一個目標退化,目標之間不可完全公度。
- 約束複雜:硬約束與軟約束並存,疊加不確定性與動態環境,共同壓縮可行域,使單點最佳假設失效。
- 唯一最佳解通常不存在:單目標純量化或單點搜尋難以表達真實決策空間。
- 輸出應是方案組:需要保留多樣化候選,提供可比較的權衡邊界與偏好選擇空間。
- 演化計算優勢:透過種群並行探索與多樣性保持,同時逼近多個權衡解,適配衝突目標與複雜約束。
演化計算為何適合
演化計算不依賴目標函數的梯度或可微性,而是透過種群在目標空間中並行搜尋。種群中的每個個體代表一個候選方案,非支配排序與擁擠距離等機制在逼近 Pareto 前沿的同時維持解的多樣性。這樣,決策者可以在最後階段根據場景偏好,從前沿上選擇不同權衡方案,而不是在最佳化之前就鎖定一個先驗權重。
關鍵洞見
在多目標最佳化中,決策者的偏好往往在最後階段才介入。演化計算先逼近整個 Pareto 前沿,保留一組多樣化的非支配解,再讓決策者根據場景偏好選擇。這比先驗設定權重更穩健。
多目標最佳化 Pareto 前沿示意圖觀察圖中的多目標最佳化 Pareto 前沿示意圖,說說你觀察到的重點。
多目標最佳化 Pareto 前沿示意圖
觀察圖中的多目標最佳化 Pareto 前沿示意圖,說說你觀察到的重點。