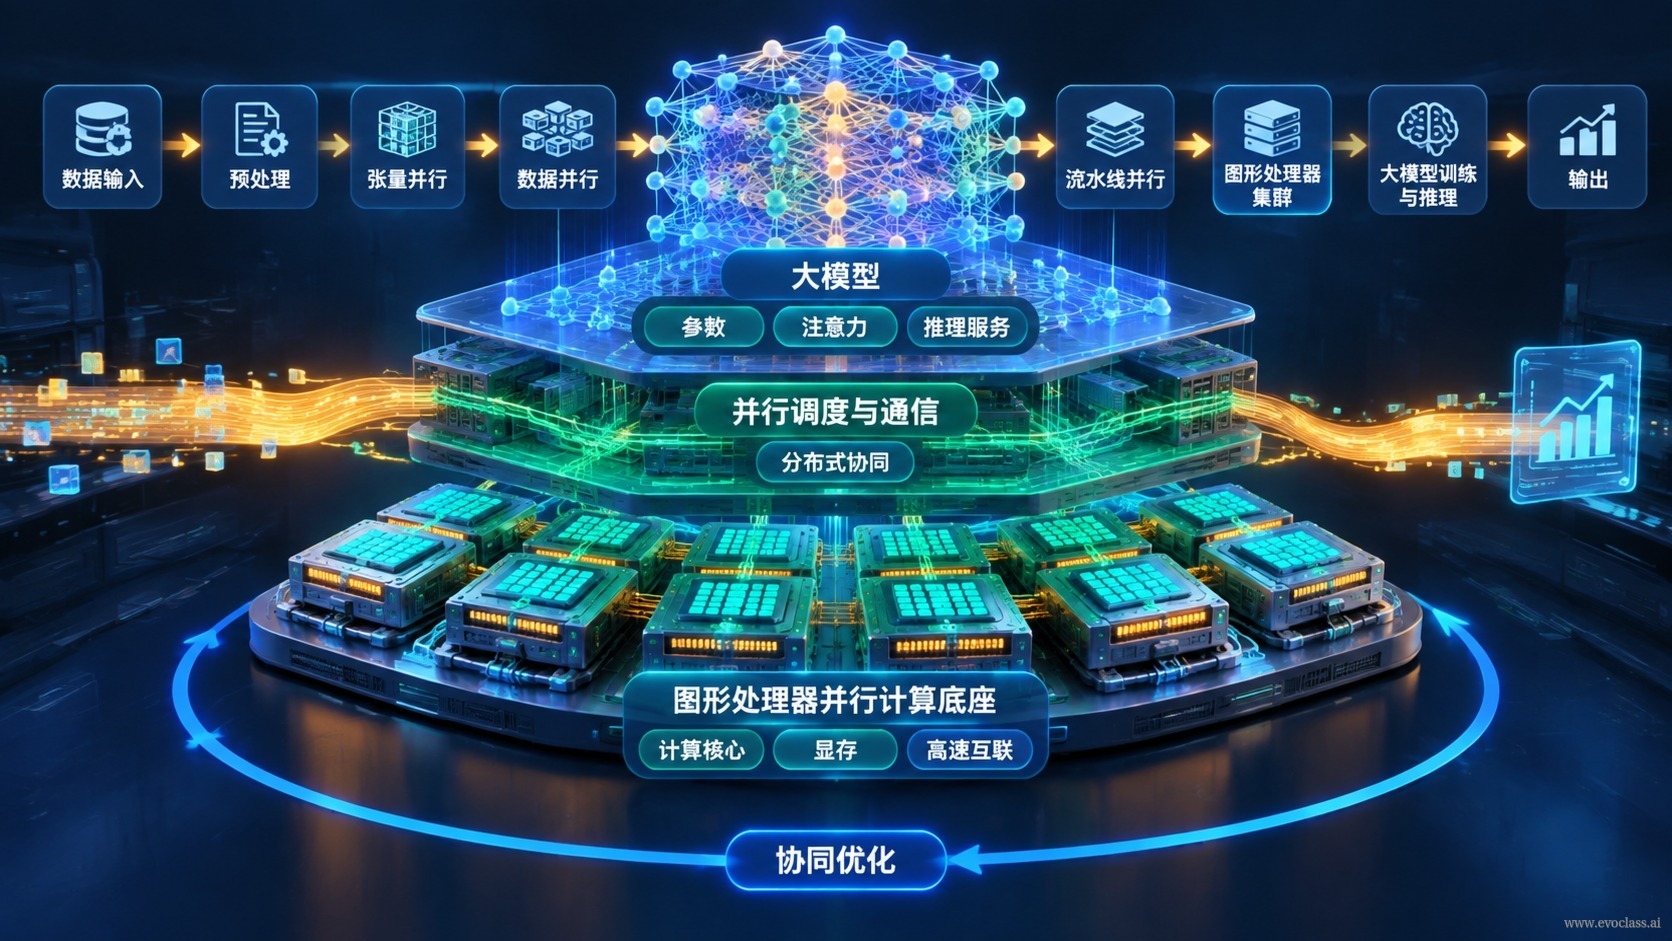
本頁討論 EvoX 之所以能夠展開大規模演化探索的工程底座:GPU 提供高強度並行算力,大模型 提供對自然語言、程式碼與專案脈絡的理解與生成能力。兩者疊加之後,計算規模被打開,候選解的來源、數量以及可作用的探索範圍都發生了根本變化。
算力打開了什麼:從串行小批量到大規模同時探索
在算力受限的條件下,評價一個候選解往往需要排隊等待,搜尋只能以小批量、串行的方式推進,「多試幾個」是一種奢侈。GPU 的並行能力把評價與搜尋推進到大規模同時進行:種群或大批候選解可以一次性送入並行評價,回饋幾乎同時回流。於是「同時嘗試大量可能」不再是特殊手段,而成為預設的工程能力。
- 吞吐:批量評價把單次迭代的等待時間壓縮到可接受範圍,使演化循環能夠高頻運轉,而不是被評價環節拖慢。
- 規模:可同時探索的候選數量上升,搜尋能夠覆蓋的假設空間隨之擴大,探索邊界從「少量試錯」變為「成批鋪開」。
候選解的來源發生了什麼變化
計算規模打開之後,候選來源從「人工設計 + 少量取樣」轉向混合模式:並行計算批量供給 與 大模型生成與改寫 共同產出候選。大模型能夠理解自然語言、程式碼與專案脈絡,可以把研究意圖更快地轉化為可執行的候選、腳本或算子草案,並保持與專案語境的銜接;GPU 側則負責把這些草案批量驗證,把結果回饋回搜尋過程。兩者一前一後,恰好覆蓋了「生成」與「驗證」兩頭。
底座不替代演化演算法
需要明確的是,這一層是底座而不是演算法本體。它承擔的是吞吐、語意入口 與 脈絡銜接;搜尋、選擇與回饋閉環仍然由演化演算法負責。把分工劃清楚,在實踐中才有判斷力:當一個系統效果不佳時,需要先判斷缺的究竟是算力吞吐、是語意入口,還是閉環機制本身。
在同一條工程脈絡上,底座還需要支撐 多 Agent 協作與遞迴任務拆解 這類工程模式:一個複雜目標被拆成若干子任務,由不同 Agent 分別認領與推進。而要讓這些子任務彼此不脫節,就需要專案級持久化——把目標、約束、中間產物與評價結果沉澱在專案層面,使其能夠跨越 Agent 脈絡 延續。否則每更換一個 Agent,脈絡就要重新對齊,遞迴拆解會退化為互不相干的一次性呼叫。
概念澄清
算力與模型擴大了探索邊界,但並不自動帶來正確性。候選再多,也需要環境回饋與評價選擇把它們篩成可持續累積的能力。本頁只定位到「工程底座」這一層,先把算力與模型如何擴大探索邊界說清楚;Runtime 的組織方式、演化對象的邊界劃分等實作細節,留到後續展開。
GPU 並行與大模型協同工作的架構圖觀察圖中的 GPU 並行與大模型協同工作的架構圖,想一想它和「大模型能夠理解自然語言、程式碼和專案脈絡」有什麼關係。
GPU 並行與大模型協同工作的架構圖
觀察圖中的 GPU 並行與大模型協同工作的架構圖,想一想它和「大模型能夠理解自然語言、程式碼和專案脈絡」有什麼關係。