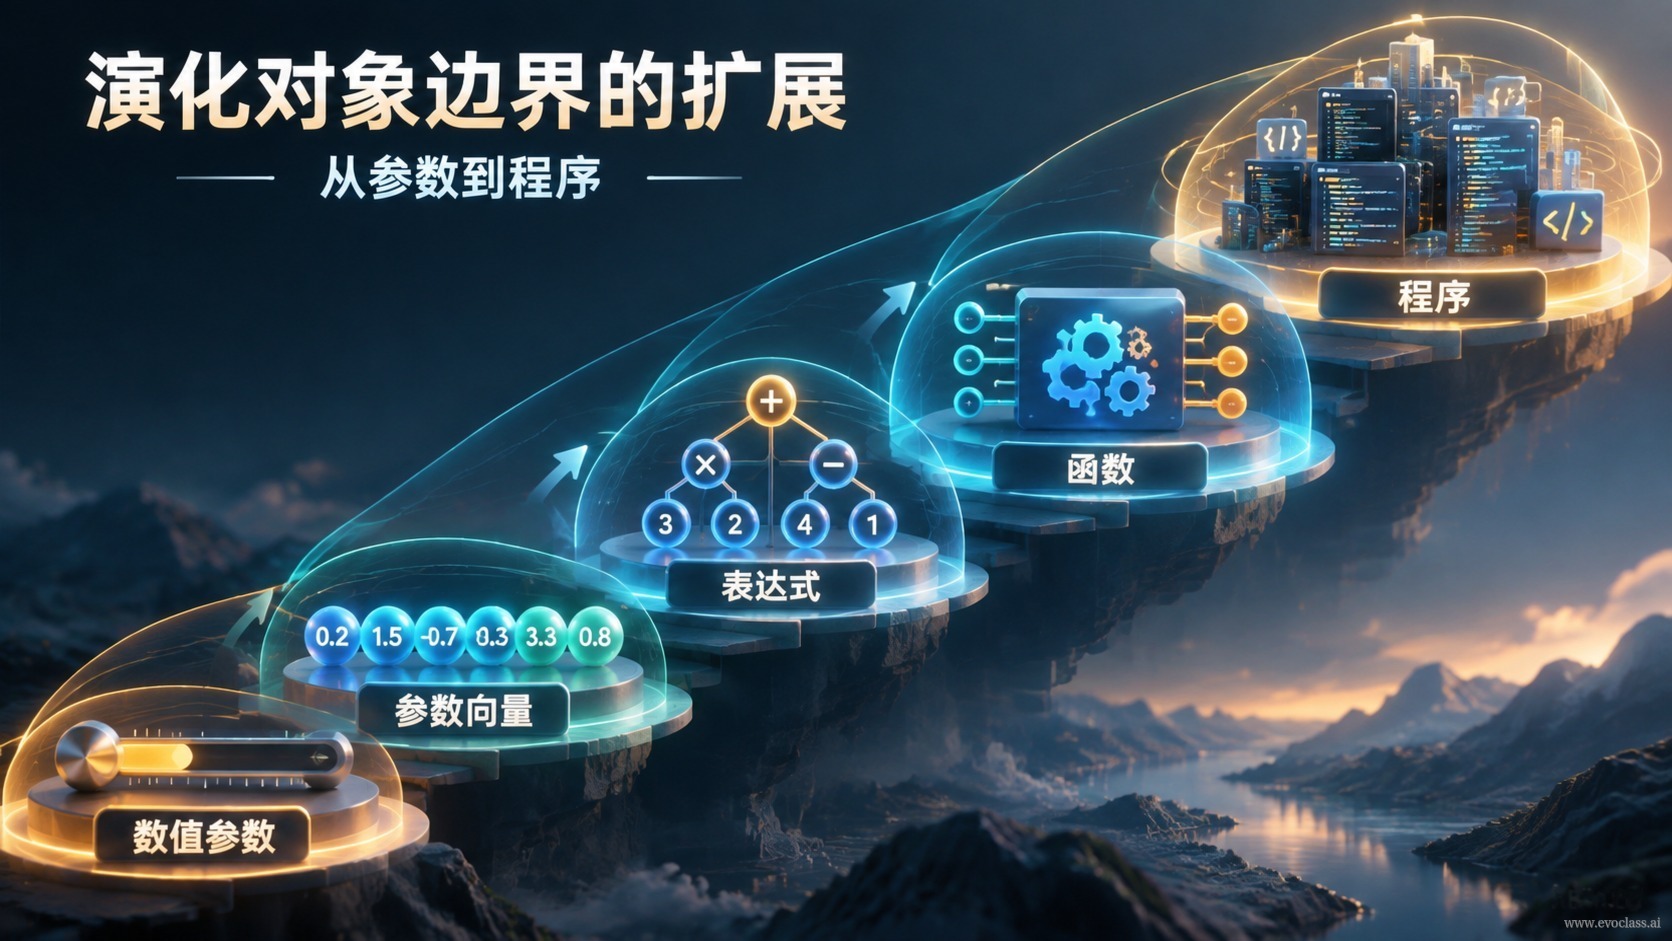
演化對象指的是演化系統中真正被編碼、變異、評價與選擇的那一部分內容。經典演化演算法預設這個對象只是一組數值參數;而在 GPU 與大模型共同構成的現代底座上,這條邊界正在向外推開:從數值參數,到超參數與模型結構,再到演算法機制與算子,最終到程式與持續存在的軟體工程狀態。
理解這條階梯的關鍵,是同時抓住三件事:對象如何表示、受什麼約束、用什麼訊號評價。對象每上升一層,這三件事都會同步改變。
- 數值參數層:對象是連續實向量 θ \in \mathbb{R}^d,例如學習率、權重或差分演化的變異因子。約束主要是取值範圍,評價通常是一個純量目標 f(θ)。
- 超參數與模型結構層:對象含有離散選擇,如層數、寬度、連接方式與資料增強策略。搜尋空間變成混合型並迅速組合膨脹,評價必須額外關注泛化能力與過擬合。
- 演算法機制與算子層:對象本身就是要執行的機制,例如差分演化的變異策略、粒子群中慣性係數的組合方式、損失函數的具體形式。候選必須滿足語法與語義約束,評價從「誰的分數更高」轉向穩健性、穩定性與多目標權衡。
- 程式與工程狀態層:對象成為訓練腳本、流水線配置、相依關係與專案狀態。候選只有通過編譯、測試與驗收才被視為有效,評價升級為系統級回饋:精度提升多少、資源開銷是否可接受、結果能否重現。
為什麼邊界會向外擴展
兩股力量共同推動。其一,算力規模打開了平行探索的可能:過去圍繞單一候選編寫的串行迴圈,被張量化與批次平行取代,整個種群可以一次生成、一次評價。其二,大模型能夠理解自然語言、程式碼與領域上下文,使系統可以建構結構複雜的候選——過去必須人工設計的編碼與變異方式,如今可以由模型參與生成。
當「產生候選的方法」本身也能被表達和被評價時,一個自然的問題就出現了:既然候選解可以被演化,那麼產生候選解的方法是否也可以成為演化對象?這正是從「最佳化解」走向「最佳化演算法本身」的那一級階梯。
評價訊號必須隨對象一起升級
在參數層,單一純量目標足以驅動搜尋,例如 \min f(θ)。到了程式層,沒有任何一個純量能概括「這段程式碼是否值得保留」:評價變成帶約束的多目標權衡,需要同時考慮精度 f1、評估成本 f2 與穩定性 f3,並在約束 C(x) ≤ 0 下尋找一組互不支配的候選。工程上常用的判斷清單包括:編譯是否通過、測試是否覆蓋、基準是否提升、資源開銷是否可接受、結果能否重現。
常見誤解:擴展不等於隨意生成
把對象邊界向外推,並不意味著可以任意生成程式碼。對象越自由,約束並不會消失,只是從「取值範圍」轉移到「語法、介面與可執行性」;驗證責任也不是減輕,而是加重。放開腳本級演化的團隊通常會先撞上兩個現實問題:搜尋空間急劇膨脹,以及大量「能跑通但無收益」的候選吃掉評估預算。
因此更穩妥的做法是分層放開:逐層擴大允許改變的範圍,先用低成本篩選或代理模型排除明顯無效的候選,再把高保真評估留給少數有希望的方案,並在精度與開銷之間顯式取捨。
演化對象從數值參數向複雜程式碼結構演進的層級圖觀察圖中的演化對象從數值參數向複雜程式碼結構演進的層級圖,想一想它和「演化的對象從參數擴展到程式模型結構演算法機制和軟體工程狀態」有什麼關係。