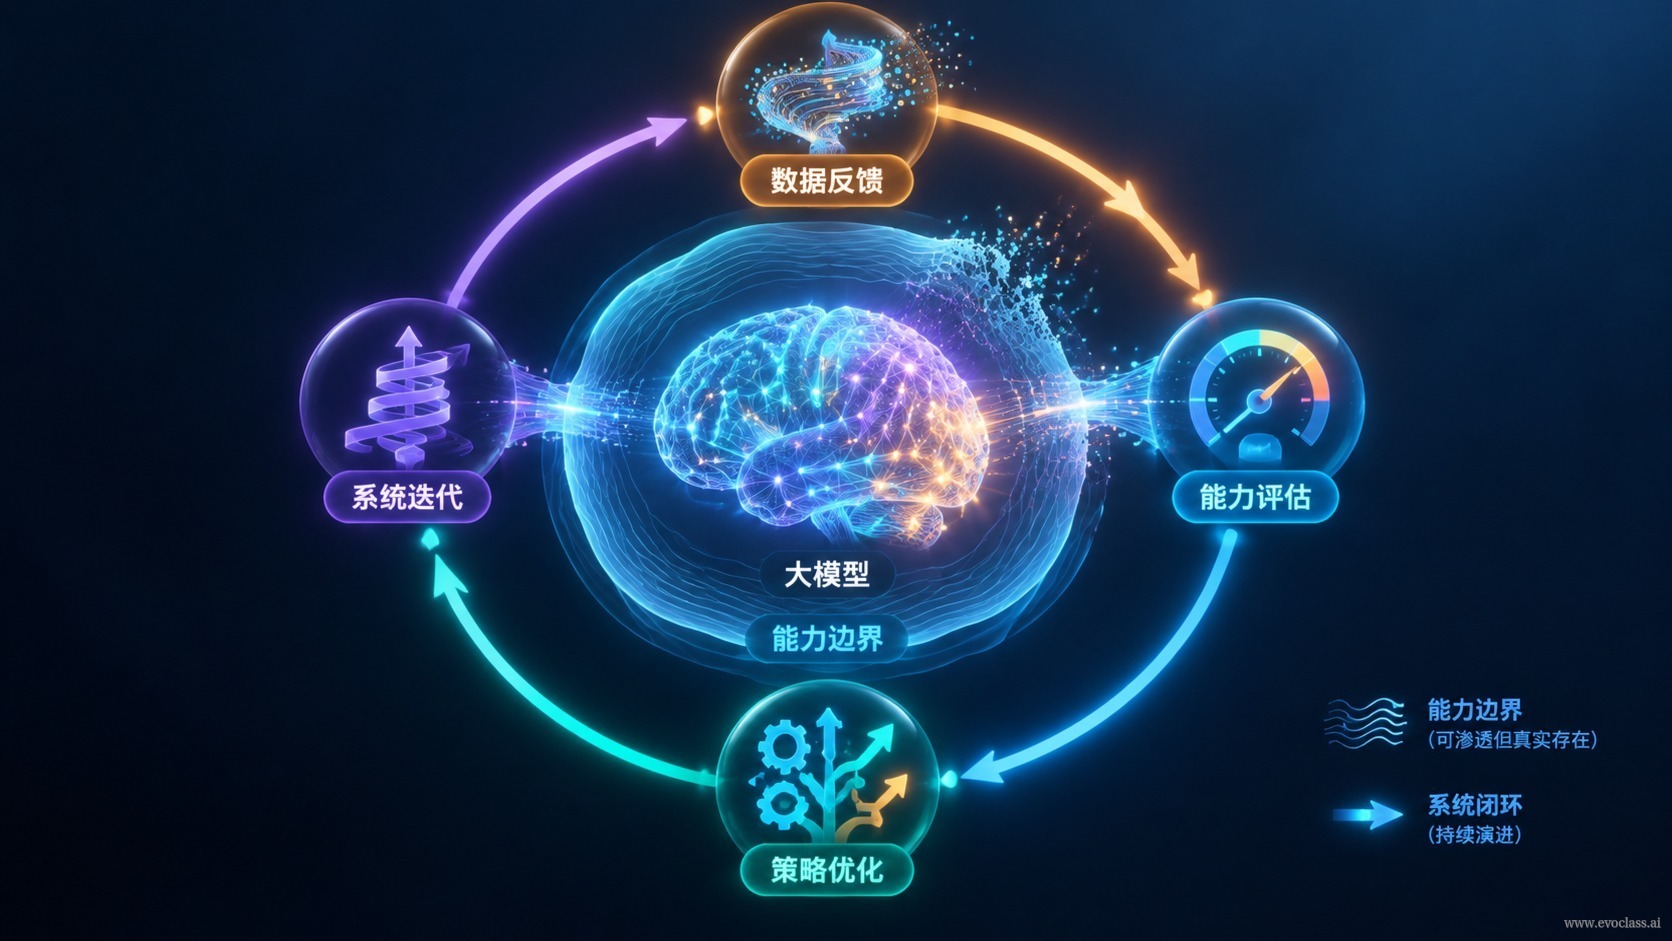
大模型已經把自己變成了可靠的能力基座:語意理解、程式碼與方案生成、多步推理、工具與函式呼叫——它足以支撐「提出問題即產出候選」的互動形態。但基座越強,越容易掩蓋一個工程事實:模型負責生成可能性,閉環必須由系統承擔。本頁要論證的正是這條能力邊界,以及為什麼持續演化是一項系統級責任,而不是模型能力的自然延伸。
一、模型側已經勝任的部分
- 語意理解:把模糊需求解析成可執行的問題描述,並識別其中隱含的約束與目標。
- 生成能力:在數分鐘內產出程式碼、配置、方案與解釋,並能在同一輪對話內自我修訂。
- 多步推理:完成任務分解、鏈式推導與取捨說明,天然具備「提出候選並解釋理由」的輸出形態。
- 工具呼叫:透過函式呼叫觸發檢索、計算與外部介面,把語言輸出接到真實動作上。
這四點合起來意味著「候選的產生」已經近乎免費。真正稀缺的資源不是候選的數量,而是對候選施加選擇壓力的機制。
二、結構性缺口:單次會話無法閉環
- 會話內狀態易失:上下文一旦耗盡,跨任務的記憶隨之斷裂,上一輪學到的教訓無法自動進入下一輪。
- 真值缺位:模型無法自主定義「什麼算對」,也無法給出獨立於自身輸出的評價標準。
- 實驗調度缺位:批次基準測試、統計顯著性檢驗、約束合規判定,以及高成本真實環境的執行,都不在模型的控制範圍內。
結論很清晰:模型無法在單次會話或單次任務內獨立完成候選產生—環境檢驗—結果沉澱的閉環。這不是能力不夠,而是職責本來就不在模型身上。
三、系統側必須補位的四類工作
- 候選的產生與變異:組織模型輸出,主動擴大並結構化搜尋空間。
- 環境的建構與呼叫:搭建可重複執行的實驗環境,負責調度、執行與驗收。
- 評價與篩選:定義真值與評價器,完成排序、篩選與顯著性判斷。
- 沉澱與複用:把成功結果與失敗經驗寫入長期記憶,成為下一次任務的起點。
分工原則只有一句:模型負責生成可能性,系統負責施加選擇壓力並保留歷史。二者不可互相替代——沒有模型,系統就沒有可篩選的多樣性;沒有系統,模型只能一次次歸零。
四、判準轉換:從「單次輸出多好」到「改進能否累積」
衡量一個系統是否真正在演化,標準不應是「單次輸出有多好」,而應是「改進能否跨任務、跨 Agent 週期累積」。一次驚豔但無法被繼承的輸出,本質上仍是一次性消耗。當每一次任務的產出都被固化為可複用的工程資產——程式碼、配置、評價器、失敗案例集——後續任務的起點就高於前一次,這就是專案級持續演化。EvoX 的實踐給出了一個穩定可靠的工程沉澱範式:跨越 Agent 與任務週期,把經驗固化為資產,而不是留在對話記錄裡。
關鍵決策點:邊界問題的根因是架構缺位
當我們遇到「改進無法累積」的問題時,第一反應常常是「換一個更強的模型」。但邊界問題的根因通常是架構缺位,而不是模型不夠強。正確動作是補系統,而不是換模型。可以自檢:把同一任務交給能力更強的模型,是否就能自動獲得跨任務記憶、真值判定與實驗調度?如果不能,問題就不在模型側。
最後劃一條與相鄰主題的界線:本頁只論證「為什麼需要系統級持續演化」,不展開演算法自身的雙層演化機制(見後續 MetaDE 相關內容)。
AI 模型能力與系統級閉環組織關係圖觀察圖中的 AI 模型能力與系統級閉環組織關係圖,說說你觀察到的重點。
AI 模型能力與系統級閉環組織關係圖
觀察圖中的 AI 模型能力與系統級閉環組織關係圖,說說你觀察到的重點。