本頁透過課堂實操,圍繞同一個工程優化問題,對比預設單一路徑與演化多路徑在未知擾動下的表現。核心不是證明演化永遠更優,而是分析多路徑如何把不確定性、多樣性與線上回饋納入搜尋過程,從而提升魯棒性與適應性。
實驗任務定義
- 選擇一個可注入未知擾動的工程優化問題,如動態參數優化或帶雜訊限制的搜尋任務。
- 固定目標函數、評價預算與擾動序列,確保兩組實驗可比。
預設單路徑:離線假設下的剛性求解
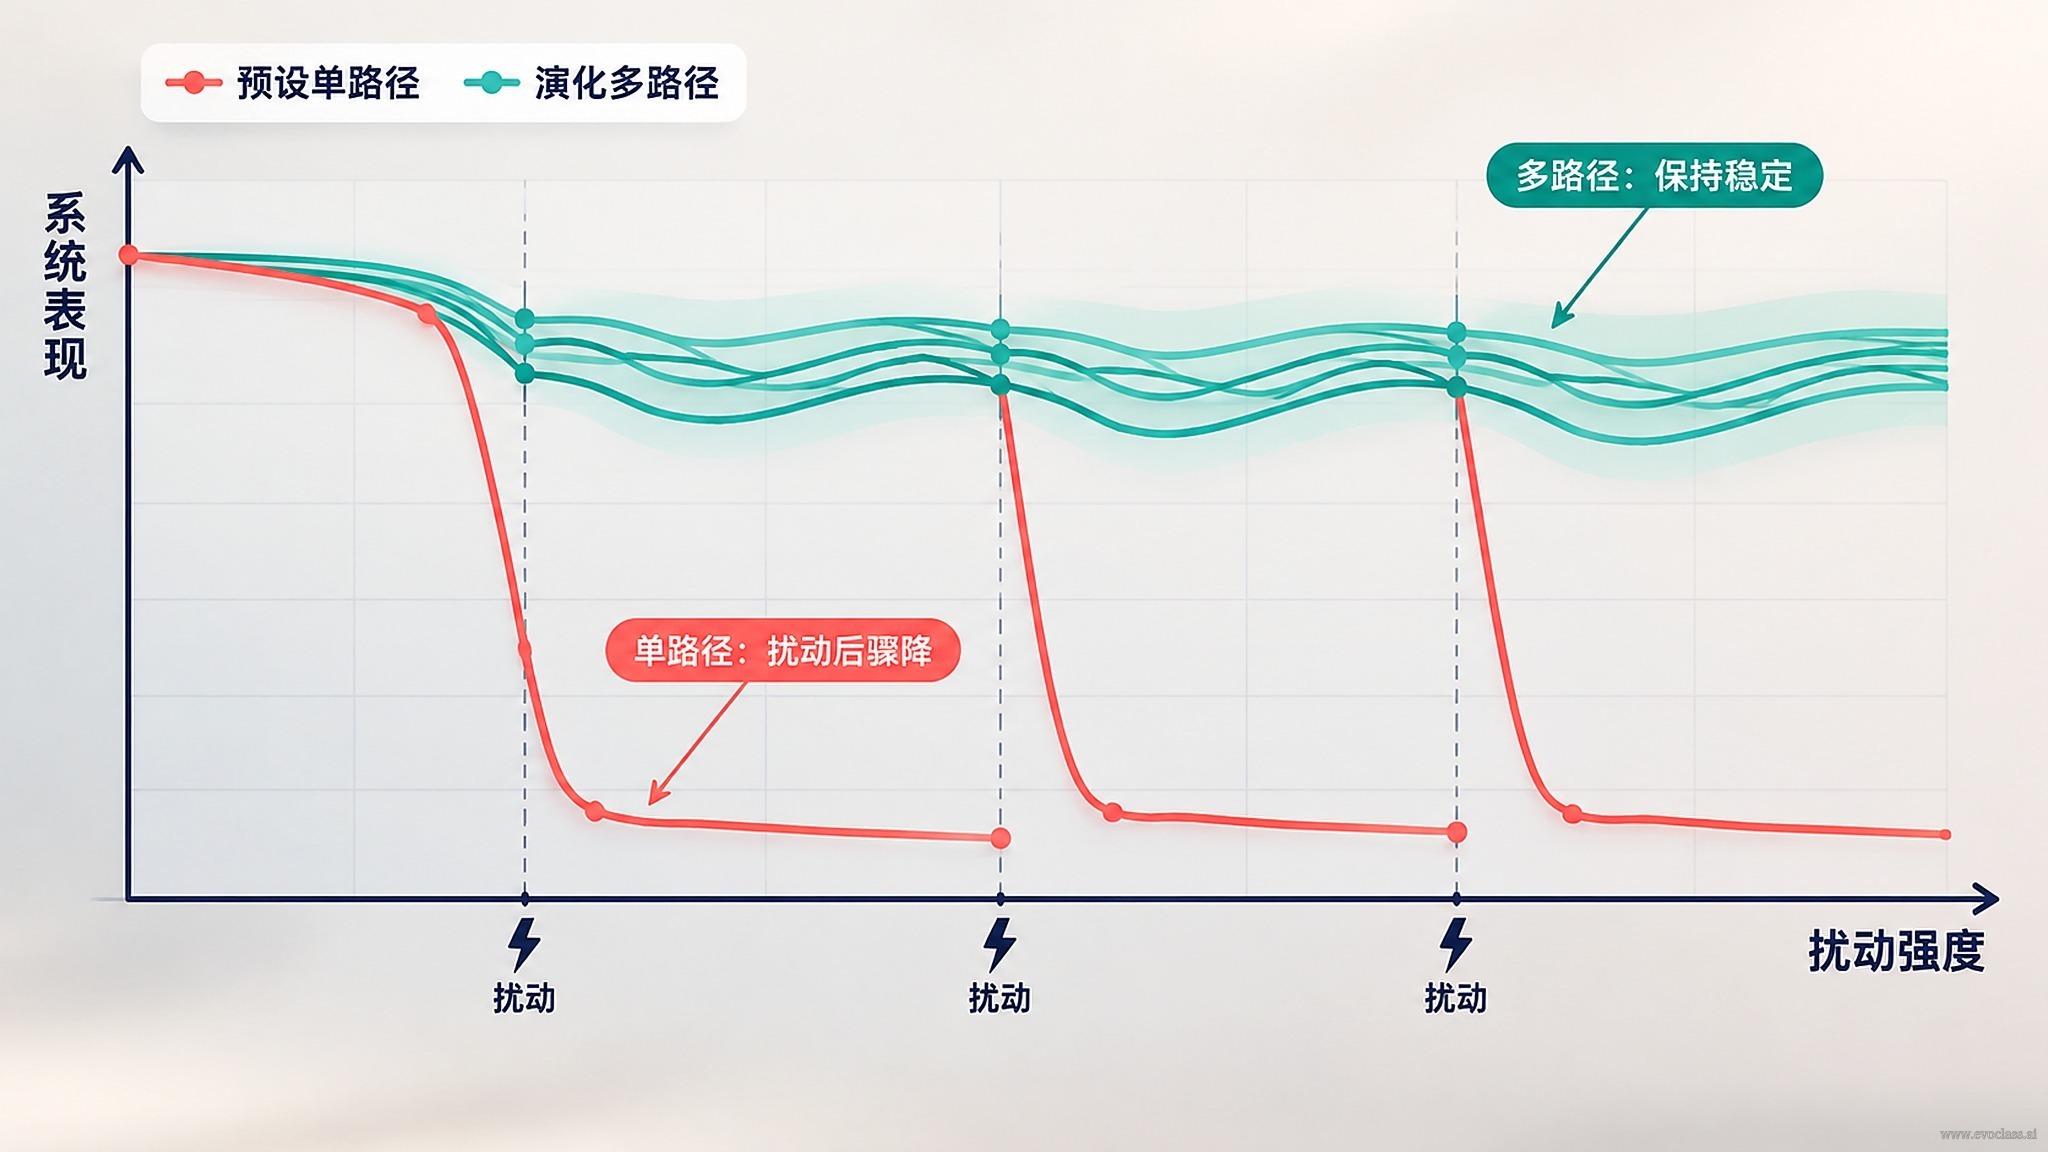
固定演算法、超參與搜尋方向,按離線假設一次性求解。擾動前可能表現良好,但缺乏線上調整,擾動後易陷入局部最優或效能驟降。
演化多路徑:線上回饋驅動的平行探索
在 EvoX 中以種群、多策略或多候選平行搜尋,透過變異、交叉、選擇和環境回饋持續調整。多路徑不是簡單重複執行,而是利用線上資訊形成探索冗餘。
下圖給出兩類策略在擾動前後的效能保持率變化,圖中標註了擾動注入點、效能下降幅度、恢復窗口與多路徑候選多樣性範圍,可直接與下文指標對照分析。
擾動設計與對比指標
- 擾動設計:目標偏移、限制變化、雜訊增強、環境狀態切換或未建模變數;重點觀察預設階段未見過的擾動。
- 對比指標:擾動前最優值、擾動後效能下降幅度、恢復速度、成功率、候選多樣性、達到同等效能的計算與評估成本。
關鍵解釋與結論
單路徑的脆弱性來自假設固化與多樣性不足;多路徑的優勢來自持續探索、適應度回饋與選擇壓力,但必須權衡計算成本、收斂穩定性與工程可解釋性。
在面對未知擾動時,演化多路徑通常展現出更強的魯棒性與適應性;但結論應建立在公平預算、可複現實驗和擾動邊界清晰的基礎上,避免把「多路徑」誤讀為無條件優於單路徑。
公平對比原則
確保兩組實驗使用相同的目標函數、評價預算和擾動序列,並多次重複取平均,否則結論可能被初始條件或隨機波動誤導。
單路徑應對擾動 vs 多路徑演化抗干擾能力對比折線圖觀察圖中的單路徑應對擾動 vs 多路徑演化抗干擾能力對比折線圖,想一想它和「對比採用演化多路徑在應對未知擾動時的魯棒性與適應性」有什麼關係。
單路徑應對擾動 vs 多路徑演化抗干擾能力對比折線圖
觀察圖中的單路徑應對擾動 vs 多路徑演化抗干擾能力對比折線圖,想一想它和「對比採用演化多路徑在應對未知擾動時的魯棒性與適應性」有什麼關係。