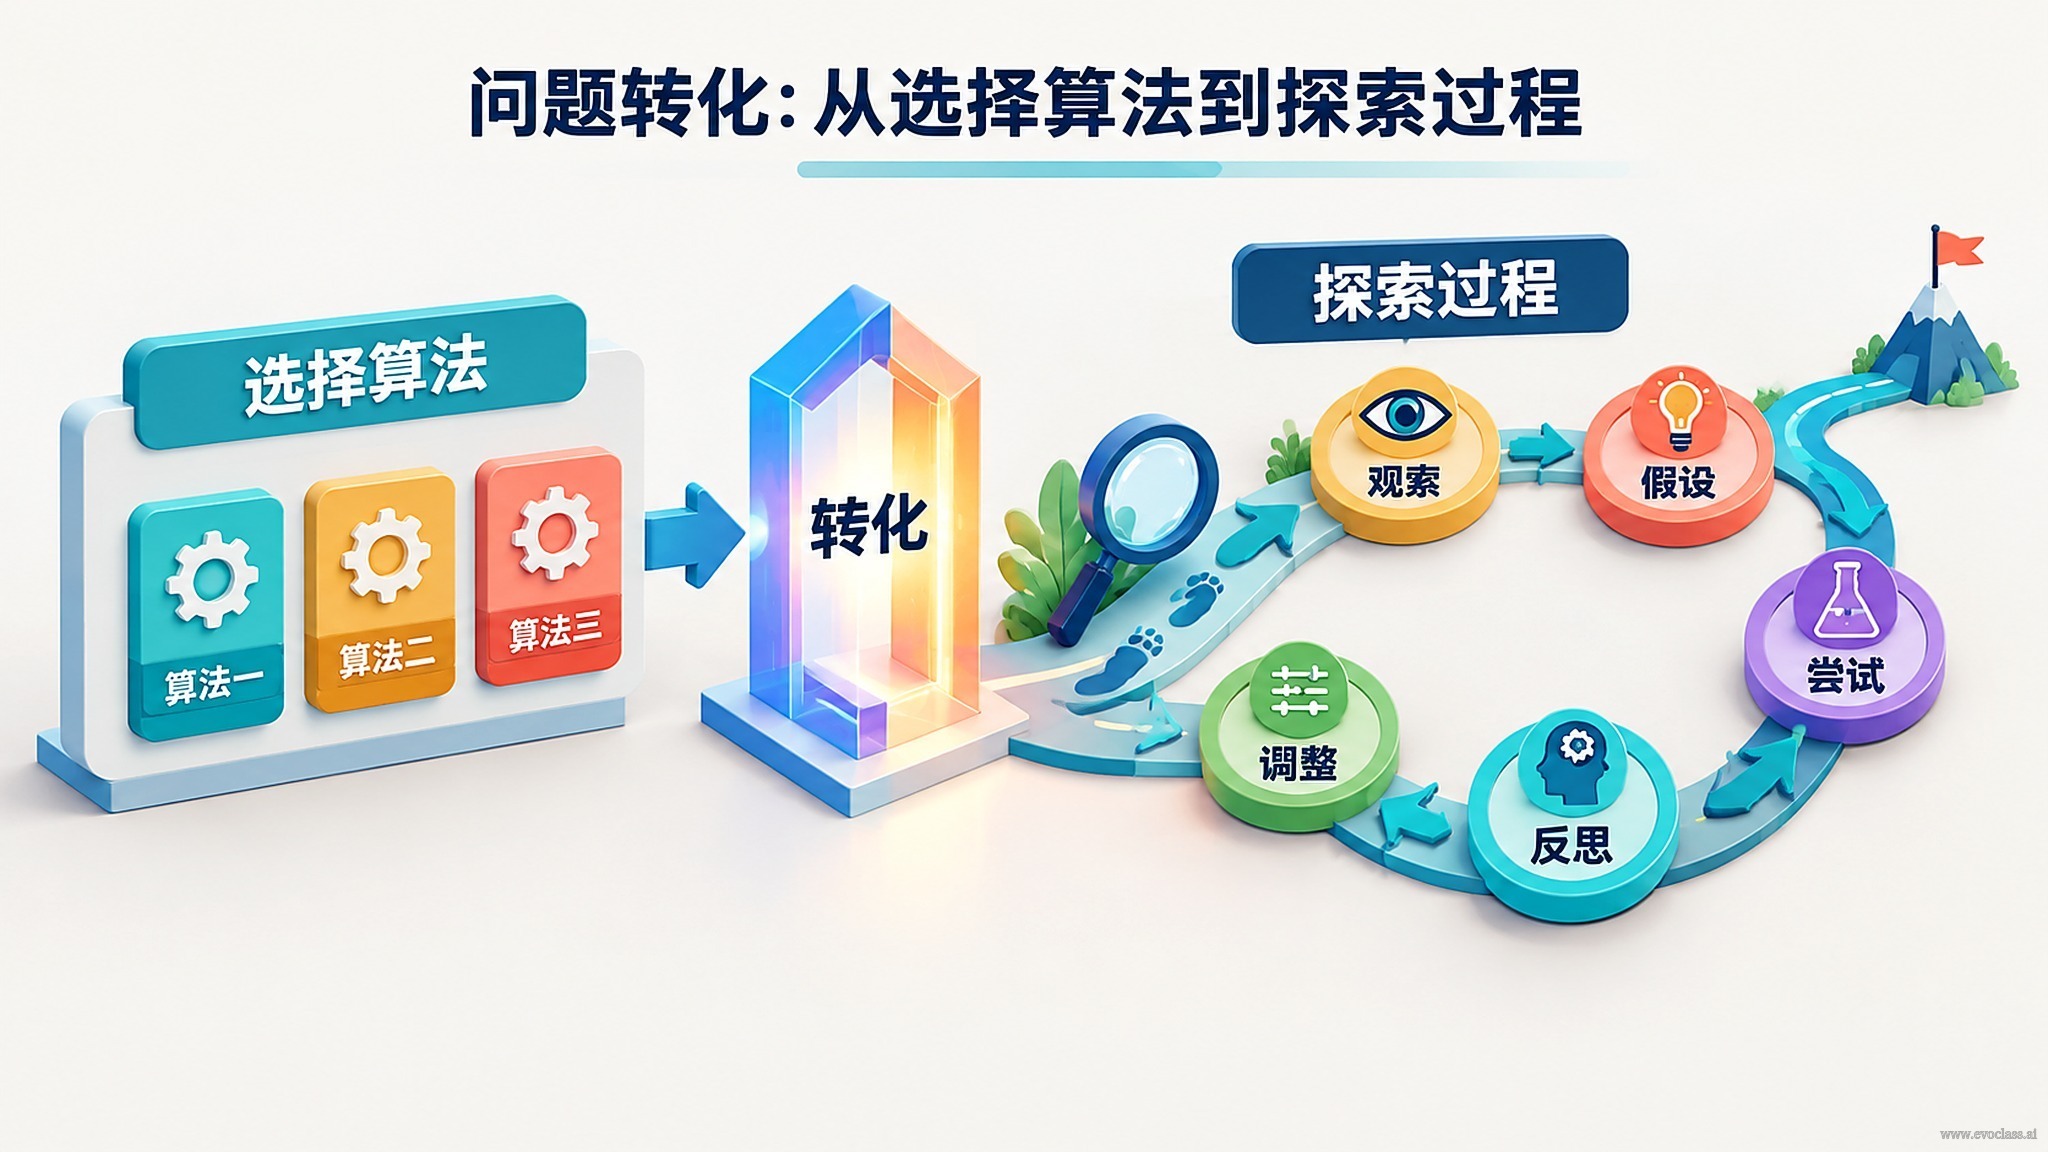
在演化計算的實際應用中,一個常見的起點錯誤是——拿到任務先問「我該用 DE 還是 PSO」。這句話把演算法選型放在了求解的入口,但它只回答了「用什麼工具去搜尋」,並沒有回答「要搜尋什麼、什麼算好、什麼絕對不能違反」。而真正決定成敗的,是問題定義的品質。
所謂問題轉化,就是把「選擇哪個演算法」改寫成「設計一個可探索的過程」:先明確真實問題中什麼可以改變、改變之後如何評價、哪些限制必須滿足,再讓演算法在這個搜尋空間裡迭代地生成與篩選候選。演算法選擇由此成為探索過程設計中的一環,而不是它的起點。
四個必須先落地的定義
- 可變對象:界定哪些參數、結構、策略或流程允許被調整,由此形成搜尋空間與編碼邊界。沒有它,候選解無法被表示,也無從生成。
- 評價方法:定義改變之後如何判斷優劣,包括目標函數、評價指標、偏好方向,以及可行性與多樣性等度量。評價方式實質上決定了搜尋會朝哪個方向走。
- 核心限制:區分必須滿足的硬限制與可權衡的軟偏好。把硬限制混進目標函數裡「打個折」,很容易產出看似得分很高、卻根本無法部署的方案。
- 探索過程:把問題形式化為「候選生成—評價—回饋—再生成」的閉環,讓評價結果反過來影響後續生成,而不是一次性定死求解思路。
轉換帶來的差別
面對一個參數優化任務,習慣性做法是「先選一個演算法——比如 DE 或 PSO——然後開始調參」。轉化之後的做法是依次回答三個問題:哪些參數可調?用什麼指標(或哪幾個相互衝突的指標)來評價?哪些限制絕對不能違反?回答完這三個問題,任務就已經被形式化為一個可接入演化求解器的多目標問題;此時再決定用哪種演算法、以什麼算子配置去探索,只是在閉環內部做一個可替換的工程決定。換言之,演算法不是答案本身,它只是探索過程中可配置的一環,問題定義的品質才決定探索的上限。
常見誤區
把「演算法效果不好」直接歸因於演算法本身,卻忽略了三件更根本的事:搜尋空間定義含糊、評價指標與真實業務目標脫節、硬限制缺失。先修問題定義,再談演算法替換,往往比反覆換演算法更有效。
問題轉化流程圖中把求解任務從「先選DE還是PSO」改寫為可探索流程:先界定可變對象、評價方法、核心限制,再讓候選生成、評價、回饋與再生成形成閉環。演算法選擇因此只是閉環內可替換的一環,問題定義品質才決定探索上限。
問題轉化流程
圖中把求解任務從「先選DE還是PSO」改寫為可探索流程:先界定可變對象、評價方法、核心限制,再讓候選生成、評價、回饋與再生成形成閉環。演算法選擇因此只是閉環內可替換的一環,問題定義品質才決定探索上限。