在多目標演化中,偏好優化把決策者的偏好作為搜尋與篩選的引導訊號,而不是等搜尋結束之後再做一次性評分。它帶來兩個結構性改變:一是不提前把多個目標壓縮成單一純量分數;二是不只交出一個「最佳解」,而是輸出一組在權衡結構上彼此有差異的候選方案,把最終取捨權保留給領域專家。
為什麼需要候選方案組
多目標問題中並不存在天然唯一的「最佳解」。當目標彼此衝突時,一個解在某個目標上的改善往往要以另一個目標的惡化為代價,因此可比較的解會連成一條理想權衡前沿。如果提前用一個加權和把目標合併,等同於在尚不清楚真實偏好的情況下,替決策者選定了一個隱含的折衷點;一旦現實限制或偏好發生變化,這個解可能立刻失去價值。偏好優化要做的,是把「人希望往哪個方向看」編碼進搜尋過程,讓搜尋資源集中在真正被關心的區域。
偏好如何進入搜尋
- 參考點:給出一個理想的目標取值組合,引導族群向該方向逼近。
- 目標優先順序:聲明哪個目標更不能被犧牲,用於非支配排序或淘汰判斷。
- 權重區間:不是固定權重,而是一段可接受的權重範圍,允許多種折衷同時成立。
- 互動式回饋:由專家在多輪迭代中逐步給出偏好,搜尋隨之收窄。
這些形式的功能是一致的:收窄關注區域、提高搜尋效率,而不是提前把整個解空間坍縮成一個點。
候選方案組的核心:差異性保留
候選方案組的價值不在於「數量多」,而在於組內方案在目標權衡上分布分散:偏保守端、偏激進端與折衷段各有代表,涵蓋不同的折衷模式。如果只是在同一個解附近給出若干微擾副本,它們無法支撐任何有意義的取捨判斷。
差異性也不會自然維持。演化過程若沒有機制干預,會自發向當前最佳區域收斂,候選組最終退化為單一答案的重複表達。因此需要分布維護、擁擠度控制或歸檔集策略等機制,把「分散」作為顯式保護目標之一。
界線區分
偏好不等於替人決策,差異也不等於隨機雜訊。候選方案之間的差異必須能用目標權衡結構解釋——否則那只是不可用的無效多樣性。
輸出形態因此從「單一最佳解」轉變為「可解釋、可比較的候選方案組」:專家可以結合領域知識與現實限制做出選擇,並把選擇結果作為新一輪回饋送回搜尋過程。
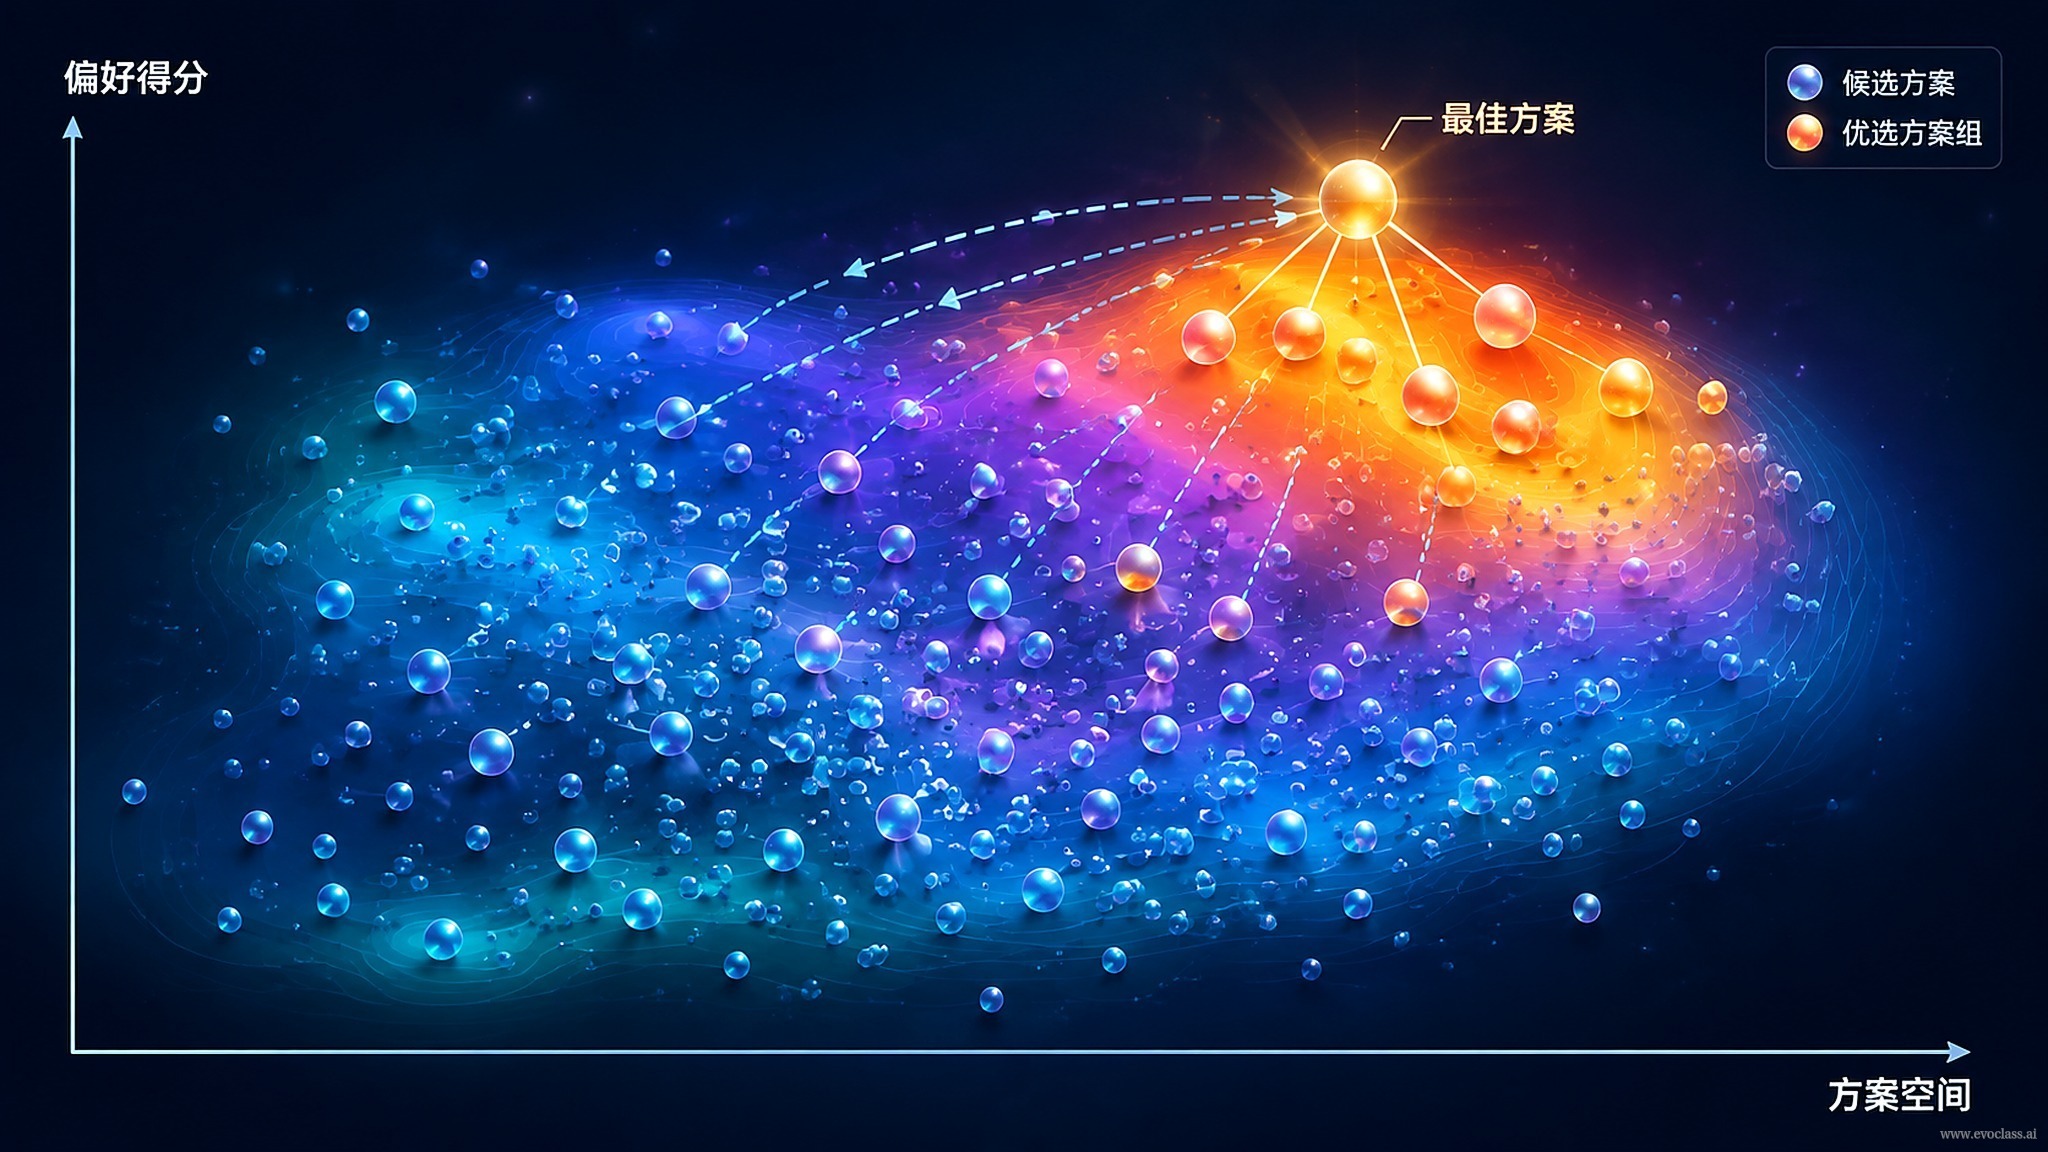
候選方案分布散點圖示用分散的候選點表示偏好優化後的搜尋輸出:參考點、目標優先順序、權重區間或互動式回饋引導搜尋收窄,但分布維護與擁擠度控制保留差異性。組內方案應涵蓋保守端、激進端與折衷段,讓專家結合現實限制做最終取捨,而非提前坍縮成單一解。
候選方案分布散點
圖示用分散的候選點表示偏好優化後的搜尋輸出:參考點、目標優先順序、權重區間或互動式回饋引導搜尋收窄,但分布維護與擁擠度控制保留差異性。組內方案應涵蓋保守端、激進端與折衷段,讓專家結合現實限制做最終取捨,而非提前坍縮成單一解。