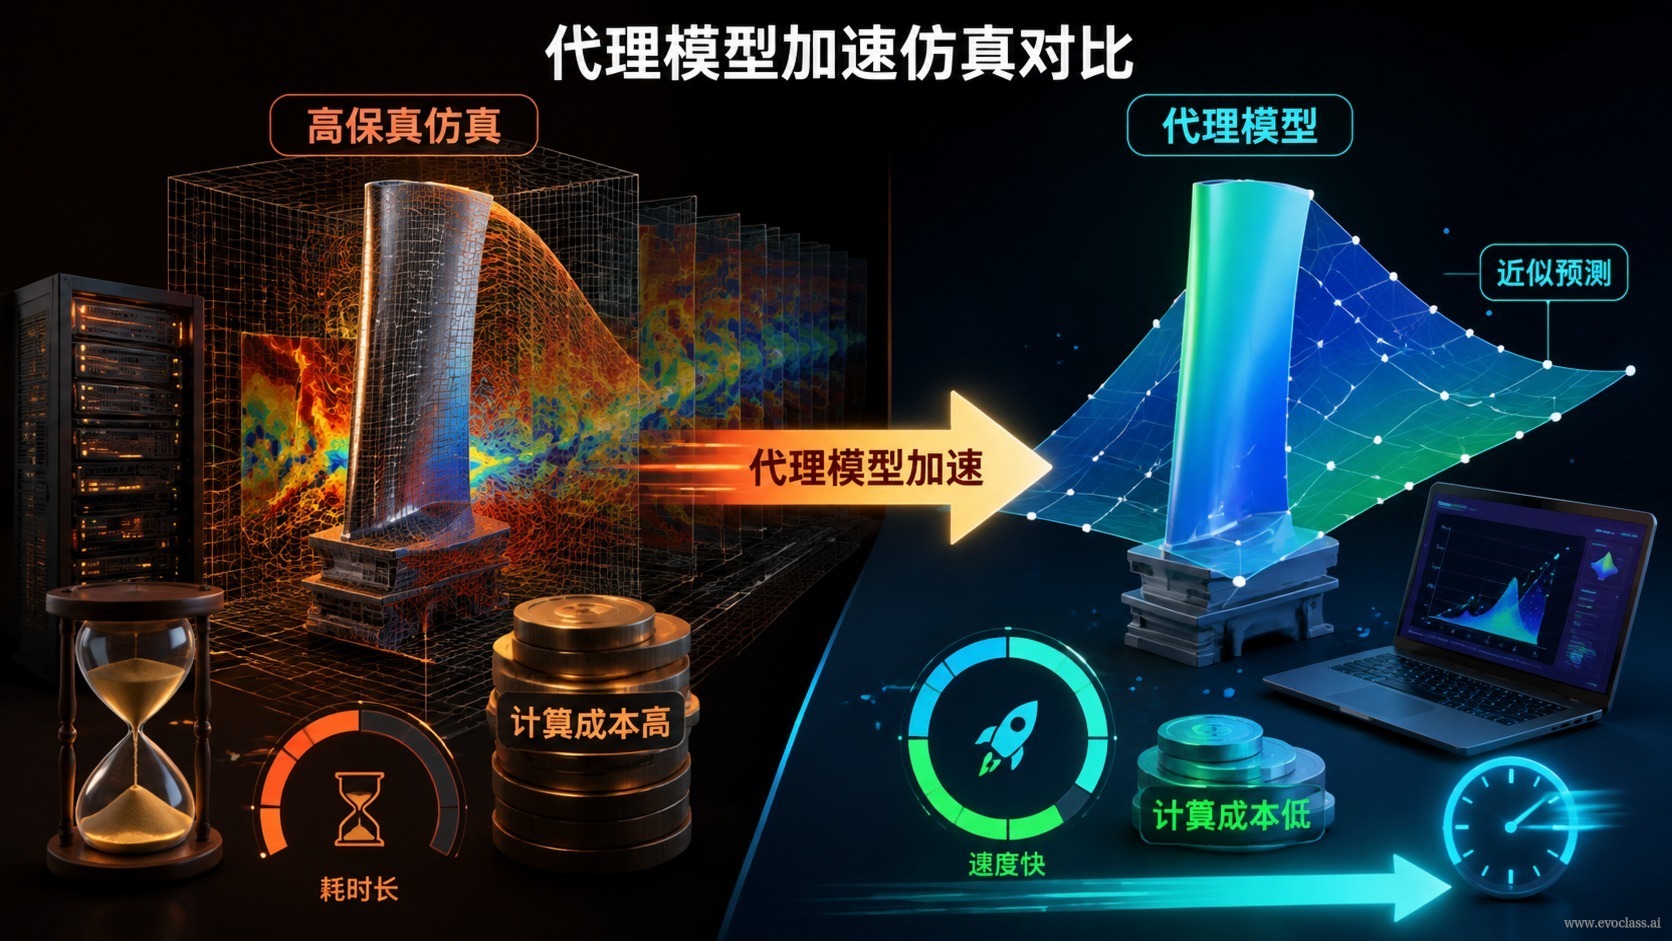
在超臨界翼型等複雜工程設計中,高保真模擬(CFD、有限元素分析)的單次評估往往需要數十分鐘到數小時。若把這種模擬直接嵌入演化循環,每一代族群都要逐個評估,計算預算會在數十代之內被迅速耗盡,可探索的搜尋空間也隨之被壓縮。
代理模型(surrogate model,也稱近似模型、元模型)用低成本近似計算替代或部分替代高保真模擬:它從已有模擬樣本中學習輸入—輸出映射,在多目標演化最佳化中快速預測候選方案的效能,從而突破高精度模擬成本高昂的瓶頸。
為什麼不能把高保真模擬直接塞進演化循環
- 瓶頸來源:超臨界翼型、結構強度等問題的單次 CFD / 有限元素模擬耗時長,而演化演算法每一代都要評估整個族群,評估次數與計算預算近似線性消耗。
- 直接後果:預算被少數幾代吃光,族群規模與迭代代數只能被迫壓縮,多目標前沿難以被充分探索,真正的設計空間被「評估不起」所封鎖。
代理模型的基本原理
用基礎翼型、擾動樣本等已有資料訓練一個映射關係「候選方案 → 目標值與約束表現」,它就成為一個廉價近似評估器。演化循環中候選解先由代理批量評分,只有評分靠前、或不確定性偏大的少數候選才交給高保真模擬校核。
加速路徑的四個環節
- 離線訓練:用初始取樣樣本訓練代理模型,建立初步的輸入—輸出映射。
- 線上批量預測:每一代對全部候選同時預測多個目標值,替代逐點高保真模擬。
- 代理輔助選點:結合預測值與不確定性,挑選高潛力或高資訊量的候選。
- 回填校正:把少量高保真結果寫回樣本庫並增量更新代理,使後續預測持續貼近真實響應面。
精度與成本的權衡
代理模型越複雜(從簡單迴歸到高斯過程、深度網路),通常越準,但訓練與推斷開銷也隨之上升。關鍵約束是代理必須顯著快於高保真模擬,否則它會變成新的瓶頸;同時精度要足以支撐選擇壓力,否則演化會被錯誤的方向帶偏。
邊界與風險
代理只在訓練分布附近可靠。當搜尋把候選推向分布外區域時,預測可能給出看似合理卻嚴重偏離的數值,誤導搜尋方向。可行做法是:輸出不確定性估計、設定置信閾值篩選、對越界候選強制高保真驗證,並用實際誤差統計定期檢查代理品質。
常見迷思
代理模型不是「更精確的模擬」,而是「更便宜的近似」。它的價值來自把稀缺的高保真預算集中投向最關鍵、最不確定的候選,而不是取消驗證環節。
代理模型加速模擬對比圖示對比高保真模擬與代理模型在演化最佳化中的評估流程:前者逐點耗時,難以支撐大族群多代搜尋;後者用已有樣本學習候選方案到目標值的映射,批量快速預測。僅把靠前或不確定性大的候選交給高保真校核,並將結果回填更新代理,從而把稀缺模擬預算集中在關鍵候選上。
代理模型加速模擬對比
圖示對比高保真模擬與代理模型在演化最佳化中的評估流程:前者逐點耗時,難以支撐大族群多代搜尋;後者用已有樣本學習候選方案到目標值的映射,批量快速預測。僅把靠前或不確定性大的候選交給高保真校核,並將結果回填更新代理,從而把稀缺模擬預算集中在關鍵候選上。