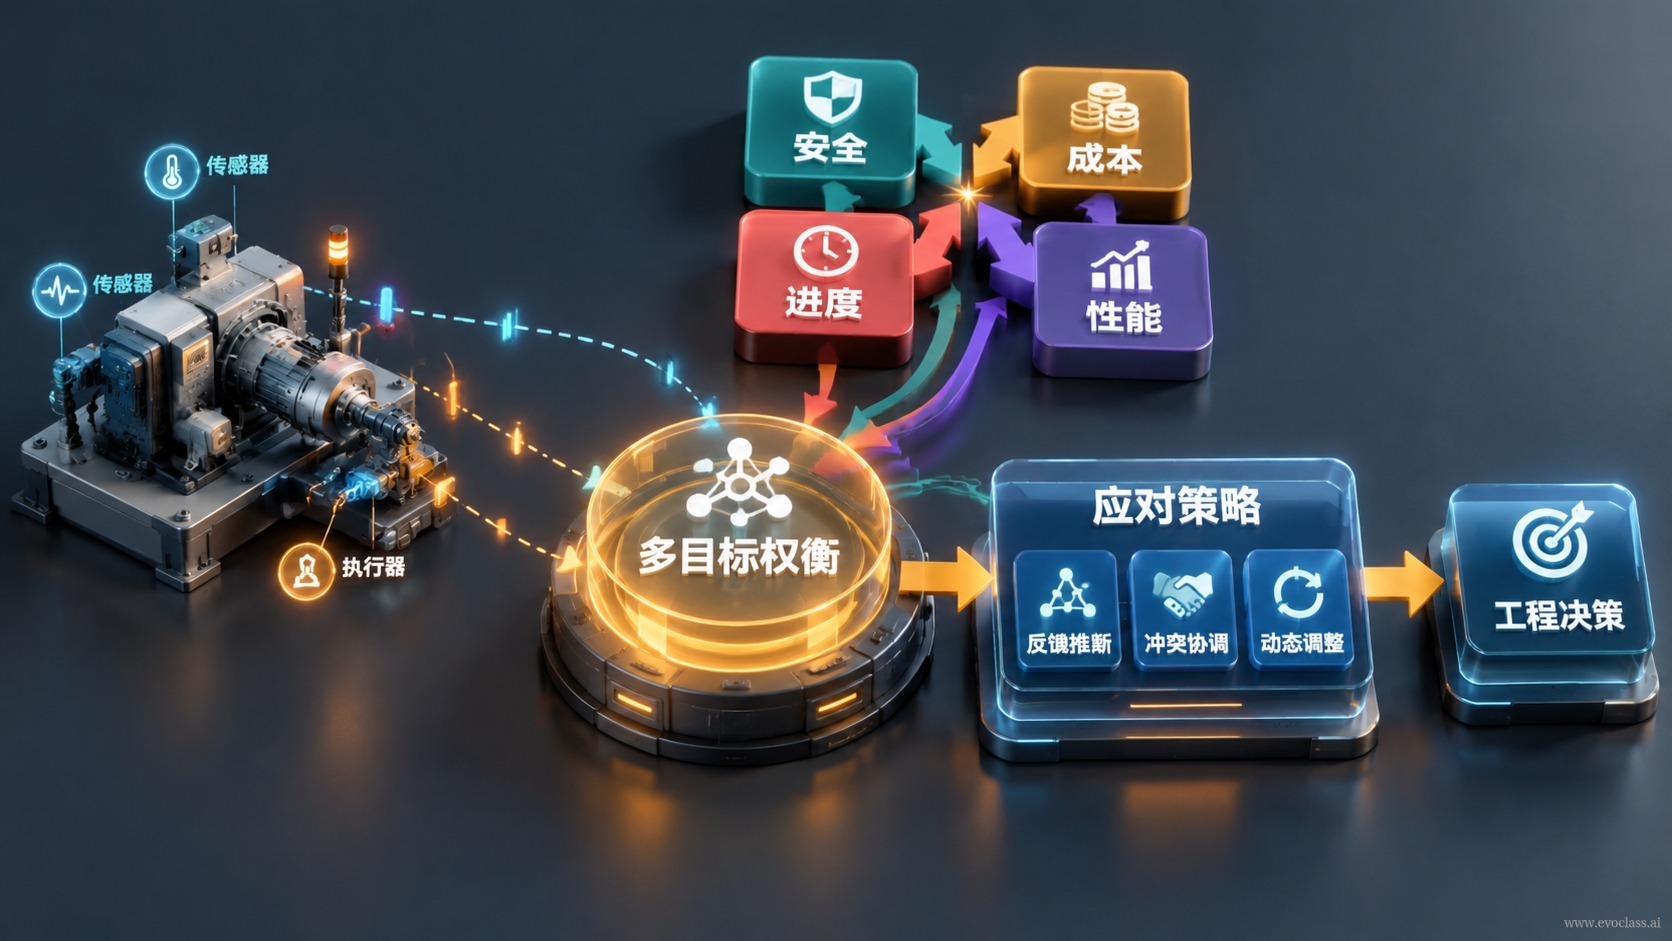
在複雜工程最佳化中,目標衝突與稀疏回饋几乎是常態。本頁要建立的判斷是:這兩類挑戰不是等待被「消除」的缺陷,而是應當被顯式建模的對象。工作重心也隨之從「求一個單目標最佳解」,轉變為在少量、昂貴、帶雜訊的回饋下,動態管理多目標之間的折衷。
放到課程脈絡中來看,演化計算之所以是應對這類問題的重要路線,正因為它像自然界的變異與選擇那樣,不預先指定唯一答案,而是透過產生變化與環境評價尋找平衡;符號主義、連接主義、控制論與演化計算等多條路線在此重新匯合。演化計算天生適合並行,允許族群候選同時生成與評價,這為同時追蹤多個彼此衝突的目標提供了機制基礎。
學習目標:識別工程實際中目標衝突與稀疏回饋的挑戰。核心概念:稀疏回饋。
一、目標衝突:多指標此消彼長
真實工程常同時追求效能、成本、可靠性、能耗與製造約束。這些指標彼此制約:提升一個目標往往以犧牲另一個為代價。例如超臨界翼型設計中,提高升阻比可能加劇阻力發散,強化結構又會增加重量與製造難度。因此真正的提問不是「哪個指標最重要」,而是「在什麼條件下接受怎樣的折衷」。
二、稀疏回饋:少、貴、慢、帶雜訊
高保真模擬、物理實驗與現場驗證的成本高、週期長、雜訊大,並且經常傳回失敗樣本。這意味著可用於評價設計的有效訊號數量少、到達延遲、且不連續——這就是稀疏回饋。它不只是「資料不夠多」,而是評價預算本身成為設計流程的硬約束:每呼叫一次真實評估,都要付出可觀的時間與資源。
三、稀疏回饋帶來的系統性挑戰
- 代理模型偏差被放大:真實評估次數很少時,近似誤差難以被及時發現,容易被當作真實規律直接使用。
- 過擬合與過早收斂:有限樣本下的「最佳」可能只是取樣雜訊的產物,搜尋會過早收斂到局部區域。
- 探索與利用失衡:回饋昂貴使「利用」看起來更划算,但探索不足會讓整個族群停留在同一片區域。
- 固定偏好的僵化:固定權重或固定偏好無法適應階段性發現——早期認為次要的約束,可能在後續評估中變成主導瓶頸。
四、動態調整:把單次最佳改成持續折衷
- 代理模型與多保真度評估:用低成本近似承接大部分篩選,只在關鍵候選上投入昂貴預算,降低單次回饋成本。
- 主動取樣與批次實驗:優先評估資訊增益高或位於折衷前沿的候選,提高每一次昂貴回饋的樣本效率。
- 多目標演化:以族群方式同時維護多個非支配候選,保持帕雷托前沿上的多樣性,輸出候選方案組而非單點答案。
- 偏好與約束更新:隨評估結果、不確定性變化與領域知識補充,階段性調整權重、約束、參考點與搜尋範圍。
這一整套做法正是「多路徑而非預設單一最佳」的具體化:借助群體智慧式的候選群維持多樣性,把昂貴評價交給低成本近似,並讓偏好隨證據滾動更新;在工程實現上,GPU 與大模型帶來的大規模並行探索與生成能力,為這種並行、分散式的搜尋提供了底座。
五、把衝突與折衷顯式化
應對目標不是消滅衝突,而是讓衝突、風險與折衷關係變得可解釋:哪些指標在競爭、當前位於權衡曲線的哪一段、候選解對偏好變化有多敏感。與預設單一最佳路徑相比,這種做法的優勢在於不依賴提前知道唯一正確答案,而允許系統同時保留多個候選,在實際評價中平衡不同目標之間的權衡關係。這樣得到的候選集才能被專家有效評估與決策,而不是被三個月前的固定權重鎖死。
稀疏回饋與目標衝突處理框圖圖示把目標衝突與稀疏回饋作為需要顯式建模的對象:多個工程指標此消彼長,而高保真評價少、貴、慢且帶雜訊。應對機制是用代理模型與多保真評估降低呼叫成本,以主動取樣和多目標演化維護折衷候選,並隨證據更新偏好與約束。