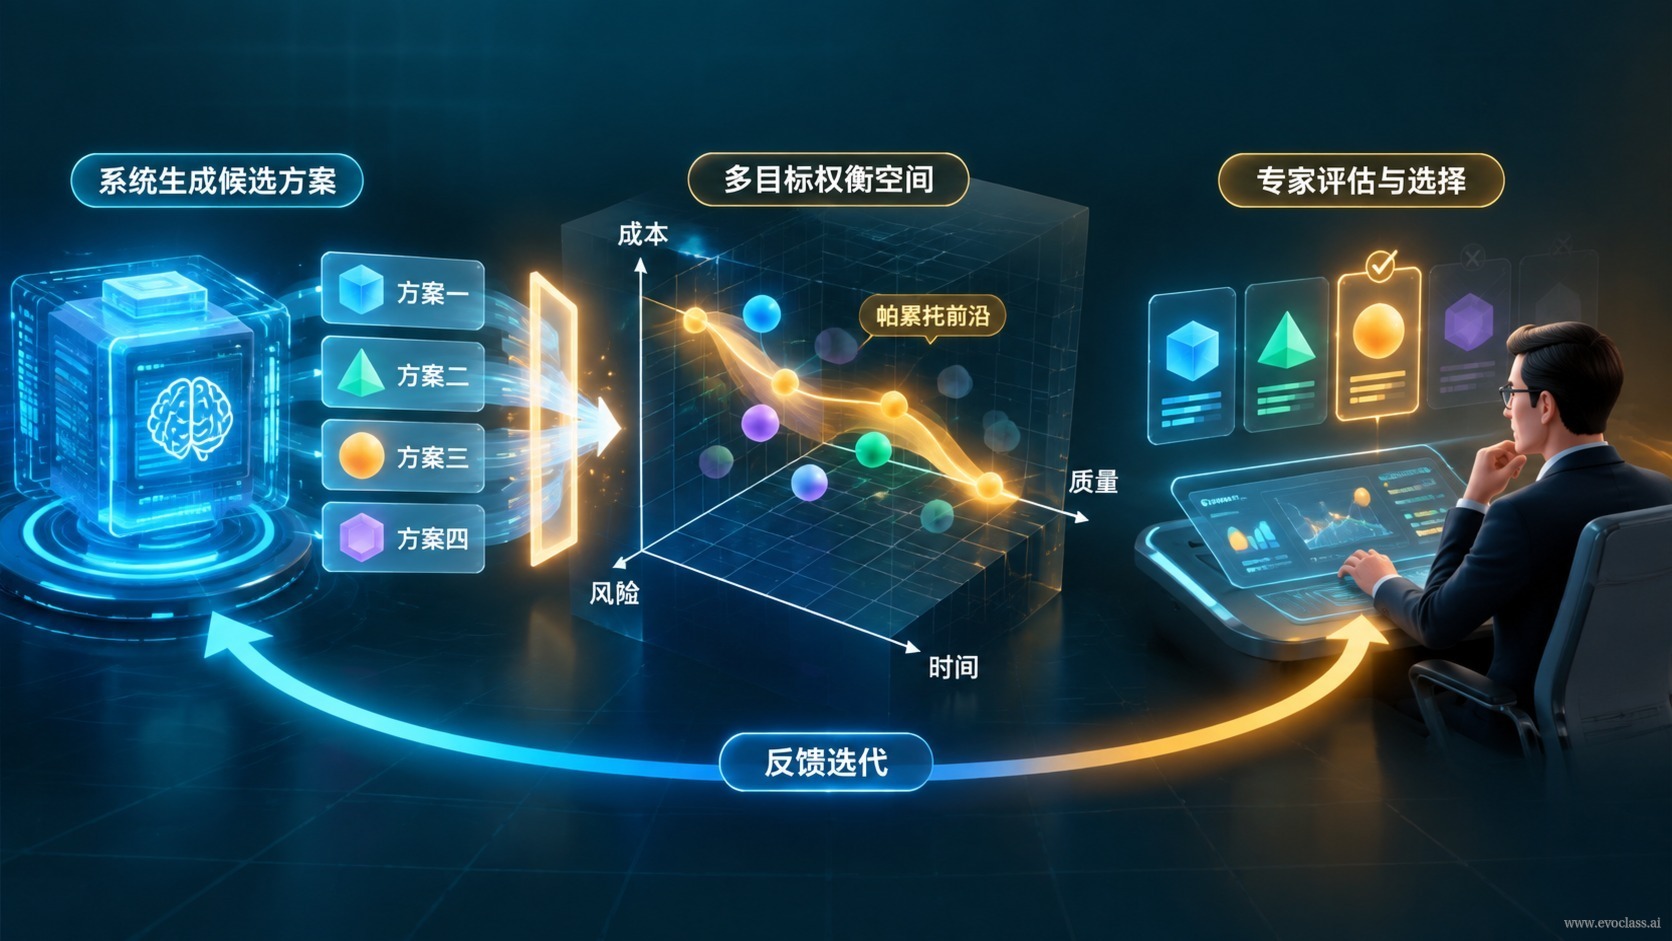
在 EvoX 的多目標探索流程中,自動化系統與領域專家並非彼此替代,而是分工協作的雙引擎:系統負責「生成與篩選」,專家負責「判斷與決策」。系統把可能性鋪開,專家把可能性收斂為一個可交付的選擇。
這套分工承接了第 2 課的技術源流:EvoX 的來路是符號主義、連接主義、控制論與演化計算重新匯合之處,其中演化計算是最直接的技術源流——它不預先指定唯一答案,而是透過變異與選擇、在實際評價中平衡相互衝突的多個目標。正因如此,系統側天然適合並行:種群中的候選可以同時生成與評價。傳統工程長期受制於「保留多樣性成本高昂、串行排程繁瑣」,而 GPU 與大模型帶來的大規模並行探索與智能生成,正是緩解這一矛盾的工程底座。
職責分工:誰負責生成,誰負責拍板
- 系統側:完成大規模候選生成、代理模型預測、Pareto 前沿刻畫與多樣性保持,回答「有哪些可能」。
- 專家側:決定目標優先級、硬約束、風險容忍度與真實場景適配性,回答「該選哪一個、為什麼」。
評估維度:單目標最優不等於可交付方案
方案評估要把性能收益與工程代價轉化為可解釋、可審計的決策依據。除性能收益外,至少還要同時考察計算與製造成本、魯棒性、可維護性、不確定性,以及在稀疏回饋下結論的可信度。只看單目標最優,往往會選出工程上無法落地、或對擾動極其脆弱的方案;而在目標衝突、約束複雜的問題中,恰恰是多維評估才讓演化搜尋所保留的多個候選各自顯現其適用場景。
決策方法:把領域經驗變成可複核的邏輯
透過顯式偏好、分層評價、決策矩陣、閾值否決項與敏感性分析,領域經驗可以被表達為可檢驗、可複現的選擇規則。一個常用順序是:先用硬約束「一票否決」違反底線要求的候選,再對剩餘候選做收益—代價權衡,最後用敏感性分析確認結論對權重擾動是否穩健。
稀疏回饋與責任閉環
當高保真評價昂貴、回饋稀疏時,專家需要依據代理模型的置信度、候選多樣性以及已觀察到的失敗模式,決定是複核、再取樣還是終止搜尋,而不是盲目採信代理模型給出的「最優解」。最終方案的選擇與風險承擔屬於領域專家;選擇理由應回流為偏好、約束或評價信號,指導下一次演化搜尋,形成責任閉環。
應用示例
在超臨界翼型多目標設計中,系統輸出一批兼顧阻力、升力與穩定性的候選方案;專家結合風洞與模擬成本、製造公差和任務剖面,先淘汰違反硬約束者,再對剩餘方案做收益—代價權衡,選出少數進入高保真驗證的候選,並把本輪理由回流為下一輪的偏好與約束。
專家決策與系統生成協作圖圖示區分系統側與專家側的分工:系統負責大規模候選生成、代理預測和帕累托前沿刻畫,專家負責目標優先級、硬約束、風險容忍與最終拍板。評估需同時看收益、成本、魯棒性和可信度,選擇理由再回流為偏好與約束,形成責任閉環。
專家決策與系統生成協作圖
圖示區分系統側與專家側的分工:系統負責大規模候選生成、代理預測和帕累托前沿刻畫,專家負責目標優先級、硬約束、風險容忍與最終拍板。評估需同時看收益、成本、魯棒性和可信度,選擇理由再回流為偏好與約束,形成責任閉環。