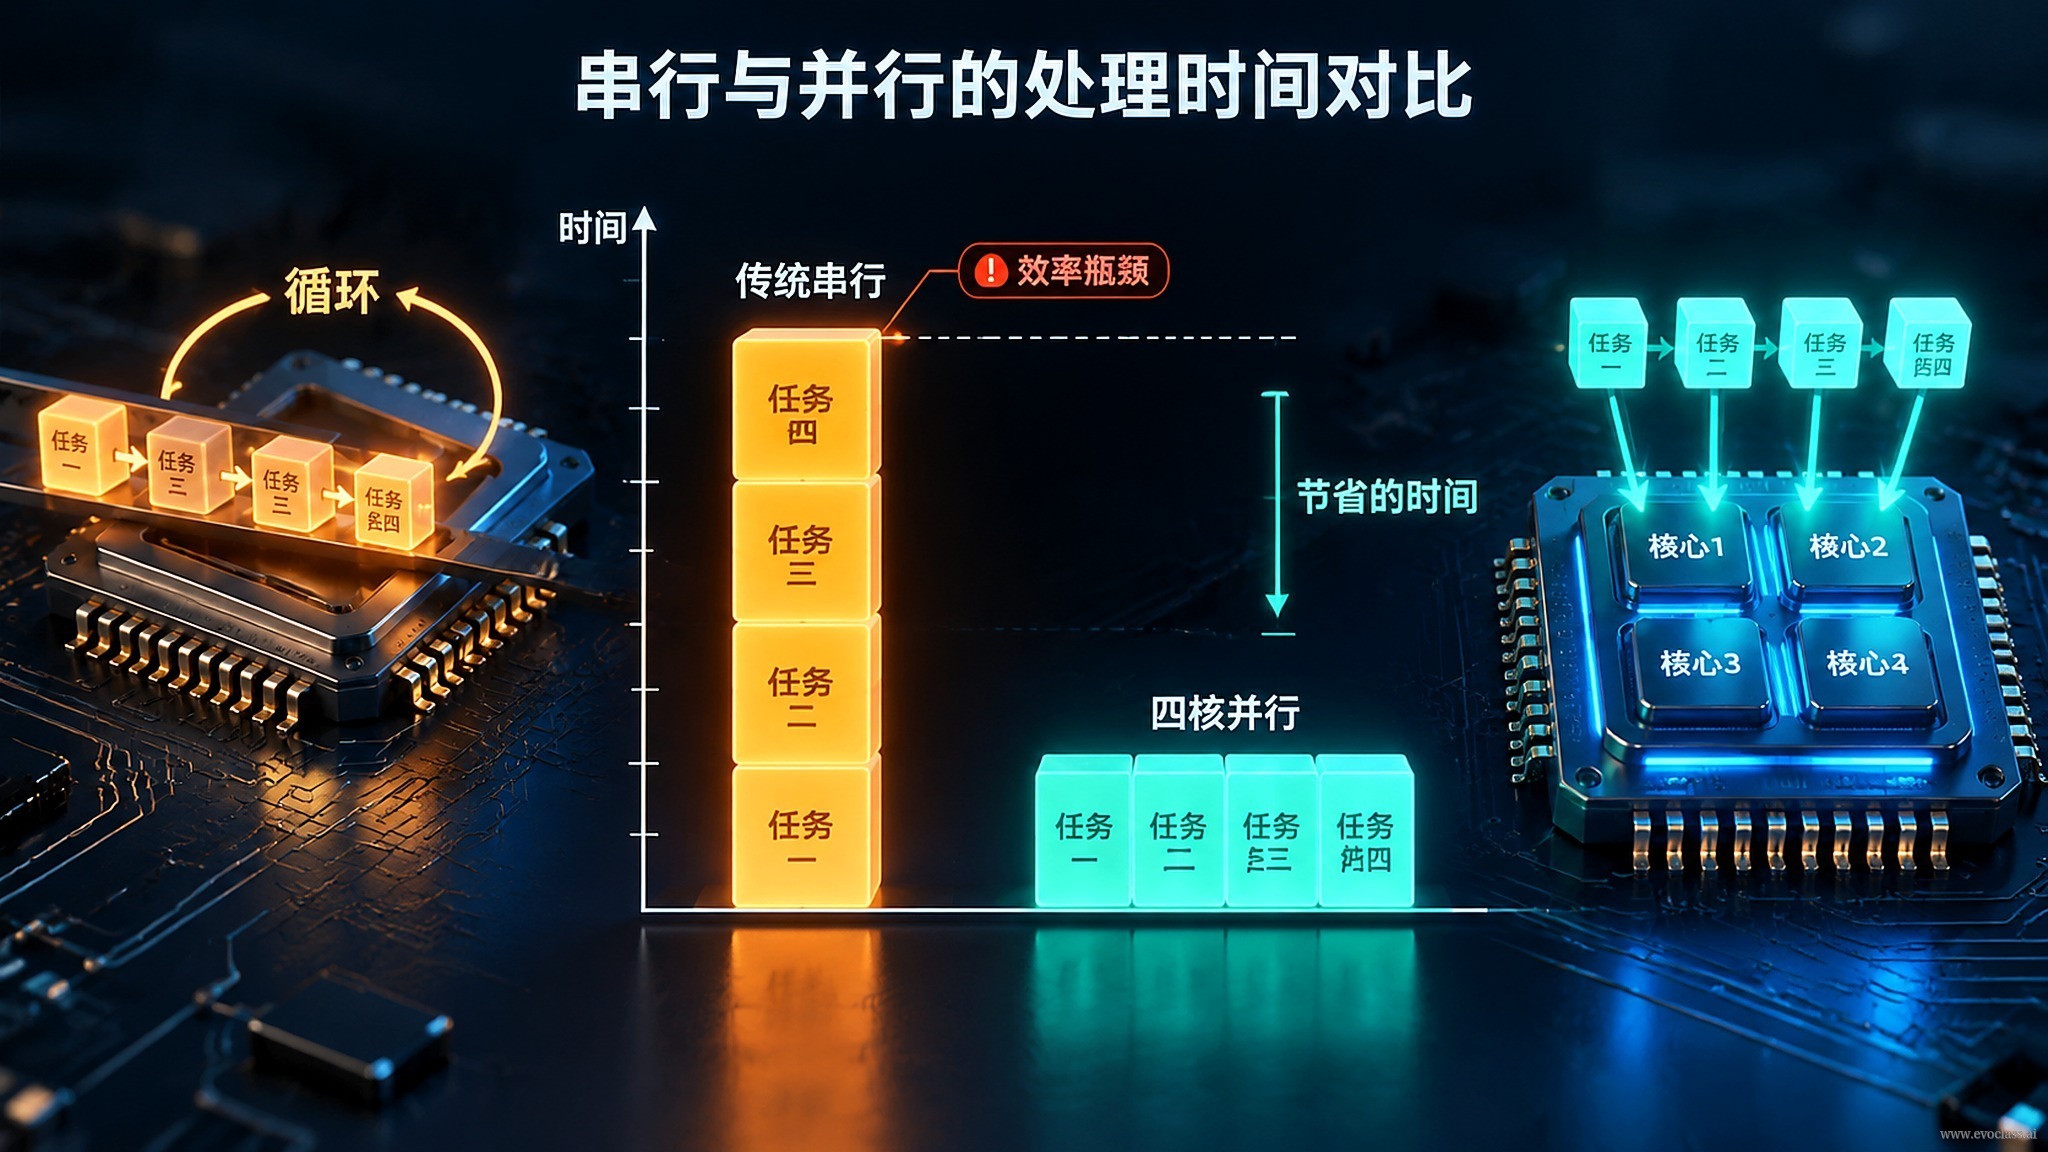
演化過程依賴種群多樣性,而多樣性意味著種群規模與評價次數的成倍增長。當候選評價達到數萬次量級時,傳統串行 CPU 迴圈就成了整條流水線上最窄的一段:它一次只處理一個個體,硬體的並行能力幾乎被閒置。
一次一個:串行迴圈的執行模型
最樸素的實現是把整個種群當成一個列表,用迴圈逐個取出個體:取個體 → 解碼為具體參數 → 呼叫評價函式 → 把適應度寫回。相鄰迭代之間幾乎無法重疊:評價結果不回來,寫回就無法推進;寫回不完成,下一個體就無處安放結果。於是多核、SIMD、GPU 這些並行單元大部分時間處於空閒,只能看著一個個體在流水線上跑完。
開銷到底來自哪裡
- 線性膨脹的評價次數:總評價次數約為種群規模 × 迭代代數,達到 10⁵ 量級時,串行牆鐘耗時近似線性增長。
- 解譯器層的逐個執行:逐個體迴圈、邊界檢查與型別分派帶來固定卻高昂的常數開銷。
- 非連續訪存與資料搬運:逐個取用的個體在記憶體中往往不連續,快取命中率偏低,搬運成本被反覆支付。
- 同步與調度:為了取到下一個個體,執行流必須反覆停頓再恢復。
把規模換算成時間
以種群 1000、迭代 100 代為例,共約 10 萬次候選評價。若單次評價平均 1 ms,僅評價環節串行就需約 100 秒,尚未計入算子計算與調度開銷;若為維持多樣性把重啟次數從 1 次增加到 5 次,代價近似線性上升到約 500 秒。同等工作量若按批組織並交由並行硬體處理,牆鐘時間主要由批次數而非個體數決定。
什麼時候這個瓶頸會收窄
邊界條件同樣重要:當單次評價極廉價(微秒級)或種群極小(百量級以下)時,調度與記憶體開銷可能反超計算開銷,串行與並行的差距明顯收窄,張量化的邊際收益遞減,瓶頸會轉移到調度粒度與記憶體頻寬。因此是否值得改造執行模型,需要結合評價成本與規模共同評估。
結構性瓶頸,而非程式碼瑕疵
串行 CPU 迴圈的效率瓶頸屬於執行模型層面:單點程式碼調優無法消除它。要真正解決,需要把逐個重構為逐批——批處理、張量化與並行調度,這也構成後續張量化計算圖設計的直接動機。
串行與並行的耗時對比以種群1000、迭代100代為例,共約10萬次候選評價;單次評價1毫秒時串行僅評價環節就需約100秒,重啟5次則近似線性增至約500秒。改按批組織交給並行硬體後,牆鐘時間主要由批次數而非個體數決定。
串行與並行的耗時對比
以種群1000、迭代100代為例,共約10萬次候選評價;單次評價1毫秒時串行僅評價環節就需約100秒,重啟5次則近似線性增至約500秒。改按批組織交給並行硬體後,牆鐘時間主要由批次數而非個體數決定。