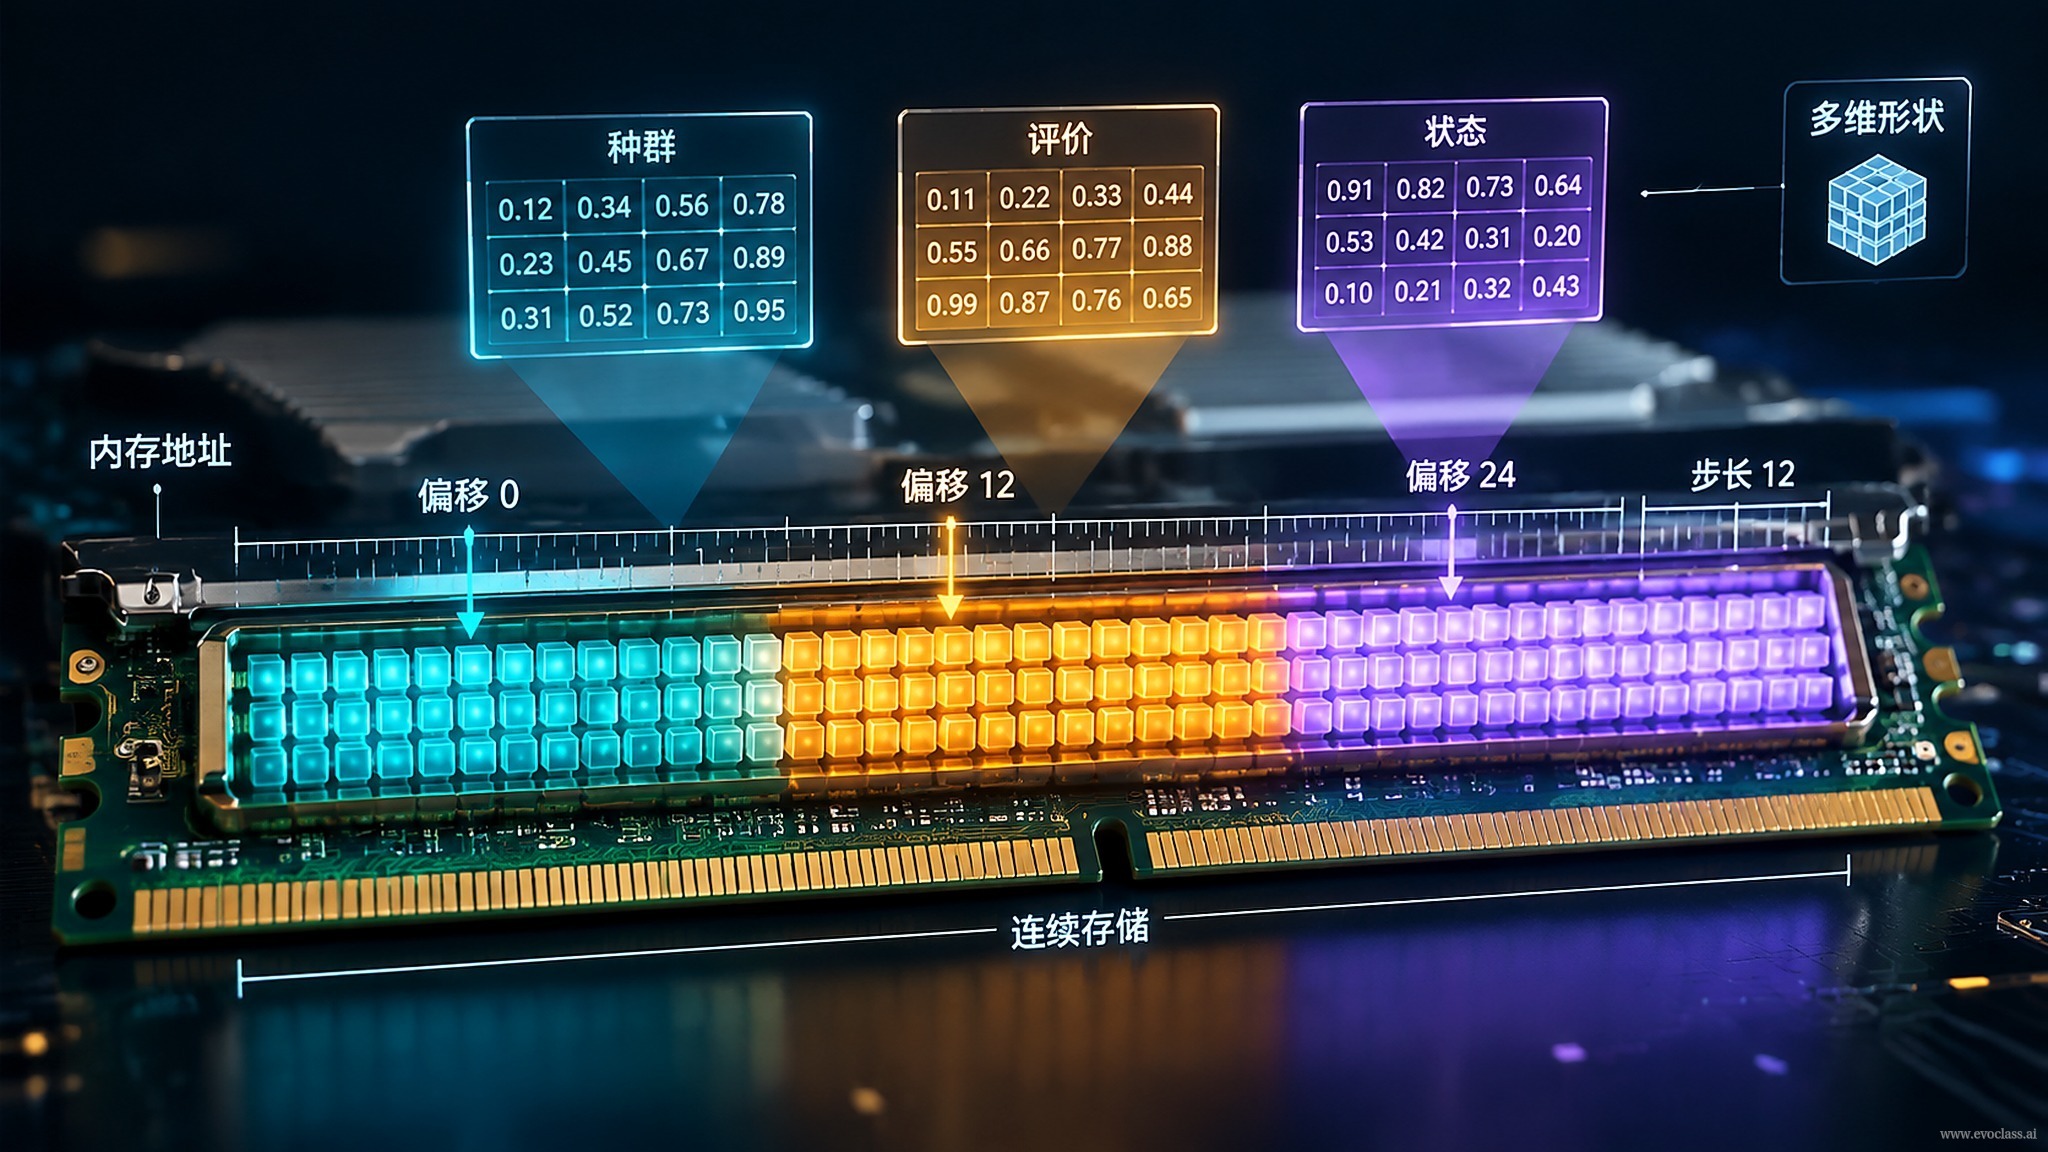
在演化算法的工程實作中,張量化組織將「種群是什麼、評價得怎樣、執行到哪一步」從零散的物件與列表統一映射為規則張量。其本質是建立種群、評價與狀態的統一資料契約,使批次計算、裝置駐留與後續平行排程具備共同的記憶體語意。
種群張量化:編碼為 [N, D]
將 N 個候選解按批次維組織為形狀 [N, D] 的編碼張量。連續變數、離散變數或多段編碼可用欄位張量或分組區塊表達,並保持統一的資料型別與裝置位置。
- 批次維在外:通常將 N 置於最外層,使同一算子在整批上向量化執行。
- 欄位分塊:若個體由多段參數組成,可拆成 [N, D1] + [N, D2] + … 並保持連續儲存。
- 變長處理:變長個體以填充加遮罩或分桶處理,避免異質結構破壞整批計算。
評價結果矩陣化:[N, M] 與 [N, K]
一次批次評價產生 [N, M] 適應度矩陣;多目標、多限制條件與附加指標可並列為 [N, M+K] 或分表儲存,避免逐個體迴圈呼叫評價函式。
狀態張量統一管理
世代、亂數狀態、策略超參數、最佳解、歷史快取、排名或取樣狀態等也納入張量或結構化狀態容器,確保可重現、可追蹤與可批次更新。
實例:N=1024, D=50, M=2
種群表示為 [1024, 50] 張量,評價值為 [1024, 2] 張量,限制條件為 [1024, K]。世代 generation、最佳解 best_x、亂數狀態 rng_state 作為狀態張量統一駐留裝置。每代更新可在同一批次維上整體完成,而非逐個體 Python 迴圈。
組織收益與邊界
統一張量能減少主機與裝置間往返、降低迴圈開銷,並為後續算子平行提供資料基礎;但需處理遮罩有效性、填充浪費、多目標規模成長與狀態同步成本。
種群、評價與狀態的張量佈局種群編碼為 [N, D] 張量、一次批次評價得到 [N, M] 適應度矩陣,多目標或限制條件可擴展為 [N, M+K];世代、最佳解、亂數狀態等也作為張量統一駐留裝置,使每代更新在同一批次維上整體完成,減少主機與裝置間往返與逐個體迴圈開銷。
種群、評價與狀態的張量佈局
種群編碼為 [N, D] 張量、一次批次評價得到 [N, M] 適應度矩陣,多目標或限制條件可擴展為 [N, M+K];世代、最佳解、亂數狀態等也作為張量統一駐留裝置,使每代更新在同一批次維上整體完成,減少主機與裝置間往返與逐個體迴圈開銷。