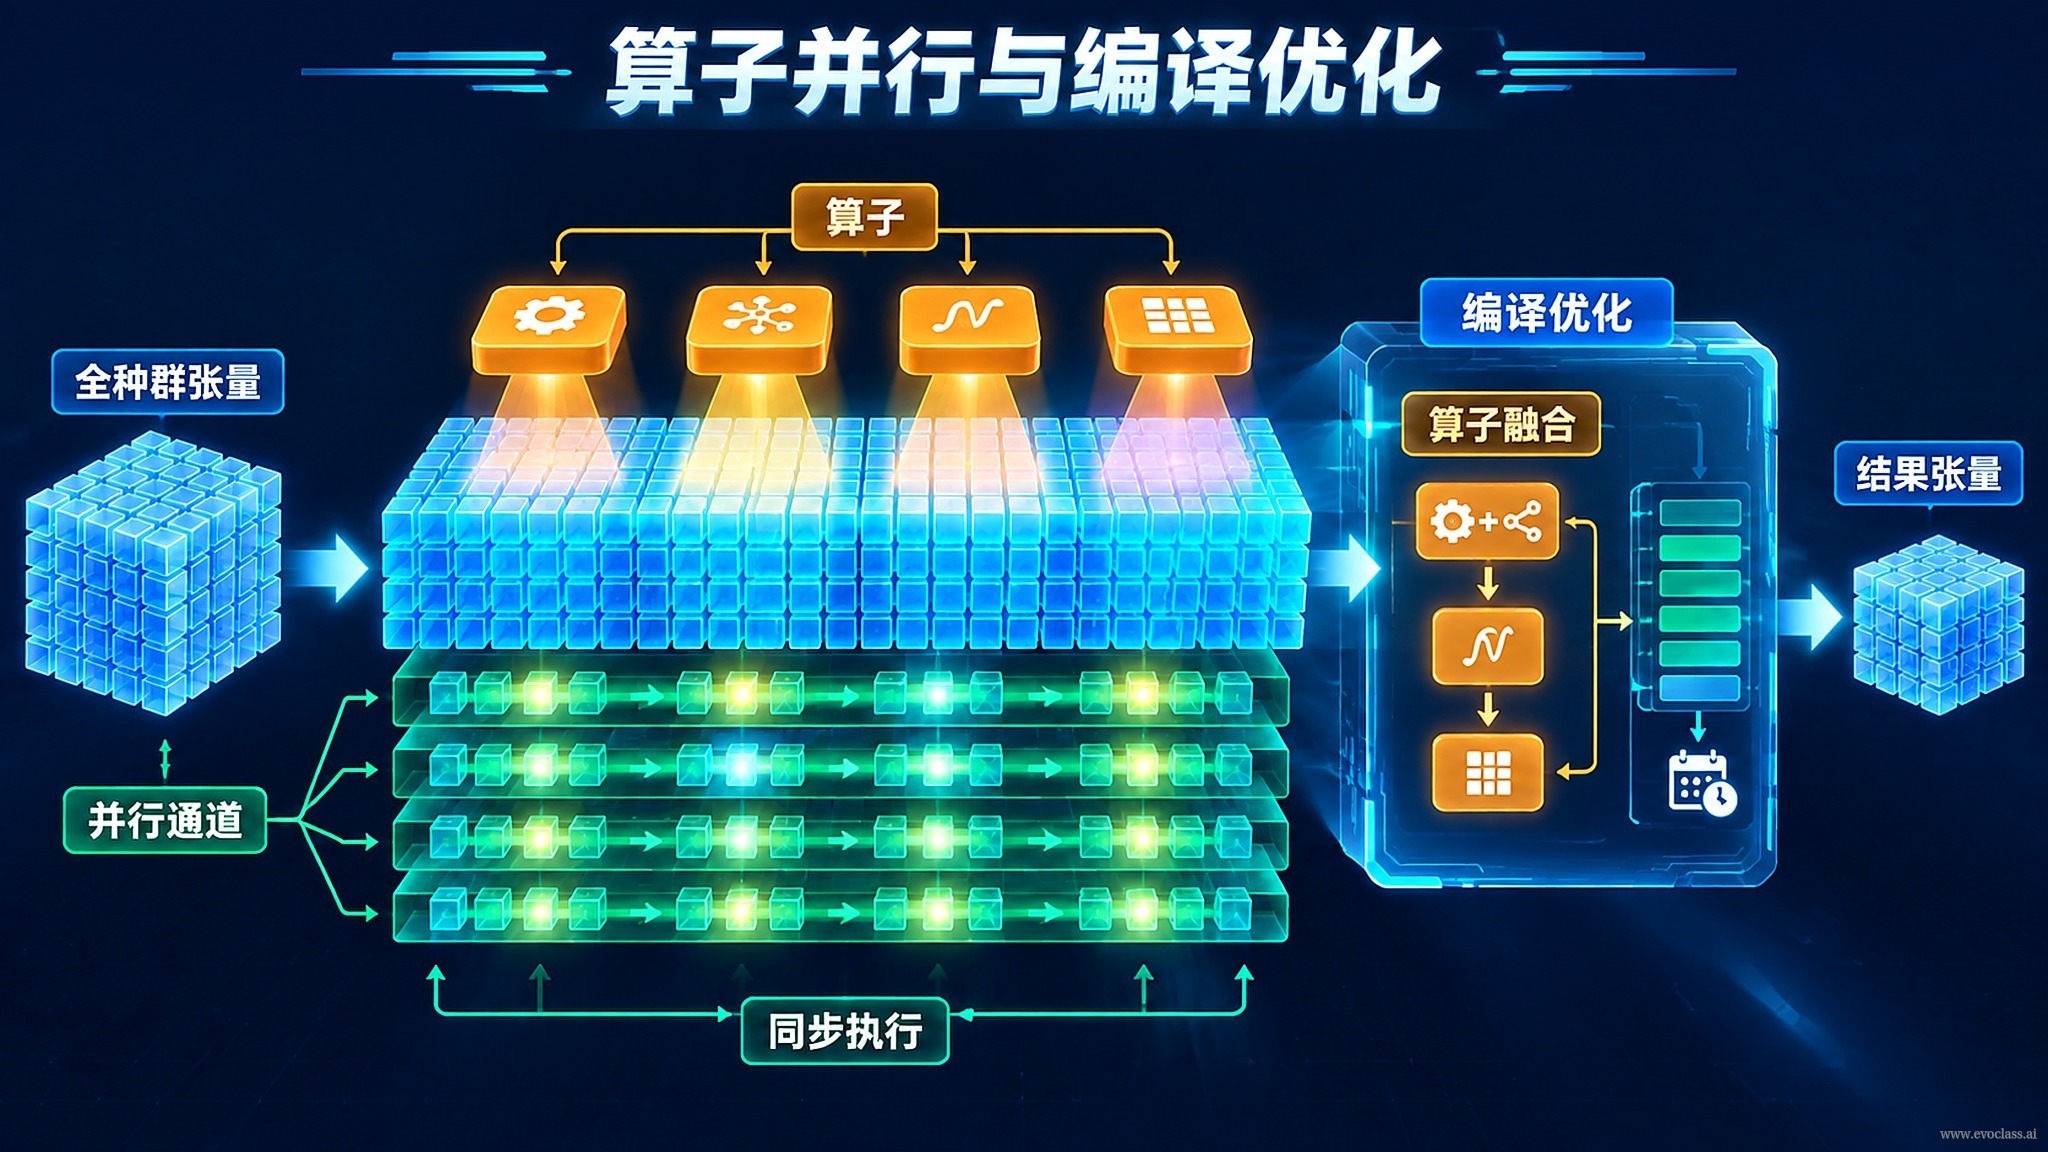
在 EvoX 的現代運算底座中,演化算子的最小執行單元不再是「個體」,而是整個族群張量:突變、交叉、選擇等算子一次呼叫即可涵蓋全部個體;在此之上,計算圖編譯將算子序列組織成可最佳化的執行計畫,在保持演算法語意不變的前提下提升執行效率。
算子並行:以張量為單位的批次演化
- 張量級算子:突變、交叉、選擇可直接作用於形狀為 [N, D] 的族群張量(N 為族群規模,D 為決策變數維度),一次算子呼叫涵蓋全部 N 個個體。
- 消除逐個體迴圈:不必再寫
for ind in population: ind = mutate(ind)這樣的 Python/CPU 串行迴圈,從而減少頻繁的函式排程與框架呼叫開銷。 - 用批次維度換取吞吐量:個體維度充當批次維度後,算子在裝置上以大規模並行方式執行,批次演化的吞吐量隨族群規模放大。
計算圖編譯:從算子序列到執行計畫
把「突變 → 交叉 → 選擇」的算子依賴關係組織成一張計算圖,編譯器就能在整張圖上做全域最佳化,而不只是逐個算子地呼叫現成實作:
- 算子融合:把多個逐元素(element-wise)運算合併成一個核心,減少中間張量的產生與反覆讀寫。
- 核心生成與排程:為融合後的子圖生成高效核心,用更少的 kernel 啟動次數完成整代演化。
- 記憶體複用:為中間結果預先規劃緩衝區,降低顯存分配與資料搬移帶來的額外開銷。
效率變了,語意沒變
需要區分「怎麼算」與「算什麼」。算子並行與編譯最佳化只改變執行方式——核心數量、中間張量規模、記憶體與排程策略——而不改變突變、交叉、選擇本身的邏輯含義。演算法層仍然按演化語意組合算子,因此在相同隨機種子下,最佳化前後的演化軌跡與結果應當一致。一句話概括:張量化解決「批次算得快不快」,計算圖編譯解決「核心排程得優不優」,而「算的是什麼」保持不變。
常見誤區
把「張量化」誤認為「換了一種演化演算法」。張量化只是把同一個算子作用到整個族群張量上,個體之間的更新規則沒有改變;編譯最佳化同樣不會讓演算法「變得更聰明」。真正需要警惕的是最佳化之後不做迴歸驗證,把實作差異誤當成演算法改進。
算子在全族群張量上的並行流程突變、交叉、選擇不再逐個個體迴圈,而是各自一次呼叫涵蓋整個 [N, D] 族群張量,個體維度充當批次維度以放大吞吐量;這些算子按依賴關係組成計算圖後,編譯器可做算子融合、核心生成與記憶體複用,只改變執行方式,演算法語意與隨機種子下的演化軌跡不變。
算子在全族群張量上的並行流程
突變、交叉、選擇不再逐個個體迴圈,而是各自一次呼叫涵蓋整個 [N, D] 族群張量,個體維度充當批次維度以放大吞吐量;這些算子按依賴關係組成計算圖後,編譯器可做算子融合、核心生成與記憶體複用,只改變執行方式,演算法語意與隨機種子下的演化軌跡不變。