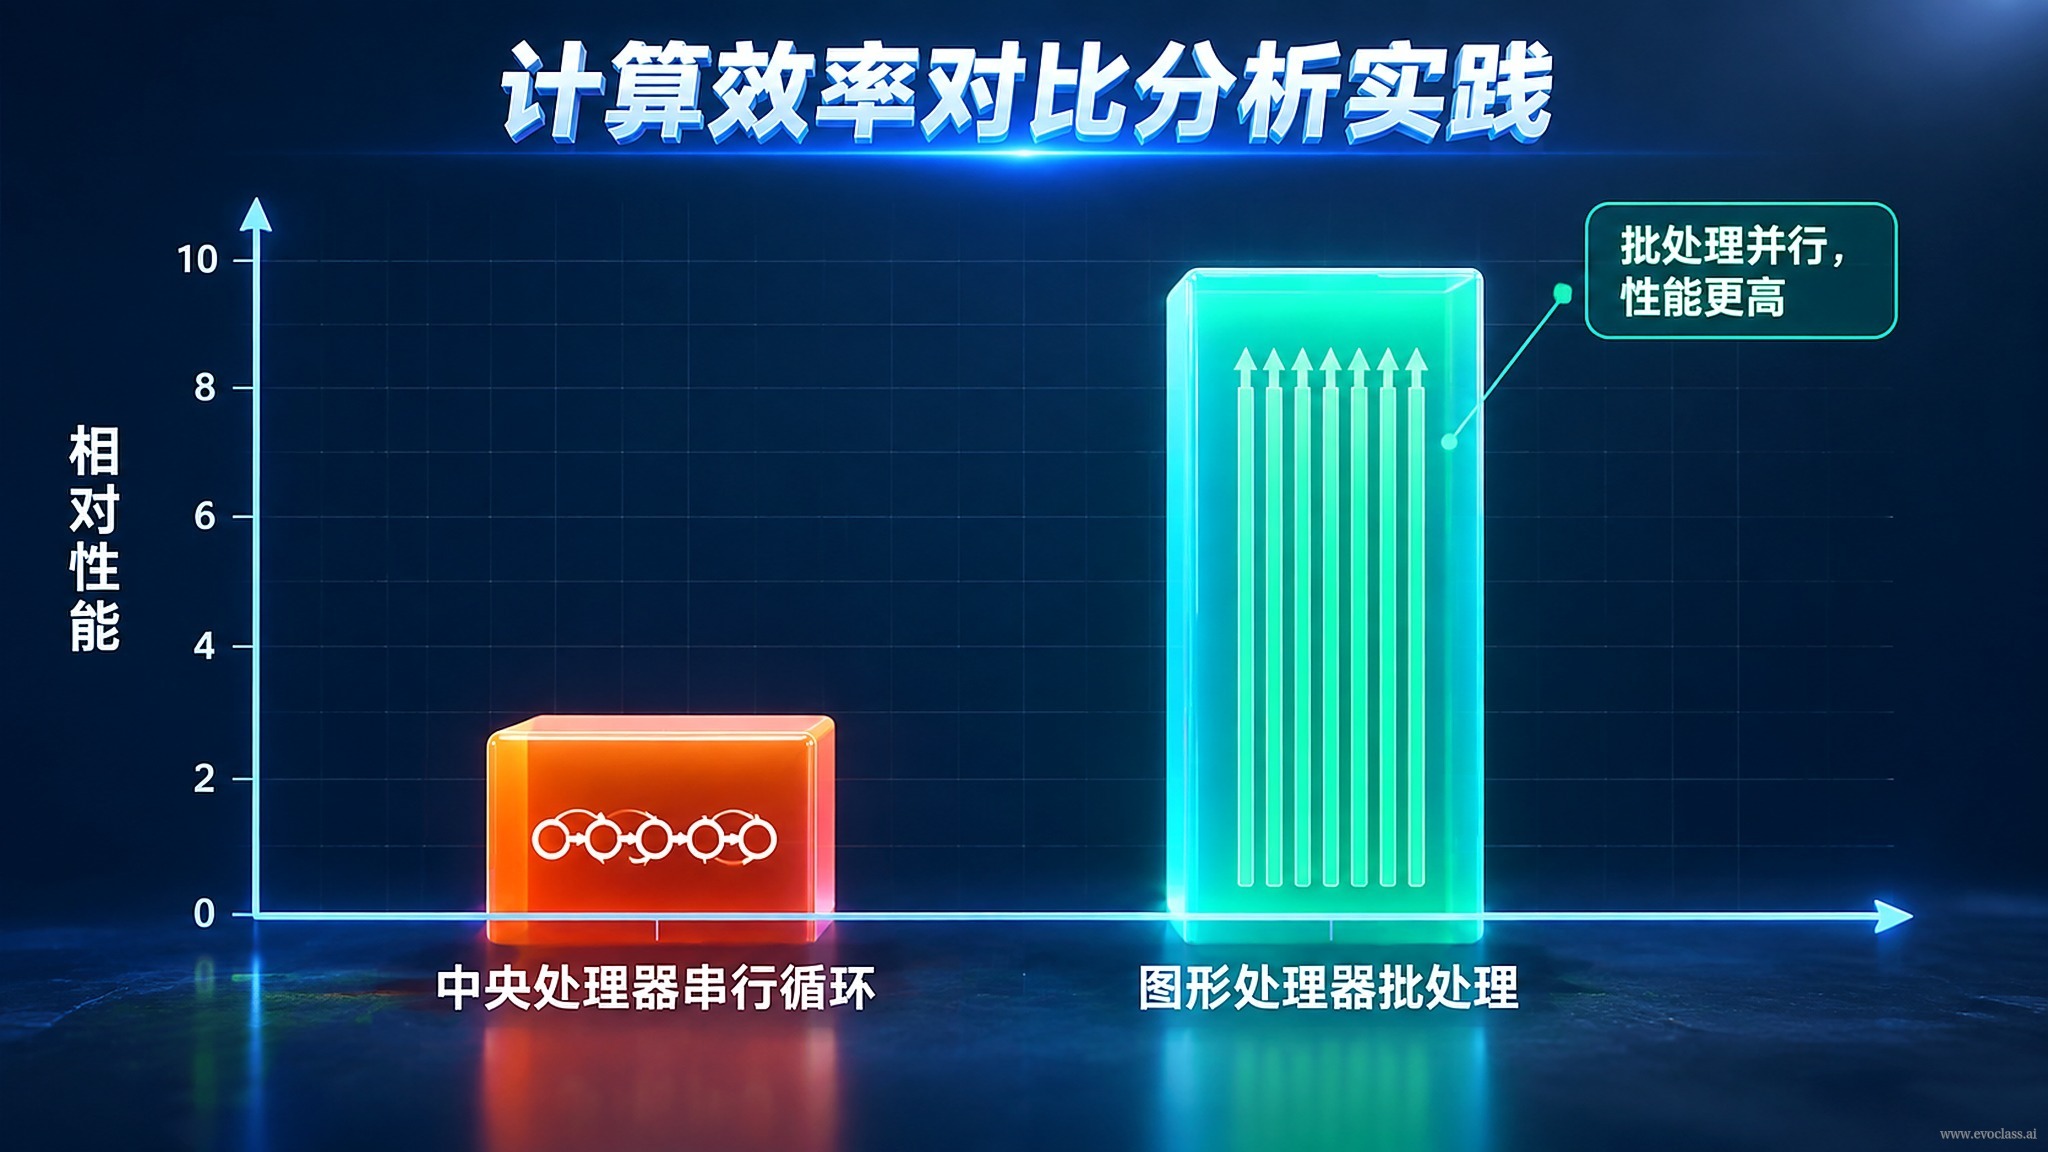
本頁把「計算效率對比」落實到一次可重現的實踐上:在同一個演化任務上,比較傳統 CPU 串行個體巡訪與 EvoX GPU 張量批次處理的端到端效率。目標不是記住「GPU 更快」這個結論,而是理解張量化並行帶來的加速究竟來自哪裡、代價是什麼、邊界在何處。
兩條基準線,同一任務
- CPU 串行基準:以迴圈逐個個體呼叫評價函式,每代需要 N 次獨立排程、狀態更新與結果彙總。迴圈控制、直譯器開銷和分散的記憶體存取會稀釋有效算力,個體越多,這些「非運算」成本佔比越高。
- GPU 張量對比實作:EvoX 把族群、評價輸入與執行狀態組織為張量,在 GPU 上批次執行評價與算子,一次呼叫即涵蓋整個候選集,從而大幅減少串行迴圈與排程次數。
量測協定:讓對比可重現
可重現的對比必須固定問題、族群規模、迭代代數與隨機種子,然後記錄:每代 wall-clock、總耗時、吞吐量(評估/秒)、加速比,以及 GPU 使用率與顯示記憶體佔用。計時前需要預熱以排除首次編譯與顯示記憶體配置的影響,並在計時點進行裝置同步,同時把運算耗時與主機—裝置資料傳輸耗時分開統計。缺少任一環節,得到的加速比都可能失真。
差異從何而來,又受什麼限制
- 收益來源:批次並行、張量化算子以及裝置內並行,使一次呼叫即處理整個候選集,單位時間內完成更多評價。
- 限制條件:批次大小、問題維度、評價函式的可向量化程度、主機—裝置複製開銷與核心啟動開銷都會影響最終加速。批次過小會被啟動開銷吃掉收益;評價函式若無法向量化,批次處理幾乎無從發揮。
實踐結論
正確的順序是:先驗證評價函式能否批次化,再對比 CPU 與 GPU 實作。效率優勢最終應落實到「在相同運算預算下獲得更多代或更多候選方案」上,並據此決定部署方式與實驗設計,而不是單純追求一個漂亮的加速比數字。
CPU 串行與 GPU 批次處理效率對比對比中 CPU 串行基準逐個個體迴圈評價,每代需 N 次排程與狀態更新,直譯器與記憶體存取開銷稀釋有效算力;GPU 批次處理把族群與評價輸入組織為張量,一次呼叫即涵蓋整個候選集。加速比受批次大小、評價函式可向量化程度與主機—裝置複製開銷限制。
CPU 串行與 GPU 批次處理效率對比
對比中 CPU 串行基準逐個個體迴圈評價,每代需 N 次排程與狀態更新,直譯器與記憶體存取開銷稀釋有效算力;GPU 批次處理把族群與評價輸入組織為張量,一次呼叫即涵蓋整個候選集。加速比受批次大小、評價函式可向量化程度與主機—裝置複製開銷限制。