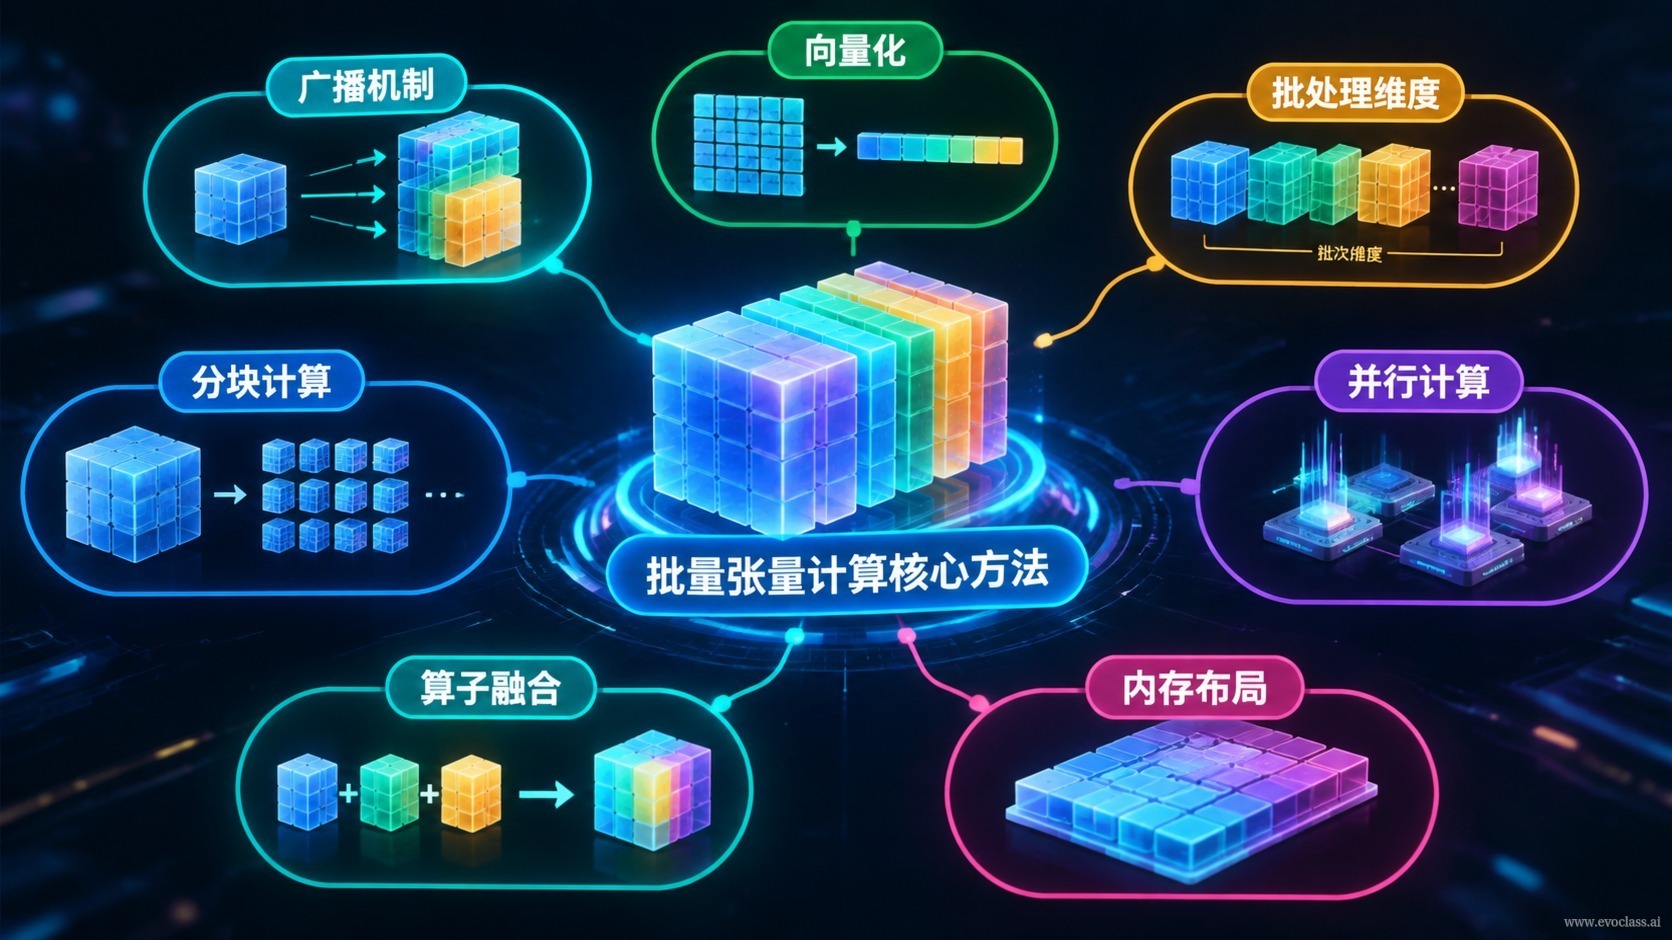
在 EvoX 的張量化底座中,批次張量計算處於演算法表達層:它把演化迴圈裡的候選、評價與狀態統一映射為帶批維度的張量,再交給 GPU 友善的批次算子與編譯計算圖執行。目標十分明確——把「逐個體串行演化」改造成「整種群並行演化」,讓算力真正作用在搜尋本身,而不是消耗在排程與啟動上。
一、把演化過程表達成張量
約定批維度 N 表示候選(個體)數,則演化中的三要素可以直接落成張量:
- 候選張量:種群 X 組織為 [N × D],D 是單個候選的決策變數個數。
- 目標張量:目標與約束 F 組織為 [N × M],M 是目標/約束項數;多目標情形下,各目標即 F 的不同行。
- 狀態量:代數、當前最優值、步長等用純量或小張量緩衝維護,而不是用 Python 物件逐個體記錄。
這樣一來,交叉、變異、選擇、評價全部沿 N 維批次處理,演化迴圈中不再出現逐個體的分支與控制流。
二、批次算子:從 N 次單候選呼叫到一次批運算
三個最小可對照的運算式,勾勒出批次算子的基本形態:
- 變異:X′ = X + σ·randn(X),整批候選在一次批次運算中各自獲得隨機擾動,σ 控制擾動強度。
- 選擇:idx = topk(F, k),在 N 個候選的適應度上一次選出前 k 個候選的索引。
- 評價:Y = fθ(X),用一次批前向或批模擬替代 N 次單候選呼叫。
關鍵並不在某個具體算子,而在於所有候選共享同一張張量運算圖:一次批呼叫即可削減解譯器開銷與核心啟動開銷,使 GPU/多核算力真正作用於演化搜尋。約束與越界處理同樣可以用遮罩張量在同一批運算內完成,不必為個別候選單獨走分支。
三、計算圖優化與吞吐量指標
把多代演化寫成可編譯的資料流圖,還能進一步榨取效能:算子融合減少核心啟動次數,批內並行讓全候選同時執行,非同步執行讓計算與資料傳輸彼此重疊,記憶體複用減少中間張量分配。相應地,效能指標也應從「單步延遲」轉向候選/秒或代/秒的吞吐量——批次執行下一次呼叫就處理整批候選,只有整體吞吐才真實反映搜尋效率。
常見迷思
不要把批次算子包在逐個體迴圈裡,那等於把解譯器開銷與核心啟動開銷重新引入,批維度也失去了並行意義。判斷標準很簡單:一次演化步驟裡,應該只有「批」而沒有「個體」層級的排程。
批次張量計算核心方法導圖導圖把演化過程表達為帶批維度的張量:種群 X 為 N×D,目標與約束 F 為 N×M,交叉、變異、選擇、評價全部沿 N 維批次處理。變異、topk 選擇與批前向評價只需一次批次呼叫,效能指標也從單步延遲轉向候選/秒的吞吐量。
批次張量計算核心方法導圖
導圖把演化過程表達為帶批維度的張量:種群 X 為 N×D,目標與約束 F 為 N×M,交叉、變異、選擇、評價全部沿 N 維批次處理。變異、topk 選擇與批前向評價只需一次批次呼叫,效能指標也從單步延遲轉向候選/秒的吞吐量。