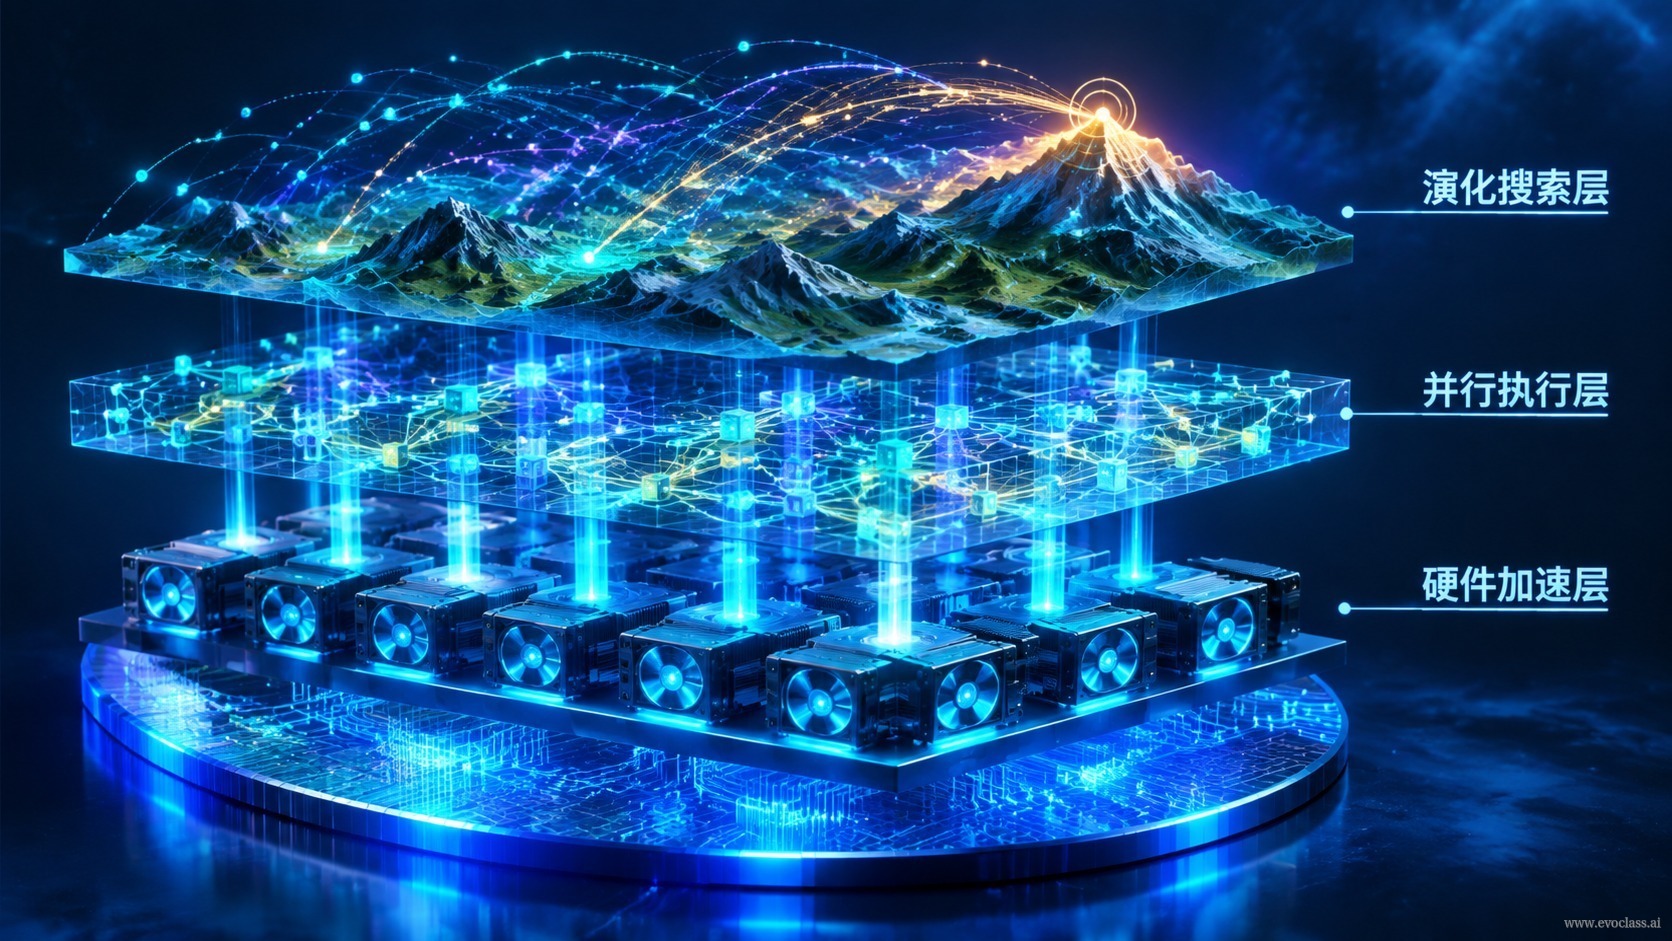
EvoX 之所以能夠支撐高強度並行演化探索,其基石可以概括為一句話:從候選列表到張量化計算圖。傳統演化實驗把每個個體當作獨立的 Python 物件,逐個建模、逐個評價;當候選規模擴大到成千上萬時,真正的瓶頸往往不再是演算法本身,而是逐候選的排程、同步與 I/O 開銷。EvoX 的做法是:把種群、評價與執行時狀態重新組織為可整體計算的張量,再由統一 Runtime 排程到 GPU 與異構算力上批次執行,從而支撐大規模、多目標、多解並行的演化搜尋。
三大張量化物件
張量化不是對某一處做局部優化,而是貫穿演化迴圈的三個層面。任何一層退回逐物件迴圈,並行度都會在那一層被卡住。
- 種群張量化:個體參數、基因或策略不再逐個 Python 物件迴圈,而是按批次維度組織為張量,個體之間的差異由張量的其中一個維度乘載。
- 評價張量化:適應度、約束、多目標指標以及模擬或模型評價結果可批次計算,同一批次內的候選共享一次裝置呼叫,顯著降低逐候選排程與 I/O 開銷。
- 狀態張量化:演化代數、隨機種子、快取與監控指標等執行時狀態被統一管理,使並行加速之後的實驗依然可重現、可追蹤。
計算圖化與統一架構
把候選列表提升為張量化計算圖之後,算子並行與編譯優化才有施展空間:種群規模與評價並行度可以隨算力擴展,而不是被直譯器迴圈鎖死。與之配套的是統一架構——演算法、問題、工作流與監視、Runtime 排程器相互解耦:演算法可組合、問題可插拔、異構算力統一管理,使用者在撰寫演算法時不必同時操心底層排程。
這一底座最直接的收益是突破串行瓶頸:替代傳統 CPU 串行迴圈,在 GPU 與異構算力上實現大規模加速,為高強度探索提供穩定的吞吐基礎;在相同的牆鐘時間內,可以探索更多候選、更多目標組合或更多隨機重複。
例如,設一次演化實驗需要評價大量候選方案。傳統做法是在 CPU 上逐個候選呼叫評價函式,排程、同步與 Python 迴圈可能主導耗時;EvoX 將候選矩陣批次送入裝置,由 Runtime 排程算子與評價,並統一記錄狀態與監視指標,使相同牆鐘時間內可探索更多候選、更多目標組合或更多隨機重複。這也正是真實世界多目標問題(例如超臨界翼型設計中巡航升阻比與臨界抖振升力係數彼此牽制)需要保留多樣化候選方案時的工程支撐。
實踐意義
當底層迴圈與排程工程被底座吸收,研究者可以把精力轉向問題建模、目標權衡與實驗假設的設計,而不必首先陷入底層迴圈與排程工程。這一分工既是高強度並行演化探索的前提,也為後續方法演化與 AI Native 科研提供工程基礎。
EvoX 現代計算底座全景生態圖圖示把 EvoX 底座概括為從候選列表升級為張量化計算圖:種群、評價與執行時狀態三層統一張量化,再由 Runtime 排程到 GPU 與異構算力批次執行。這樣演算法、問題、工作流與監視彼此解耦,算力擴展時並行度不被逐候選迴圈卡住,相同牆鐘時間可探索更多候選與目標組合。
EvoX 現代計算底座全景生態圖
圖示把 EvoX 底座概括為從候選列表升級為張量化計算圖:種群、評價與執行時狀態三層統一張量化,再由 Runtime 排程到 GPU 與異構算力批次執行。這樣演算法、問題、工作流與監視彼此解耦,算力擴展時並行度不被逐候選迴圈卡住,相同牆鐘時間可探索更多候選與目標組合。