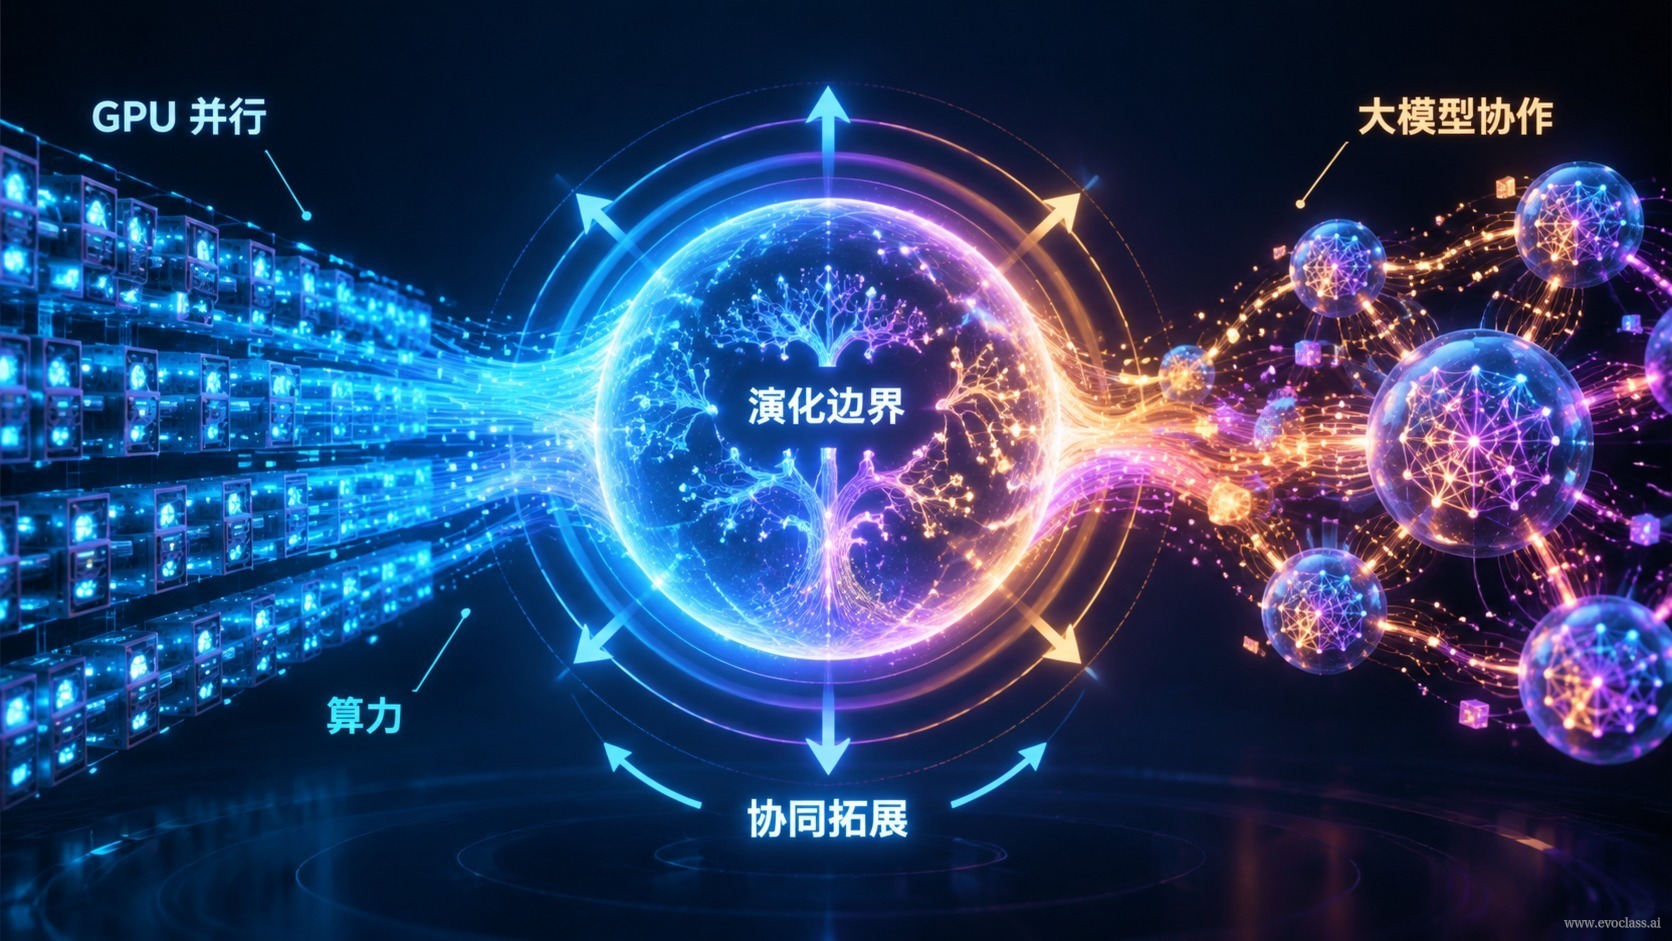
演化計算長期受制於一個現實問題:在有限時間內到底能評價多少候選。今天這一約束被兩股工程力量同時鬆動——GPU 並行算力與大模型語義生成。它們共同構成演化計算的雙重工程底座:算力決定「一次能探索多少候選」,大模型決定「能探索什麼形態的候選」,二者一起把演化對象的邊界從數值參數外擴到程序、模型結構與算法機制本身。
算力底座:把候選空間從串列搬到張量
傳統實現裡,種群評價是 CPU 上的串列迴圈:一次只處理一個個體,調度開銷隨種群規模累積。以 EvoX 為代表的開源底座把候選、評價結果與算法狀態統一組織為可整體計算的張量:變異作用於整個種群,評價與狀態更新同選擇一起進入計算圖接受編譯優化。工程上的直接結果,就是「數萬級候選同時探索」從實驗室技巧變成常規做法。
這類底座把系統劃分為算法、問題模組、工作流與 Runtime 調度器:研究者只需專注「如何演化」,Runtime 負責把批量計算調度到 GPU、加速設備或分散式叢集。需要看清的是:算力解決的是吞吐,不是「聰明」。它不判斷候選好不好,只負責把整個種群的適應度一次性算出來。它是候選空間擴張的底層支撐,但不決定候選長什麼樣。
語義底座:把候選形態從數值向量抬升到結構方案
大模型的貢獻不在算得更快,而在於它理解程式碼、領域知識與任務上下文,具備語義級生成能力。因此它可以構造結構複雜的候選——一段可直接呼叫的求解程式碼、一個代理模型的拓撲結構——而不是只輸出一個數值向量。候選的「形態」空間由此被打開。
演化對象邊界的三級外擴
- 數值參數:經典設定,種群成員是固定結構下的一組參數值。
- 程序 / 模型結構:種群成員變成可執行程式碼片段,或網路與代理模型的拓撲結構。大模型的生成能力正是這一級的入口。
- 算法機制:連「怎麼生成、怎麼評價」的流程本身也進入被演化的對象。這正是後續「用演化改進演化」(如 MetaDE、AutoPSO)得以成立的前提。
以翼型優化為例:傳統做法只能在若干預設的數值參數上做搜尋;當大模型可以讀寫求解程式碼、構造代理模型結構,而 GPU 又能批量並行評價一個種群時,搜尋對象就從「一組參數值」上移為「一套生成與評價方案本身」。
互補而非替代
兩者是互補關係:算力擴大搜尋廣度,大模型提升候選的質量與形態複雜度;缺少任一方,邊界拓展都不成立。只有算力而無語義生成,搜尋對象仍被限制在預先寫死的編碼裡;只有生成能力而無批量評價,海量候選無法在可接受時間內完成篩選。
邊界外擴的代價
邊界外擴同時引入新約束:一是評價成本上升,單次評價可能從毫秒級變成分鐘級;二是正確性驗證變難,生成的程式碼可能無法編譯,或不滿足物理與工程約束;三是「可用答案」的判定標準更模糊,需要與多目標權衡、專家決策等環節銜接。
GPU 並行與大模型協作拓展演化邊界流程圖圖示說明演化邊界外擴依賴雙重底座:GPU 與張量化 Runtime 把種群評價從串列迴圈搬到批量並行,決定一次能探索多少候選;大模型提供語義級生成,決定能構造何種形態的候選。兩者互補後,演化對象可從數值參數擴展到程序/模型結構,再進一步到算法機制,但也會帶來評價成本、正確性驗證與答案判定標準等新約束。