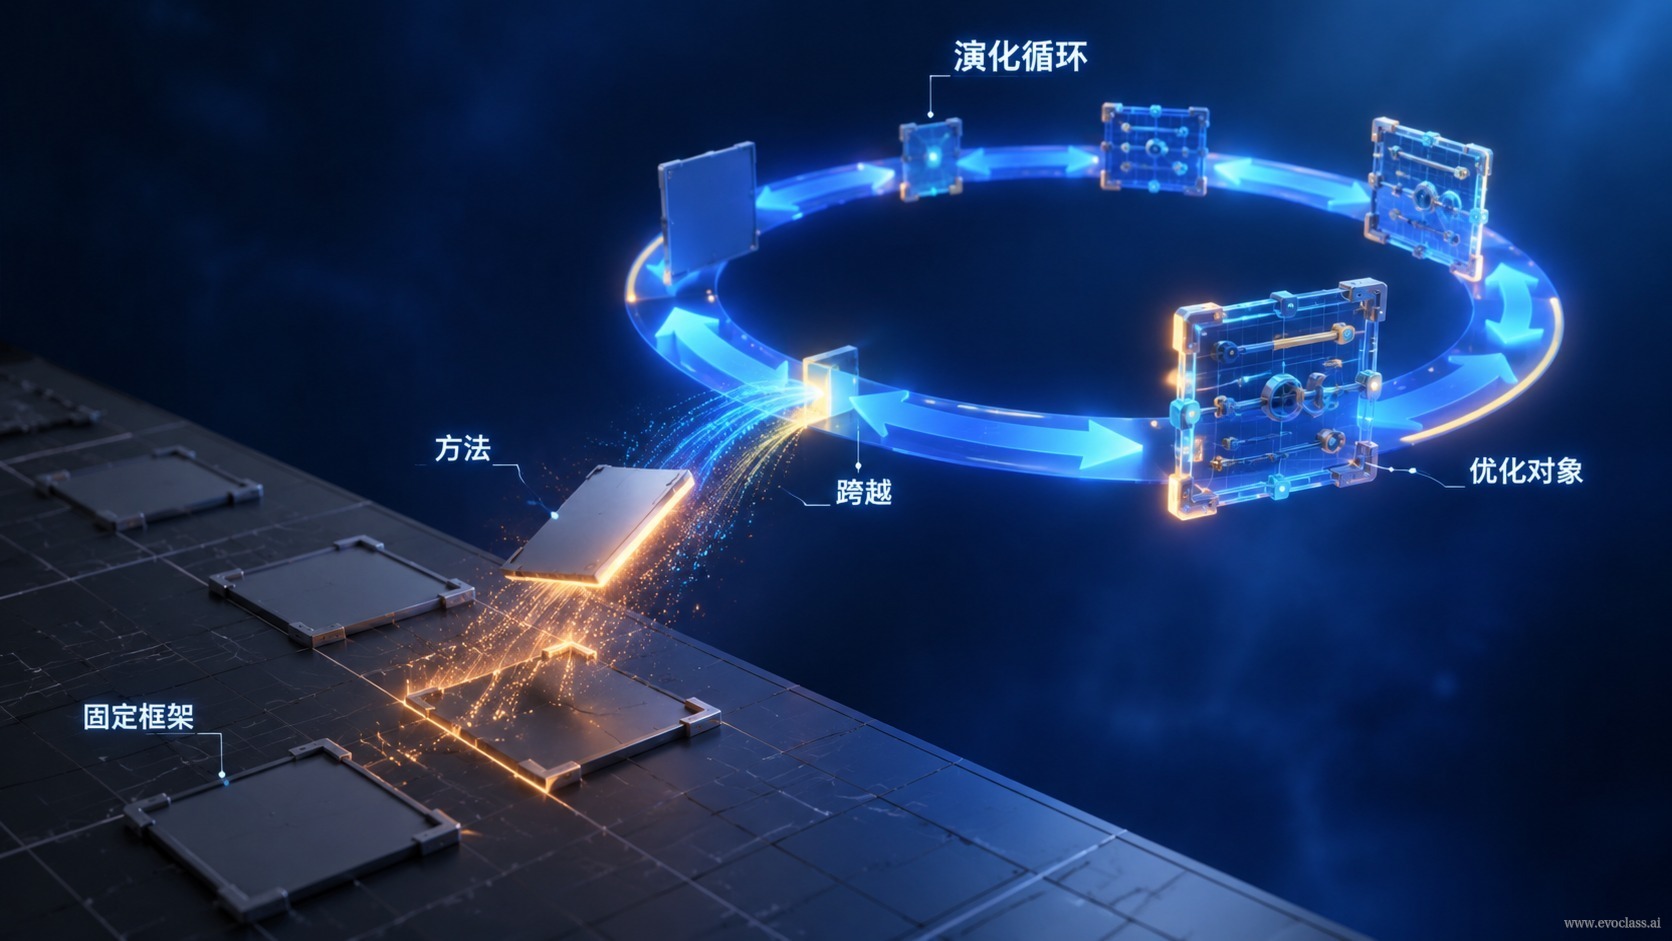
前面的課程把演化過程組織為可整體計算的張量,解決了大規模候選評價的效率問題。這一頁要再向前跨一步:如果優化的對象不只是候選答案,而是產生候選答案的方法,會發生什麼?方法演化(Meta-Evolution)的核心跨越,就是把「產生候選解的方法」本身轉化為優化對象:不再只演化答案,而是演化生成與改進答案的演算法、策略或算子,使演算法從固定工具轉變為持續進化的求解器。
一、從「演化答案」到「演化方法」
傳統路徑可以寫成一個單路鏈條:問題 → 固定演算法 → 候選解。研究者先選定演算法或算子,再讓演算法在問題空間裡搜尋,演算法本身不會改變。方法演化把鏈條改寫為:問題族/環境 → 可演化方法空間 → 候選生成器 → 候選解評價 → 方法更新 → 再生成。優化變量從解 x 擴展到方法、算子、超啟發式規則或候選生成過程 m。這裡的「方法」可以是差分演化中的變異策略、粒子群中的慣性權重與拓撲、局部搜尋算子,也可以是更上層的演算法選擇與調度規則。
二、五個關鍵轉變
- 演化對象擴展:從解、參數、結構,擴展到方法、算子、超啟發式規則或候選生成過程。
- 問題重述:優化問題由「在給定演算法下找最優解」變為「在任務或環境中演化出更會找解的求解器」。
- 回饋關係:方法產生候選並接受任務評價,評價結果反過來驅動方法的變異、選擇與重組,形成方法層與解層之間的持續回饋。
- 評價標準遷移:方法優劣不只看單次最優,而看跨任務、跨環境的泛化、魯棒性、多樣性與計算成本。
- 角色轉變:研究者不再只設計固定流程,而是設計可演化方法空間、回饋信號與選擇機制。
三、回饋閉環為什麼關鍵
方法層與解層不是兩個獨立的優化循環。方法層生成一個候選生成器,解層用它在具體任務上產生候選並得到評價;這些評價經過聚合或信用分配後,回到方法層,驅動方法本身的變異、選擇和重組。若回饋信號太稀疏或只獎勵短期最優,方法層容易過擬合到單個任務;若回饋信號包含跨任務泛化與多樣性,方法層才能學到「更會找解」的元策略。這裡可以理解為在方法空間上又開了一層演化搜尋,但它的評價離不開解層的真實表現。
四、概念基座:MetaDE 與 AutoPSO
方法演化不是停留在口號。MetaDE 讓差分演化的策略、參數甚至算子組合成為可演化對象;AutoPSO 則把粒子群的結構、參數或拓撲納入自動搜尋。它們共享同一個出發點:把「產生候選的方法」納入優化對象,實現演算法的自我進化。本頁先建立統一概念基座,具體架構與演算法結構演化將在後續展開。
關鍵區分
如果方法固定不變,系統仍然是在給定演算法下找解;只有當方法層也接受回饋並更新,才進入方法演化。
方法演化概念結構示意圖示將傳統「問題→固定演算法→候選解」的單路鏈條,擴展為「環境或問題族→可演化方法空間→候選生成器→解評價→方法更新」的閉環。優化對象從解擴展到演算法、算子與超啟發式規則,MetaDE 和 AutoPSO 是這一概念基座的具體例子。
方法演化概念結構示意
圖示將傳統「問題→固定演算法→候選解」的單路鏈條,擴展為「環境或問題族→可演化方法空間→候選生成器→解評價→方法更新」的閉環。優化對象從解擴展到演算法、算子與超啟發式規則,MetaDE 和 AutoPSO 是這一概念基座的具體例子。