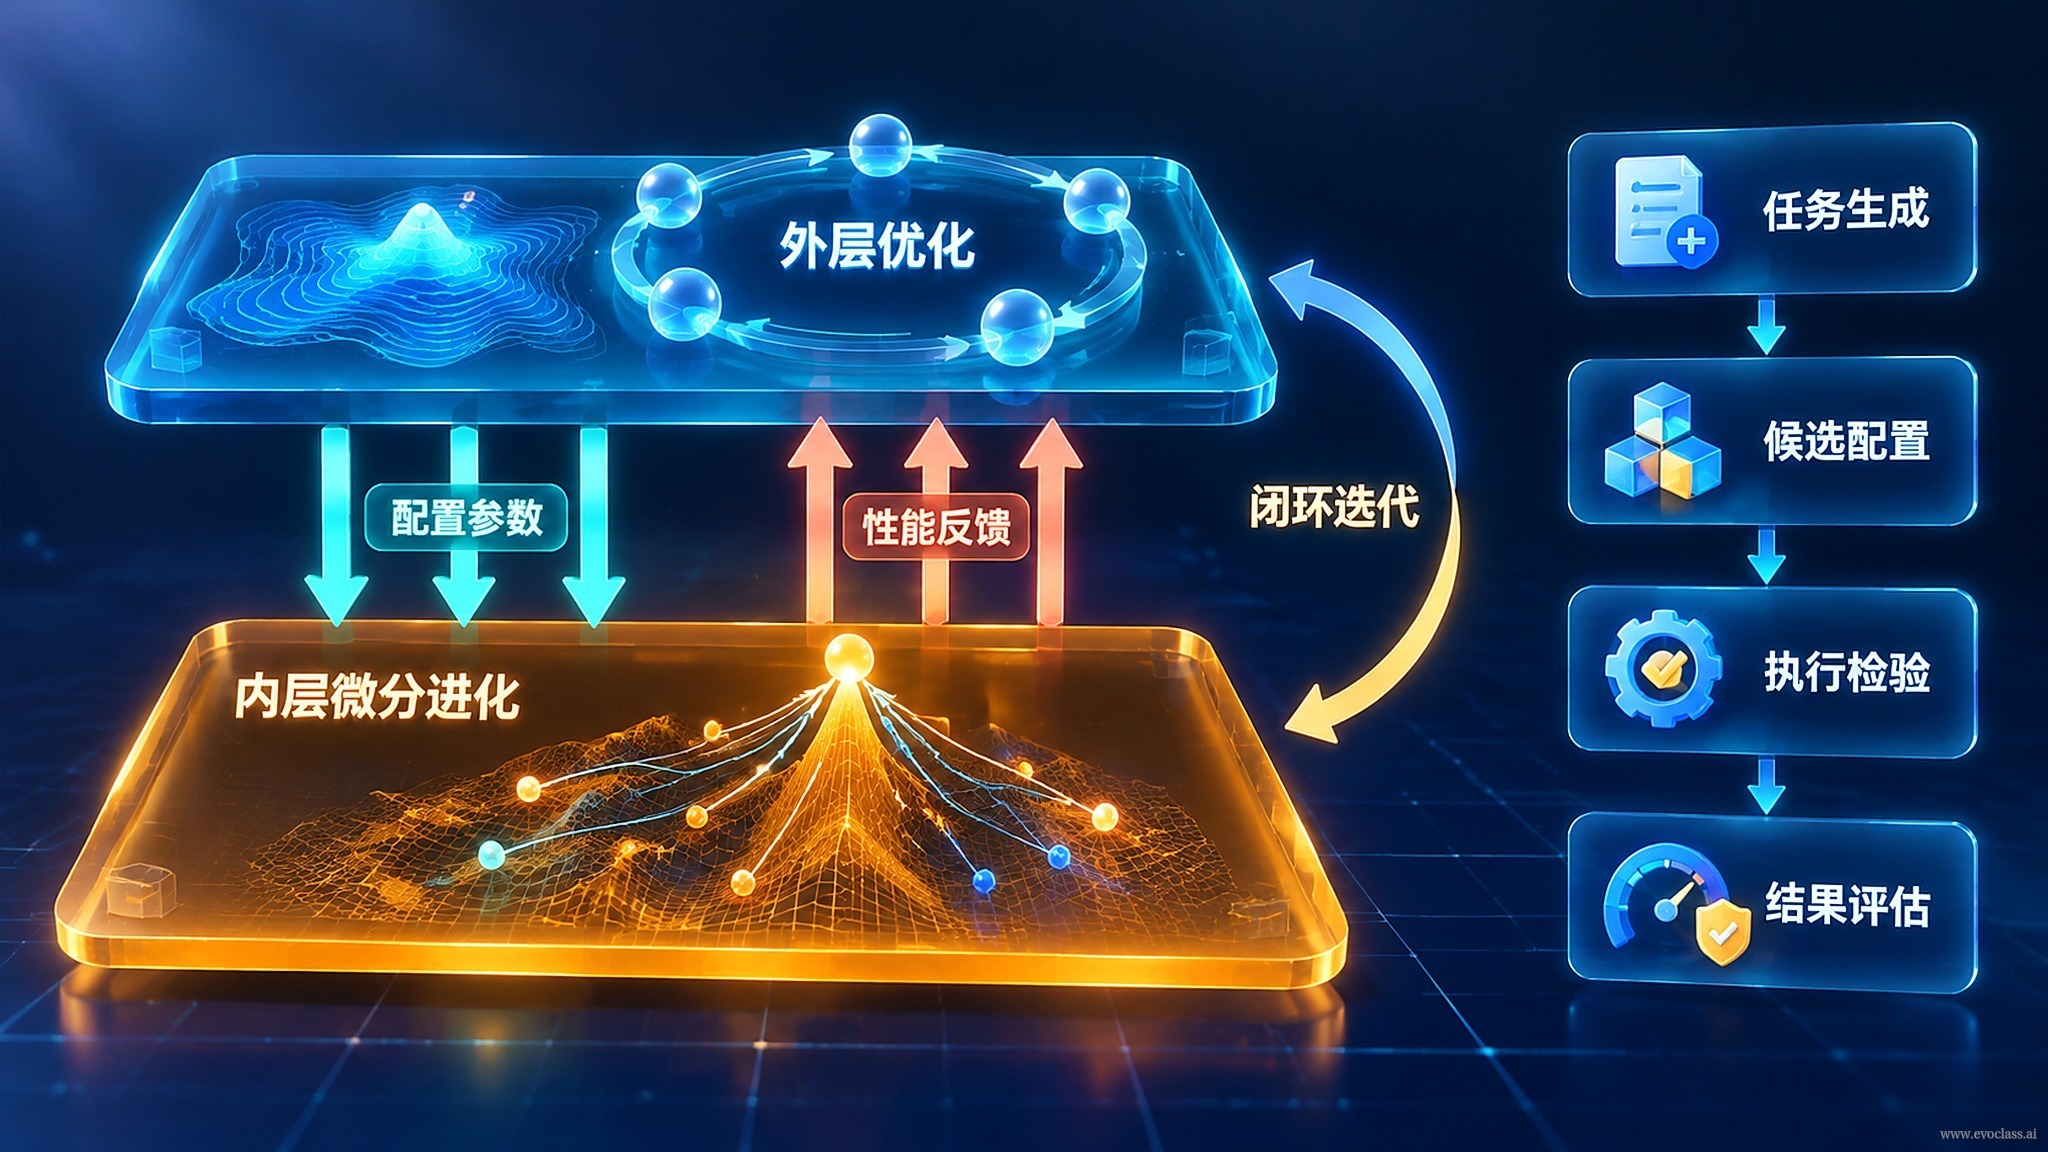
傳統的差分進化(DE)將變異策略與關鍵控制參數交由研究者預先設定,並在整個搜尋過程中保持不變。MetaDE 的核心轉變是:把演算法自身的配置也當作被演化的對象——外層演化搜尋的是演算法空間,內層評估的是解空間表現,從而把「如何演化」由人工預設轉為自適應搜尋。
雙層結構:外層搜演算法,內層解問題
- 內層:差分進化在原始優化任務上的常規求解過程,負責給出真實的任務表現。
- 外層:以一份 DE 演算法配置為一個個體,對配置空間執行選擇、交叉、變異與淘汰。
兩層的職責不能混淆:外層優化對象是演算法配置,內層優化對象是問題解。前者決定「怎麼搜」,後者決定「搜到多好」。
外層演化的是什麼
一個外層個體編碼的不是幾個數字,而是一整套演算法行為:變異策略(rand/1、best/1、current-to-best/1 等)、交叉方式(二項交叉、指數交叉),以及縮放因子 F、交叉機率 CR、族群規模等控制參數。個體之間的差異,對應的就是同一族演算法在不同問題特性下的不同行為傾向。
檢驗閉環:候選配置必須真跑一次
每一種候選配置都不能僅憑元指標或先驗判斷決定去留,必須送入原始任務實際執行,接受真實表現的檢驗;外層再依據內層回饋的適應度執行選擇、淘汰與保留,決定哪些配置被繼承與傳播。由此形成「配置生成 → 任務檢驗 → 回饋取捨」的迭代閉環,外層適應度只能來自內層的真實執行結果。
與固定 DE 的差異
傳統 DE 的策略與參數由研究者預先設定並全程固定;MetaDE 把這一決定權交給外層演化,使演算法具備對問題特性的自適應能力——例如在搜尋早期偏好探索性更強的 rand/1 與較大 F,在後期轉向收斂更快的 best/1 與較小 F。
代價與前提
每個候選配置都要完整跑一次內層任務(通常還需多次獨立執行取均值以抑制隨機性),評估成本隨外層族群規模與代數成倍放大。因此 MetaDE 對平行化、張量化與執行時調度等工程底座有強依賴——這正是它需要建立在張量化 Runtime 之上的工程原因。
定位:MetaDE 是「內外雙層演化與自適應機制」從思想走向可實現架構的具體落地,也為後續演算法結構演化(AutoPSO、EvoGO)提供了方法範式。
MetaDE 雙層結構與任務檢驗流程圖示展示 MetaDE 的雙層流程:外層以一整套 DE 配置為個體進行選擇、交叉、變異與淘汰,候選配置必須送入內層原始任務實際執行,通常多次獨立運行取平均適應度,再回饋決定保留與傳播。這樣把變異策略、交叉方式及 F、CR 等設定從人工預設轉為自適應搜尋。