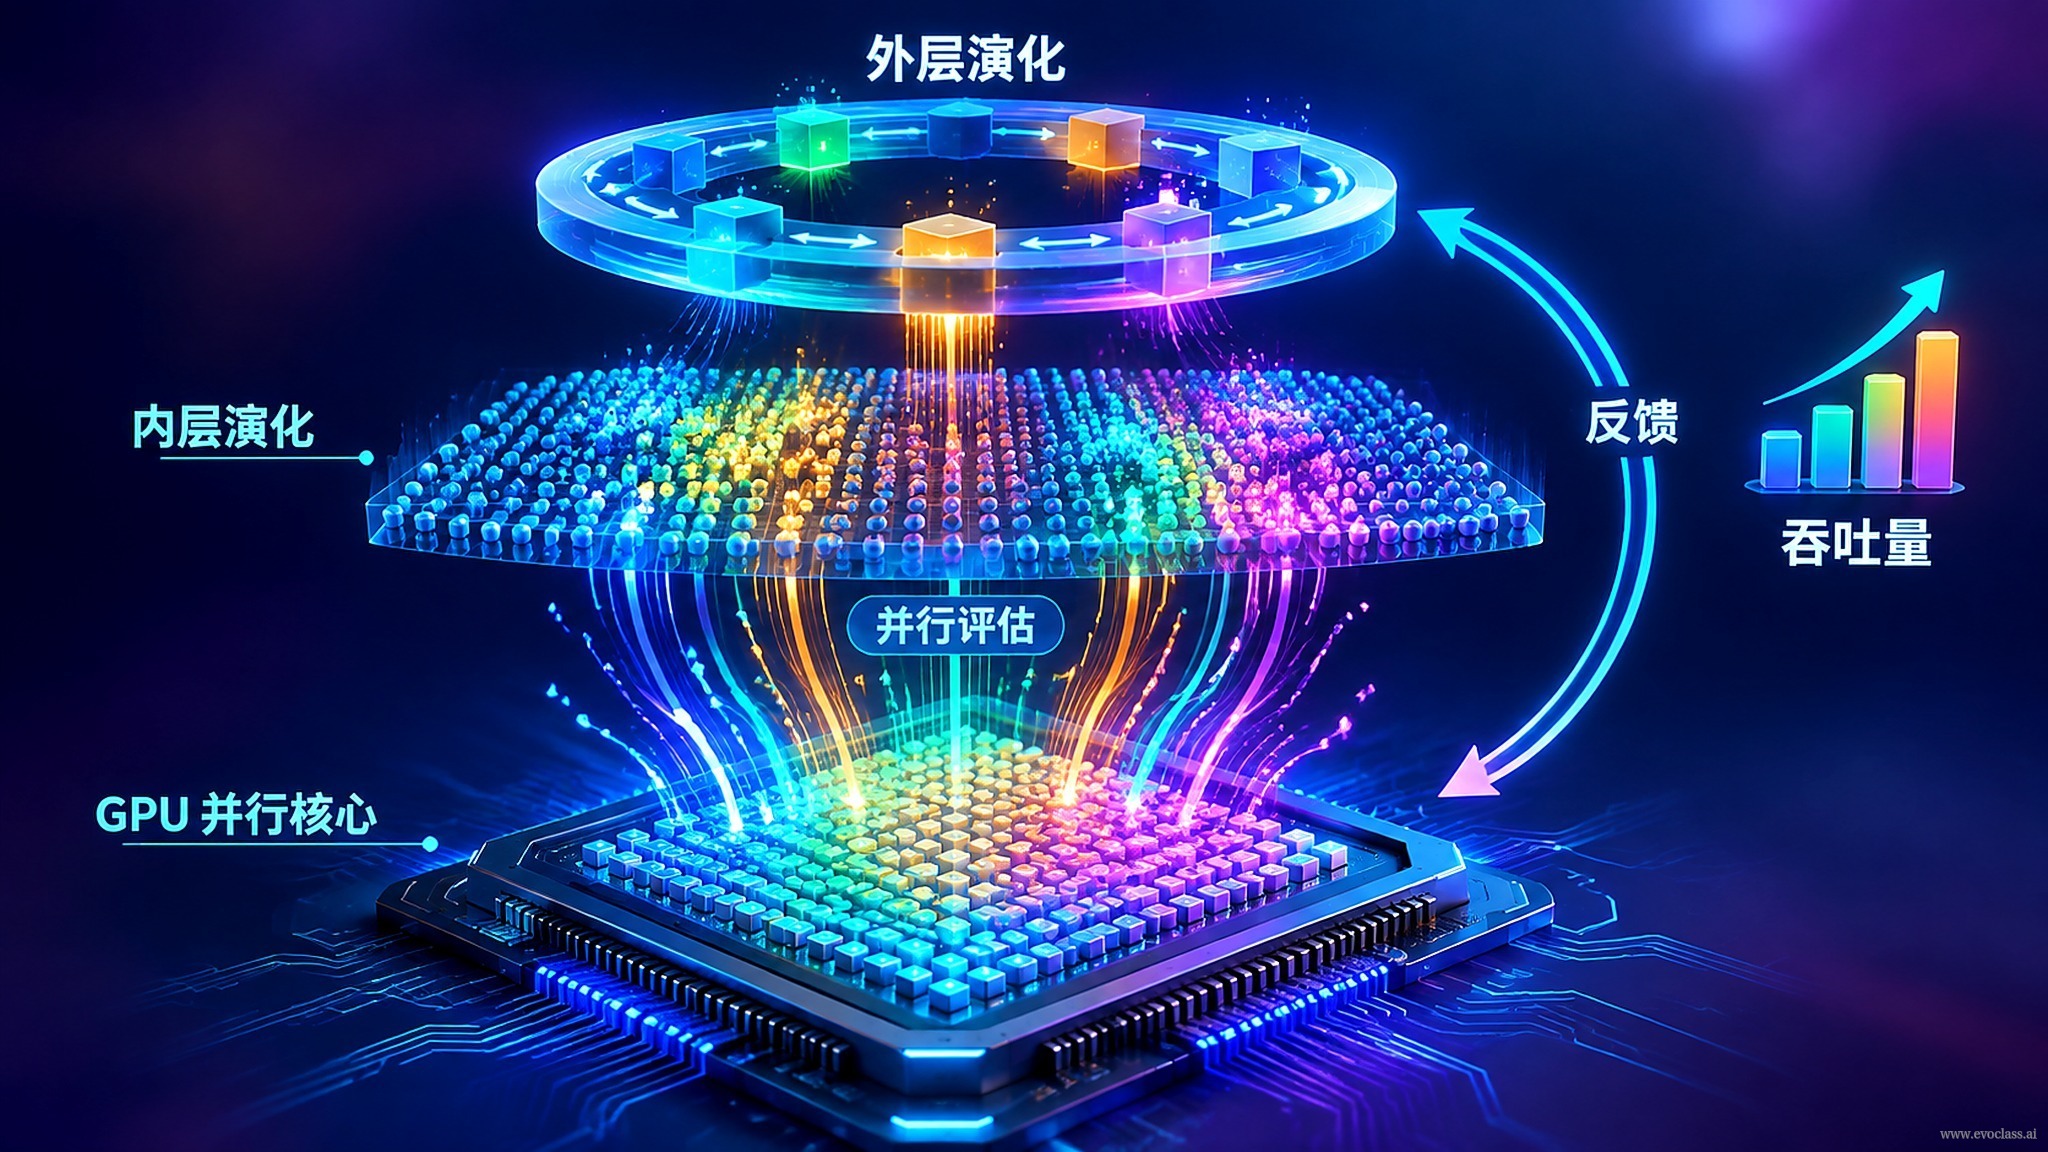
當演化演算法被用來改進演化演算法自身時,系統裡同時存在兩層運算:內層是大量演算法配置在眾多任務實例上的執行與評價,外層則依據這些執行結果選擇、變異並更新配置。若沒有強力的平行底座,外層演化會被內層的串行評價拖成瓶頸。GPU 平行正是把「用演化改進演化」從理論設想變成高吞吐可執行過程的關鍵:內層任務成批平行執行並不斷產出表現資料,外層演化以這些資料為回饋,持續選出更優的演算法配置。
兩層各司其職
- 內層(執行與評價):在 GPU 上批次執行大量候選演算法配置(不同超參數、運算子或搜尋策略),對每個任務實例完成執行與評分。任務粒度小、數量龐大,正好匹配 GPU 的批次處理吞吐特性。
- 中層(回饋匯聚):把海量內層任務的原始表現彙總為統計指標,估計每個配置在整個任務分布上的優劣,形成供外層使用的適應度。
- 外層(配置選擇):以統計回饋為輸入執行選擇、變異或更新,生成下一代配置並回送內層,構成閉環。
為什麼 GPU 平行不可替代
在傳統串行迴圈下,單輪迭代的牆鐘時間由「候選配置數量 × 任務樣本數量」共同決定,規模稍大就難以承受,串行迴圈因此成為限制候選配置與任務樣本規模的主要瓶頸。GPU 平行讓大量內層演算法同時執行,把串行迴圈從「主要瓶頸」降為「可接受的批次處理開銷」,從而同時放大可探索的配置空間與任務樣本量。
核心機制:一條閉環
整套系統可概括為 「內層任務平行吞吐 → 表現回饋匯聚 → 外層配置選擇」 的循環:平行度越高,回饋樣本越充分,外層對適應度的估計越穩定,配置改進的方向越可靠;改進後的配置再回送底層,進入下一輪平行吞吐。正是這條閉環,讓演算法具備了持續自我最佳化的能力,也讓「用演化改進演化」從理論設想變成高效可執行的過程。
易錯點
不要把兩層混淆:內層是「演算法跑任務、打出分數」,外層是「演化挑配置」。回饋只能來自內層的真實執行表現,而不是外層的隨機猜測或人為設定的常數。
GPU 平行雙層演化吞吐架構圖示展示一條閉環:內層在 GPU 上批次執行大量候選演算法配置並完成評分,中層把海量內層表現彙總為統計指標並形成適應度,外層據此選擇、變異並生成下一代配置,再回送內層。平行度越高,回饋樣本越密集,外層對配置優劣的估計越穩定,串行評價瓶頸也隨之降為可接受的批次處理開銷。
GPU 平行雙層演化吞吐架構
圖示展示一條閉環:內層在 GPU 上批次執行大量候選演算法配置並完成評分,中層把海量內層表現彙總為統計指標並形成適應度,外層據此選擇、變異並生成下一代配置,再回送內層。平行度越高,回饋樣本越密集,外層對配置優劣的估計越穩定,串行評價瓶頸也隨之降為可接受的批次處理開銷。