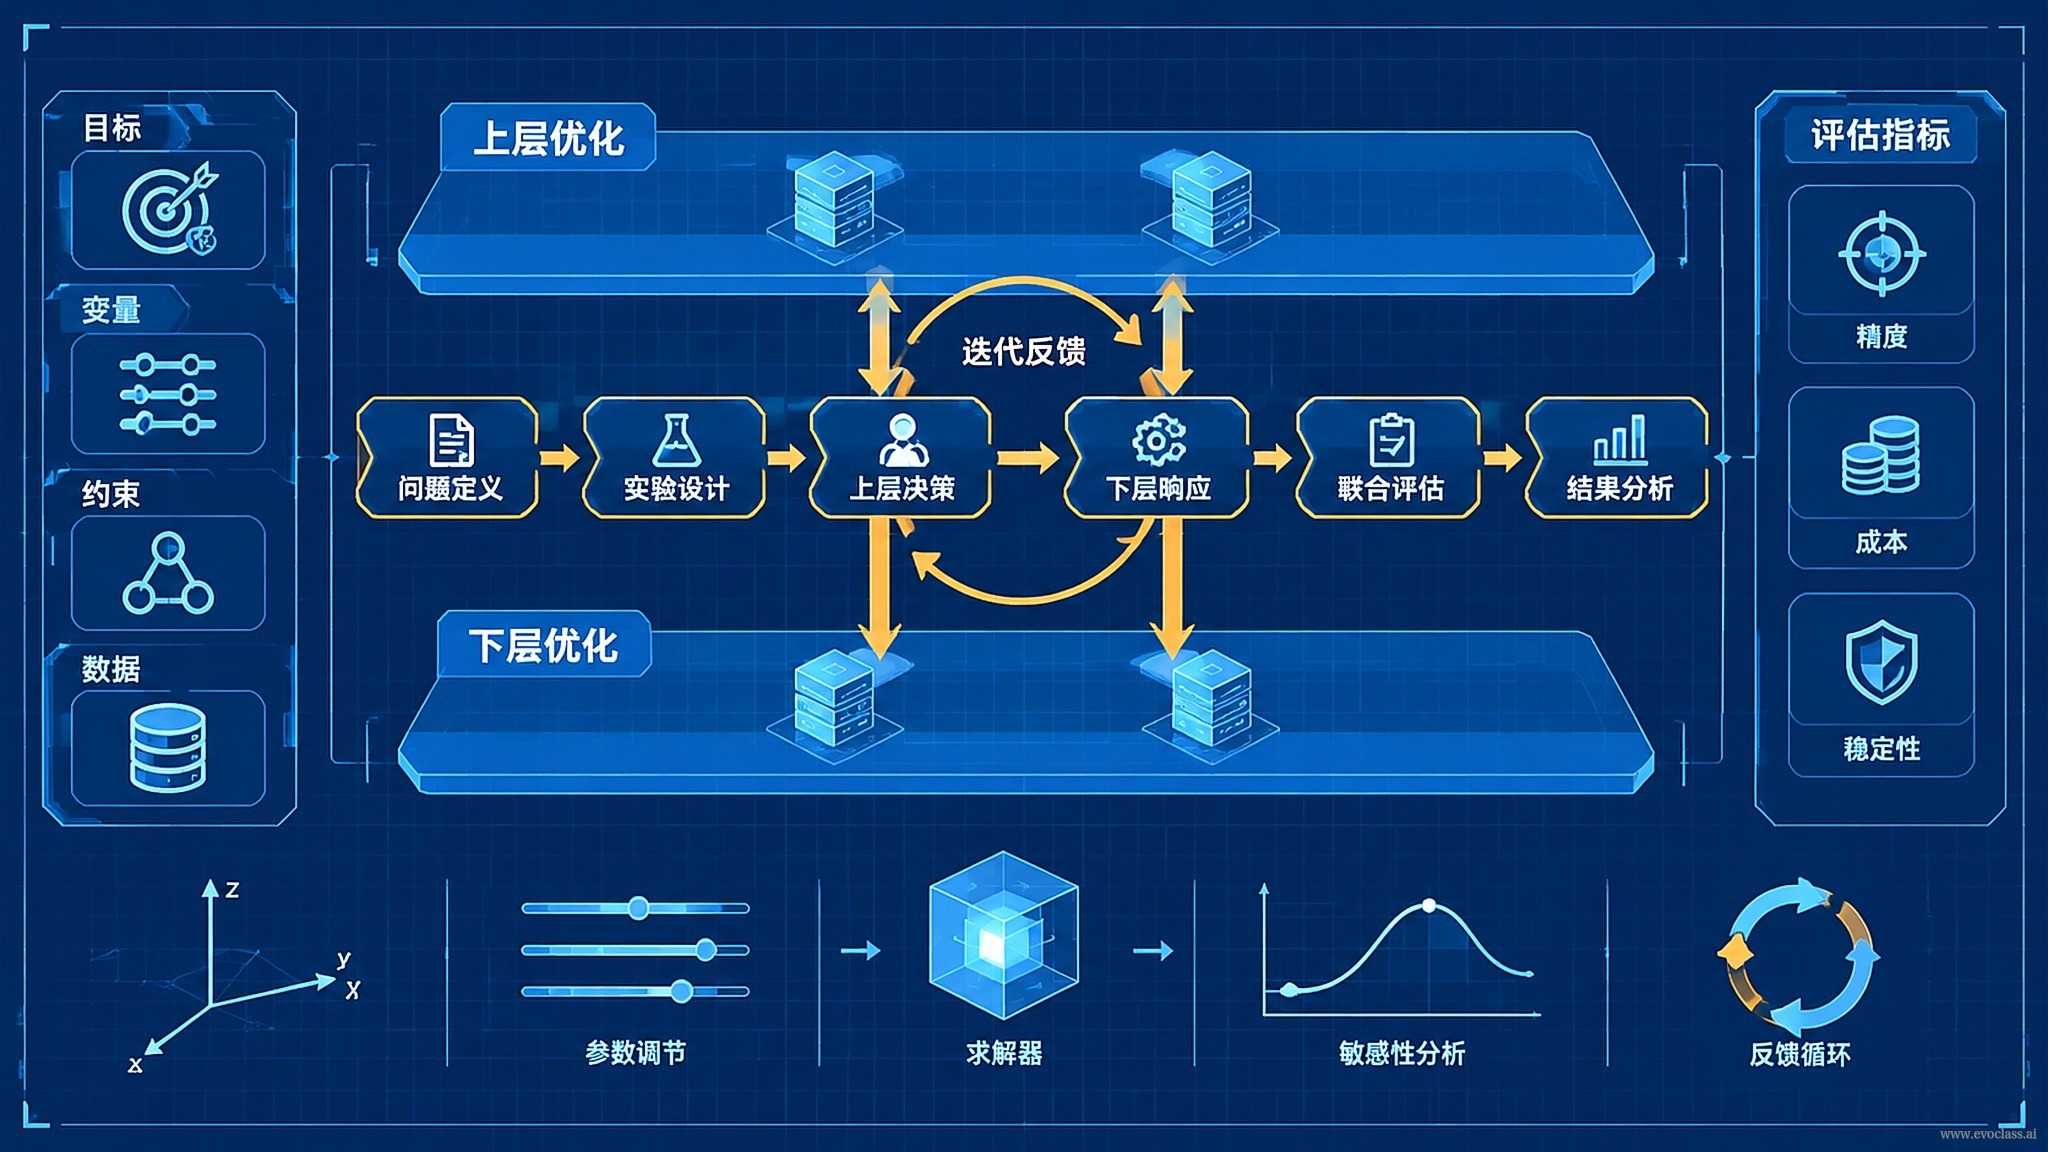
雙層最佳化實驗藍圖要回答一個具體問題:差分進化(DE)的變異因子 F 究竟應該設成多少。它的做法不是繼續手動調整,而是把 F 從固定超參數提升為外層可演化的對象,把「用某個 F 設定去跑一次 DE 求解任務」作為內層評價過程;外層依據內層的任務表現更新配置。這套藍圖之所以跑得動,是因為它建立在 EvoX 的現代運算底座之上:種群、評價結果與演算法狀態被組織為可整體計算的張量,候選配置得以批量變異、批量評價並進入計算圖接受編譯最佳化,再由 Runtime 排程器把運算派發到 GPU、加速裝置或分散式叢集,從而把原本漫長的串行實驗週期壓縮到可接受的時間視窗。
內層任務:把表現變成可比較的訊號
內層是一個可重複的實驗。先選定一個最佳化任務或基準函數集合,再把 DE 的主體結構、維度、評價預算與隨機種子集合全部鎖定——唯一變化的量,就是外層傳進來的 F 配置。每次執行都要記錄:最佳值、收斂速度(到達閾值所需的代數)、成功率、限制違反量、多目標指標(如超體積)以及候選多樣性。這些記錄就是外層能「看見」的全部資訊,也是外層判斷好壞的唯一依據。評價以張量化方式成批執行,同一批候選共用一張計算圖,避免逐個體串行評價的開銷。
外層策略對象:F 不再是一個常數
外層搜尋的不是一個數值,而是一個 F 策略。常見的編碼有三類:常數 F;分階段常數,例如基因 [F1, F2, F3] 按代數區間切換;由少量基因控制的排程函數,例如按當前成功率、種群變異數或代數比例觸發不同的 F。策略型編碼除了基因本身,還必須寫明輸入特徵與輸出規則,否則同一段基因在不同實作下會跑出完全不同的結果。
映射方式:基因型到執行時配置
從外層基因型到內層執行時配置的映射必須顯式且可重現。例如基因 [F起, F終, 衰減] 映射為隨代數衰減的排程:F(t) = F起 + (F終 − F起) × e^(−衰減 × t / T),其中 t 為當前代數、T 為總代數;基因 [F1, F2, F3] 映射為三段常數切換。同一個基因型必須永遠映射到同一個執行時配置,否則外層學到的「好基因」無法解釋,也無法遷移到新任務。
閉環流程與必錄日誌
完整迴路是:外層種群生成一批 F 配置 → Runtime 排程器按張量化批次並行派發內層 DE 任務 → GPU 批量評價 → 彙總指標 → 外層選擇、變異、交叉與更新 → 進入下一輪。這裡沿用 EvoX 的分層組織:演算法層承載外層的演化與內層的 DE 邏輯,問題模組提供基準任務,Runtime 排程器負責把批量運算派發到 GPU 或分散式叢集,監視模組回收指標。閉環上必須留下可重放的記錄:隨機種子、評價預算、任務 ID、硬體型號與停止條件。任何一次「外層勝出」的結論,都應該能在同樣條件下重跑出來。
邊界條件與基線:三層防護
雜訊防護:內層評價波動大時,單次執行的結果不可信,必須多次獨立執行並報告信賴區間;適應度可用均值、中位數或最差分位數聚合,同時把訓練任務與驗證任務分開,防止外層只對某幾個幸運種子過擬合。成本防護:內層任務昂貴時,先用低保真模型或代理評價做粗篩,再對少數候選做高保真複評。基線防護:固定 F = 0.5 與經典自適應 DE 必須同臺比較,並用消融實驗確認收益來自外層演化本身,而不是來自更多評價次數。若外層搜尋空間過小,雙層最佳化會退化成手動調參;此時應該擴大編碼空間,而不是單純加大預算。
雙層最佳化實驗藍圖與流程圖示以差分進化變異因子 F 為例:內層鎖定任務、維度、評價預算與隨機種子,只讓外層傳入的 F 策略變化,並記錄最佳值、收斂速度、成功率、限制違反量、超體積與候選多樣性;外層可編碼常數 F、分段 F 或排程函數,經顯式映射後批量評價並選擇更新。閉環還需保留種子、預算、任務 ID、硬體與停止條件,以保證結論可重跑。