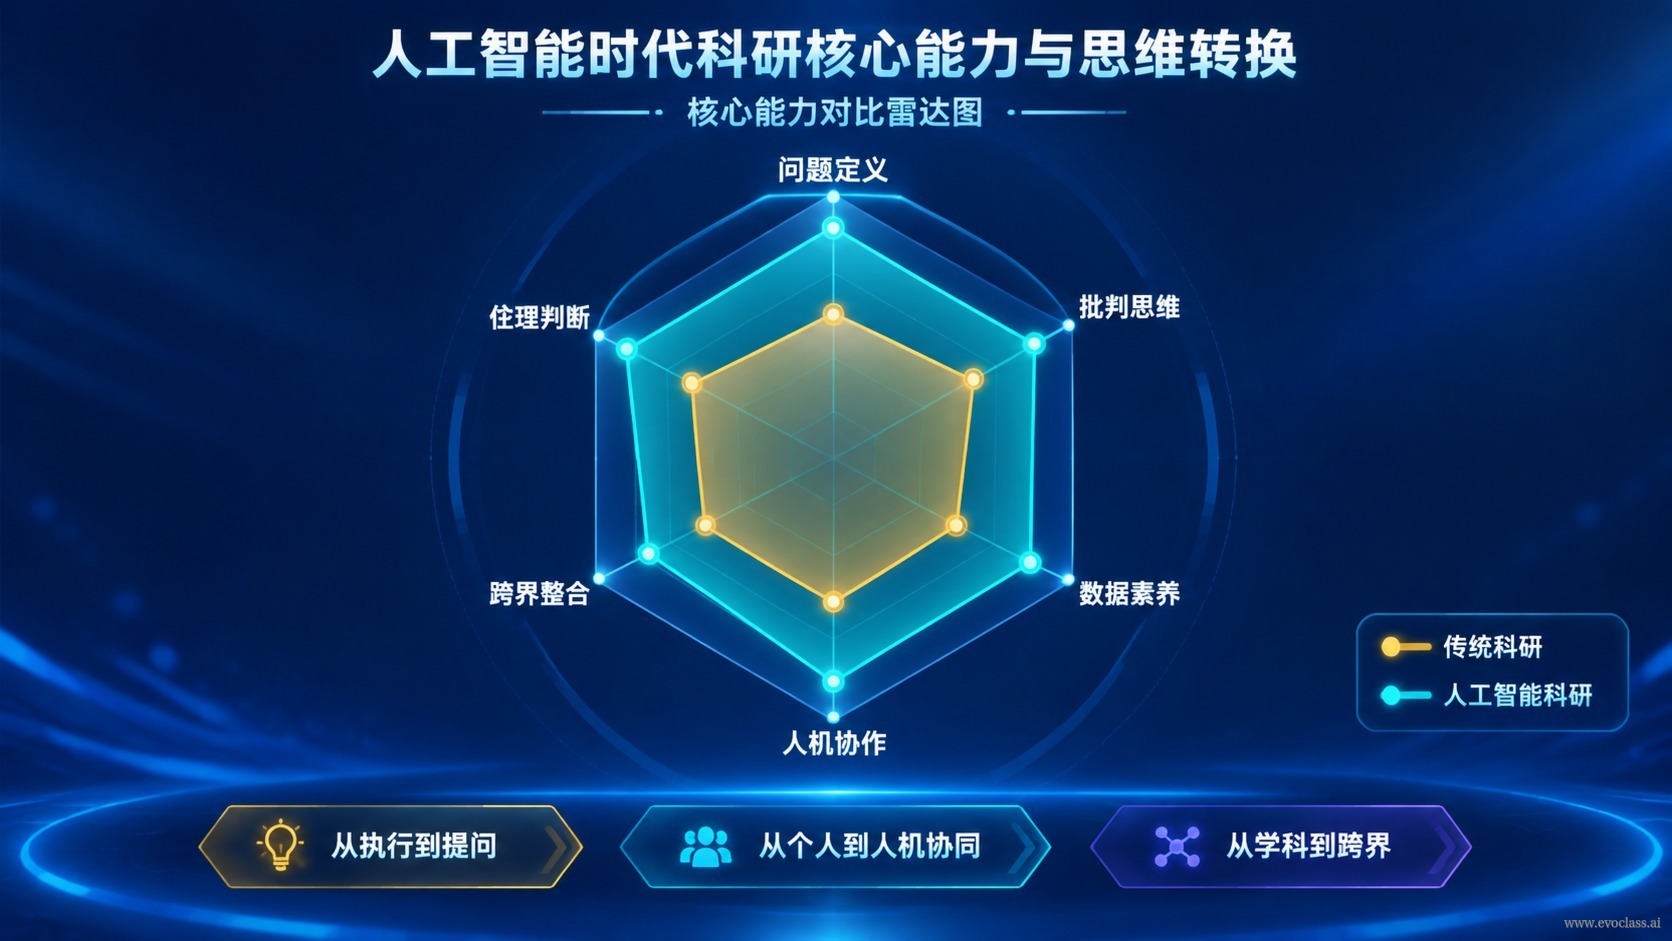
在 AI 輔助科研中,研究者的核心能力正在經歷一次思維轉換:過去我們用「能否親手寫出實作」來衡量能力,如今程式碼與實驗腳本可由 AI 快速產出,真正稀缺的是提出關鍵問題、定義評價與公平比較標準,並對 AI 產出的證據做批判性判斷。
職責遷移:從實作者到證據仲裁者
當實作成本被大幅壓低,研究者的角色從「實作者」上移為問題定義者、實驗設計者與證據仲裁者。AI 負責把想法變成可運行的答案,而「什麼問題值得回答、什麼證據值得相信」仍由研究者決定。
- 問題定義者:判斷哪一類問題具有科學價值,而不是哪一類問題最容易出結果。
- 實驗設計者:把模糊的想法轉成可執行、可重現、可比較的實驗協議。
- 證據仲裁者:對 AI 給出的曲線、指標與結論保持懷疑,追問其可信邊界與失敗條件。
三類必須由人回答的關鍵問題
- 改變對象:這次要動的是優化參數、程式實作、演算法結構,還是研究流程本身?改動所處的層級不同,結論的意義也完全不同。
- 評價回饋:用什麼指標觀測、用什麼代理訊號近似真實目標、驗收門檻設在哪裡、什麼情況判為失敗——四者缺一不可。
- 公平比較:基線、預算、隨機性、算力條件與統計檢驗是否對齊。不對齊的比較,常把隨機波動或算力優勢誤讀為演算法進步。
為什麼「品味」至關重要
AI 可以生成大量「能跑」的方案,但可行不等於有價值。Taste matters:在眾多可行方案中判斷哪個問題、哪個假設、哪份證據真正具有科學價值,這正是人類研究者的核心價值。相應地,能力重心從單純的編碼速度,轉向批判性思維、系統抽象、領域判斷與人機分工。
案例:EvoX / MetaDE 類任務
AI 可以在一天內生成幾十個變異算子變體與配套實驗腳本。但研究者必須決定:是改進變異算子、優化評價流程,還是重構搜尋空間?並據此設定多目標指標與公平基線。否則得到的只是「能跑」的結果,而不是可信的知識。
核心能力遷移這張圖用能力對比的方式呈現 AI 時代科研能力的重心遷移:當實作可被快速產出,研究者更關鍵的價值轉向提出關鍵問題、設計可重現實驗、判斷證據邊界,並保證基線、預算與統計檢驗的公平對齊。
核心能力遷移
這張圖用能力對比的方式呈現 AI 時代科研能力的重心遷移:當實作可被快速產出,研究者更關鍵的價值轉向提出關鍵問題、設計可重現實驗、判斷證據邊界,並保證基線、預算與統計檢驗的公平對齊。