傳統演化計算以低維、預定義的數值參數向量為主要對象,例如超參數、權重與連續變數,其搜尋空間由人工預設的結構與編碼方式限定。當計算規模與工程底座擴大後,高維、離散、結構化對象的搜尋從不可行變為可處理,搜尋邊界隨算力與工具鏈同步外擴。
在此基礎上,大模型具備程式碼理解、上下文推理與候選生成能力,可以直接構造、修改並評估程式級對象,降低對手工設計編碼方式與變異算子的依賴。當算力規模打開後,若產生候選的方法仍由人工預先固定,系統便只能重複既定套路;把候選生成的方法本身納入演化對象(例如差分進化的變異策略與參數設定),正是這一邊界擴展在方法層面的直接體現。
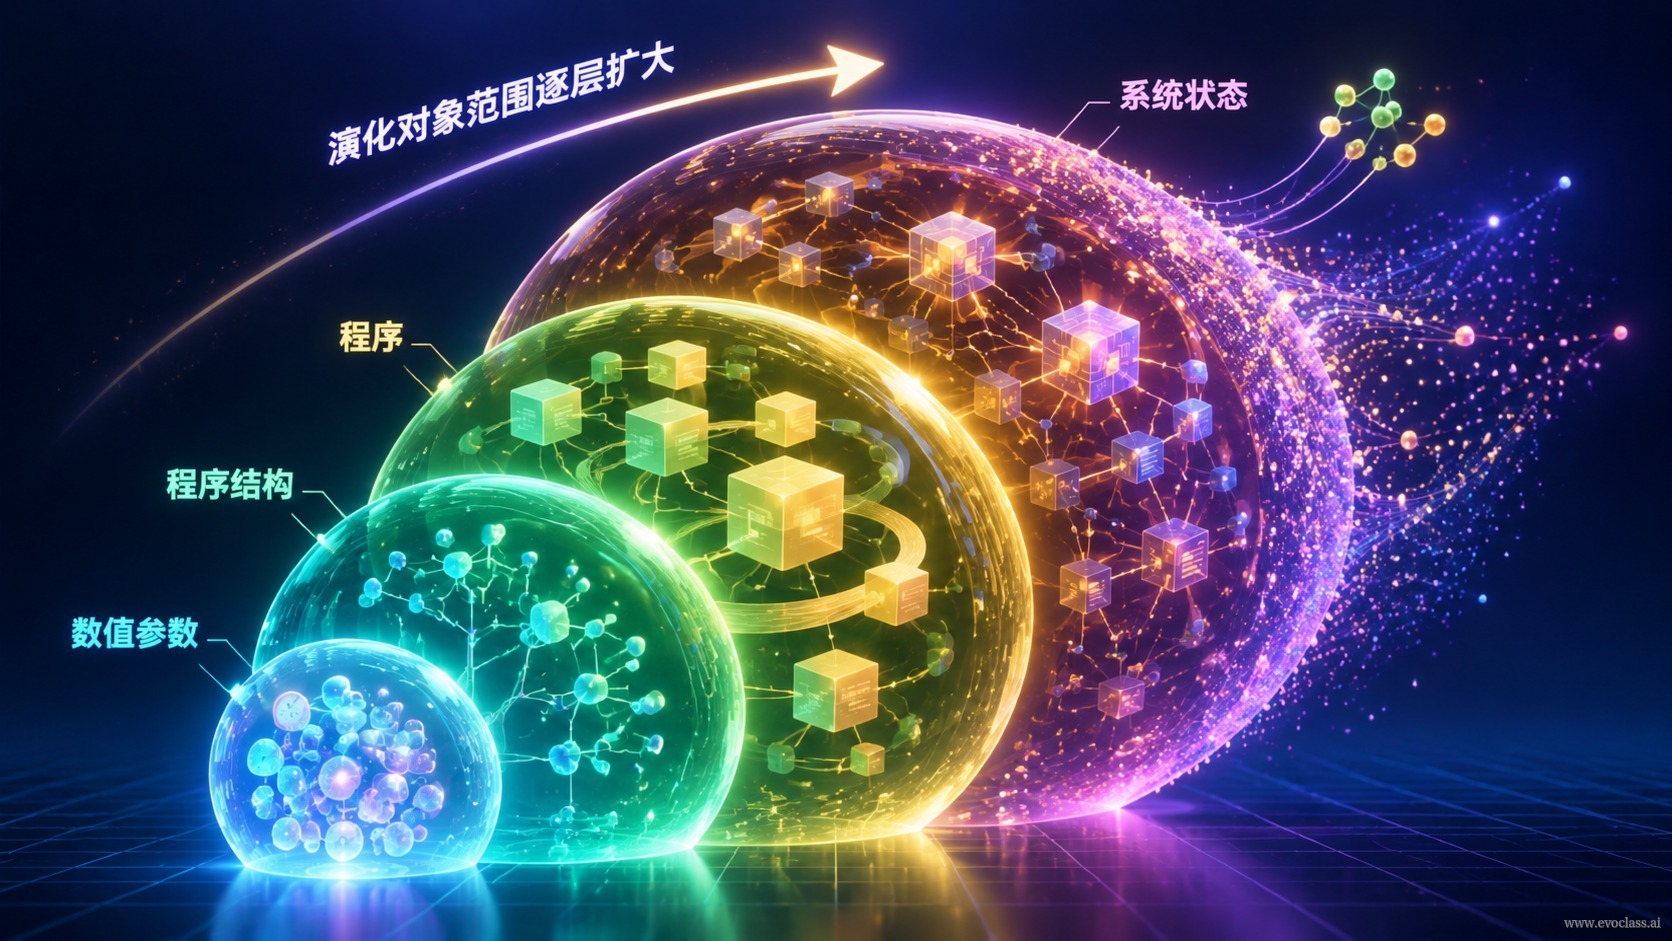
下圖給出這一層級擴展的結構。
由此,演化對象呈現層級擴展:數值參數 → 模型結構 → 演算法機制 → 程式與軟體工程狀態。層級越高,語意約束越強、評價鏈路越長:候選必須可執行、可驗證,適應度評估也從純量函數變為執行結果與工程約束的聯合判斷。這一擴展並非替代參數最佳化,而是把參數最佳化納入更大的程式與系統演化循環,形成從局部調參到系統級改進的連續譜。
演化對象由數值參數向程式系統擴展的層級圖圖中自下而上展示演化對象的層級擴展:數值參數、模型結構、演算法機制,直至程式與軟體工程狀態。層級越高,語意約束越強、評價鏈路越長,候選必須可執行可驗證,適應度也從純量函數變為執行結果與工程約束的聯合判斷,參數最佳化由此被納入更大的程式演化循環。
演化對象由數值參數向程式系統擴展的層級圖
圖中自下而上展示演化對象的層級擴展:數值參數、模型結構、演算法機制,直至程式與軟體工程狀態。層級越高,語意約束越強、評價鏈路越長,候選必須可執行可驗證,適應度也從純量函數變為執行結果與工程約束的聯合判斷,參數最佳化由此被納入更大的程式演化循環。