當種群規模從幾十擴展到成千上萬,演化計算的真正瓶頸就不再是「能否找到好解」,而是「能否在有限時間內評估足夠多的候選」。EvoX 給出的工程答案是兩條互相支撐的主線:張量化計算把逐個體串行迴圈改寫成批量張量運算,統一架構則把演算法、問題、工作流與 Runtime 排程解耦,使這套並行機制可以複用到不同的演化演算法與任務上。
為什麼多樣性需要吞吐
演化搜尋依賴種群多樣性:候選越分散,跳出局部最優的機率越高。但「維持多樣性」本質上是一道算力題——它要求每一代都能對大量候選完成評價與狀態更新。如果產生候選的方法仍由人工預先固定、評價仍按個體逐個執行,系統就只能反覆走既定套路,多樣性帶來的收益會被計算吞吐的瓶頸抵消。
方法演化:把「產生候選的方法」也納入演化
當算力規模打開後,EvoX 把優化物件向上推進一層:不再只求解問題,而是把產生候選解的方法本身納入演化物件,這就是方法演化。以 MetaDE 為例,內層演算法解決實際任務,外層演算法則演化內層演算法的配置與策略(例如差分演化的變異策略與超參數),並透過 GPU 並行執行大量內層任務,讓任務表現反過來指導外層配置的選擇;AutoPSO 與 EvoGO 進一步透過組合粒子群元件、利用歷史回饋學習候選生成方式,實現從「改參數」到「改演算法結構」的跨越。這種內外雙層演化天然要求同一代、乃至同一時刻有大量內層任務被批量評價與狀態更新,因此對計算吞吐與並行能力提出更高要求。
張量化計算圖:把迴圈換成批量張量
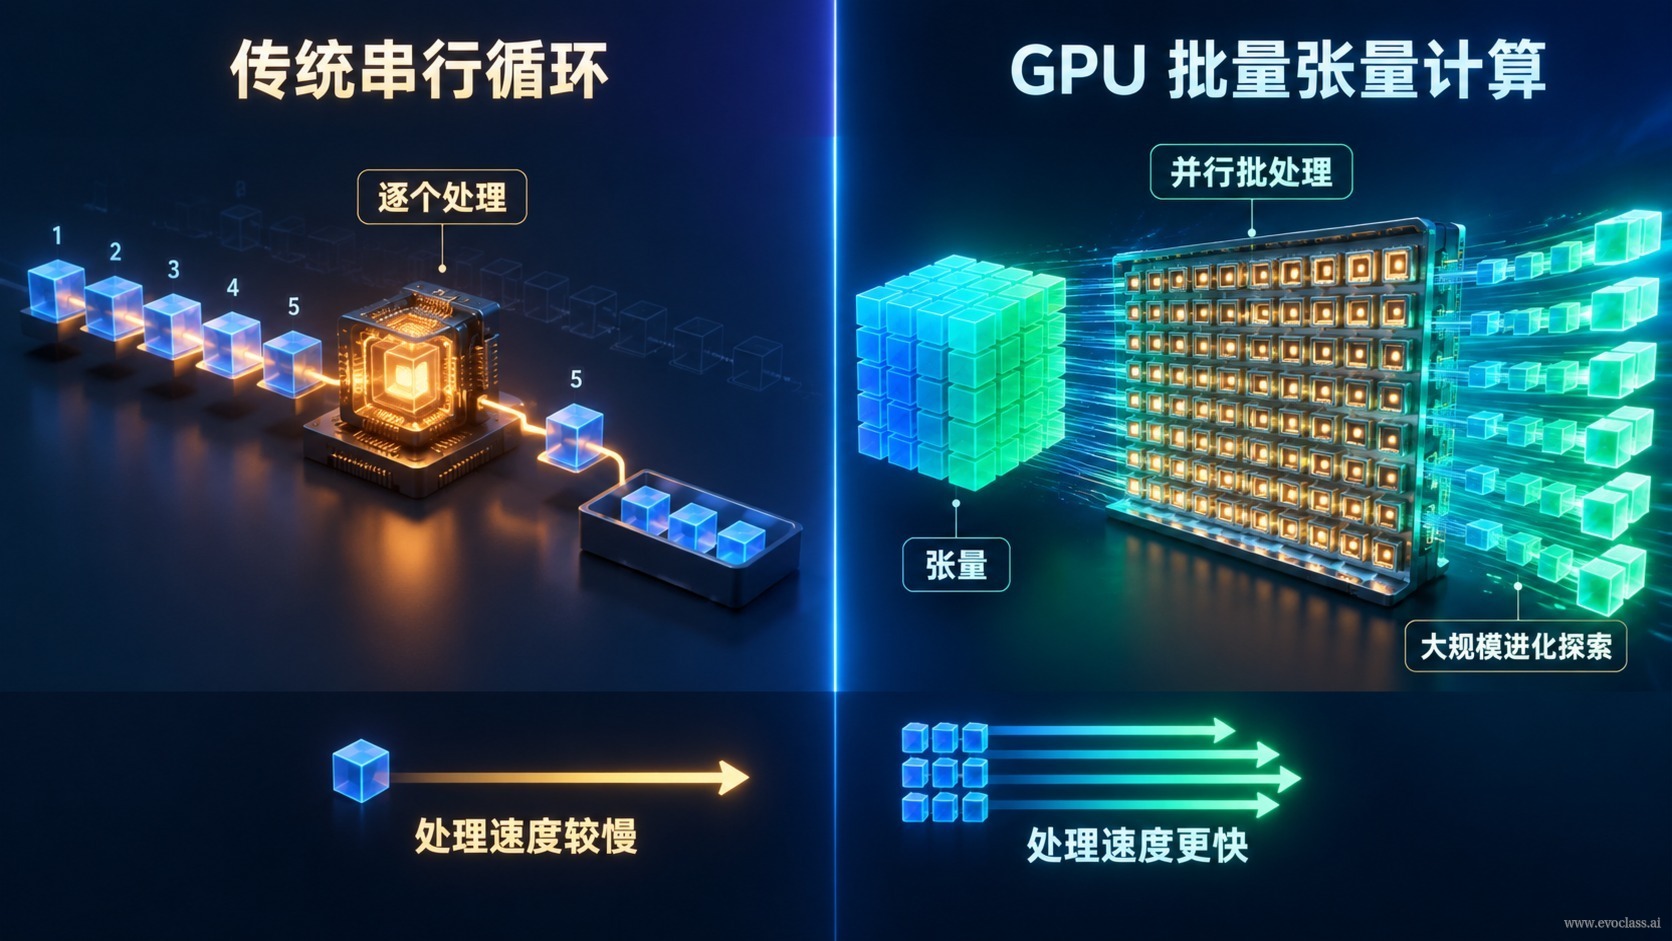
傳統串行 CPU 迴圈通常按個體執行「評價—記錄—更新」,每次只觸發小規模算子,隨之產生三類代價:排程開銷高、算子碎片化、GPU 利用率不足。張量化計算圖的做法是把種群維護、批量評價與狀態更新整體組織為批量張量操作,讓同一代甚至多代候選被並行計算。舉例來說:同一代包含 N 個候選解時,串行實現按個體迴圈,而張量化實現把種群組織成一個張量,一次性完成批量評價與並行狀態更新,從而顯著降低排程開銷、提升 GPU 佔用率。
統一架構:讓並行機制可複用
只把迴圈改寫為張量還不夠——如果演算法、問題與排程邏輯彼此耦合,換一個演化演算法或換一類任務就要重寫一遍。統一架構透過把演算法、問題、工作流、Runtime 排程等模組解耦,使張量化並行機制能夠複用於不同演化演算法與任務(如 MetaDE、AutoPSO 等方法演化場景);配合異構算力排程,可對 CPU、GPU 等資源進行批量任務級管理,從而支撐可組合、可擴展的並行探索。
為什麼這是「底座」級能力
GPU 與大模型帶來的工程底座,使張量化批量計算從局部優化上升為支撐系統級演化探索的基礎能力。換句話說,張量化解決的是「跑得快」,開放解耦的統一架構解決的是「換得動」:前者提供吞吐,後者提供可組合、可擴展的複用邊界。二者結合,才讓高強度、高多樣性的並行演化探索真正落地為工程能力。
串行迴圈與GPU批量張量計算架構對比圖左側傳統CPU串行按個體執行「評價—記錄—更新」,只觸發小規模算子,帶來排程開銷高、算子碎片化與GPU利用率不足;右側把種群維護、批量評價與狀態更新整體組織為張量運算,一次完成同代乃至多代候選的計算,並與Runtime排程解耦,使並行機制可複用於不同演算法與任務。