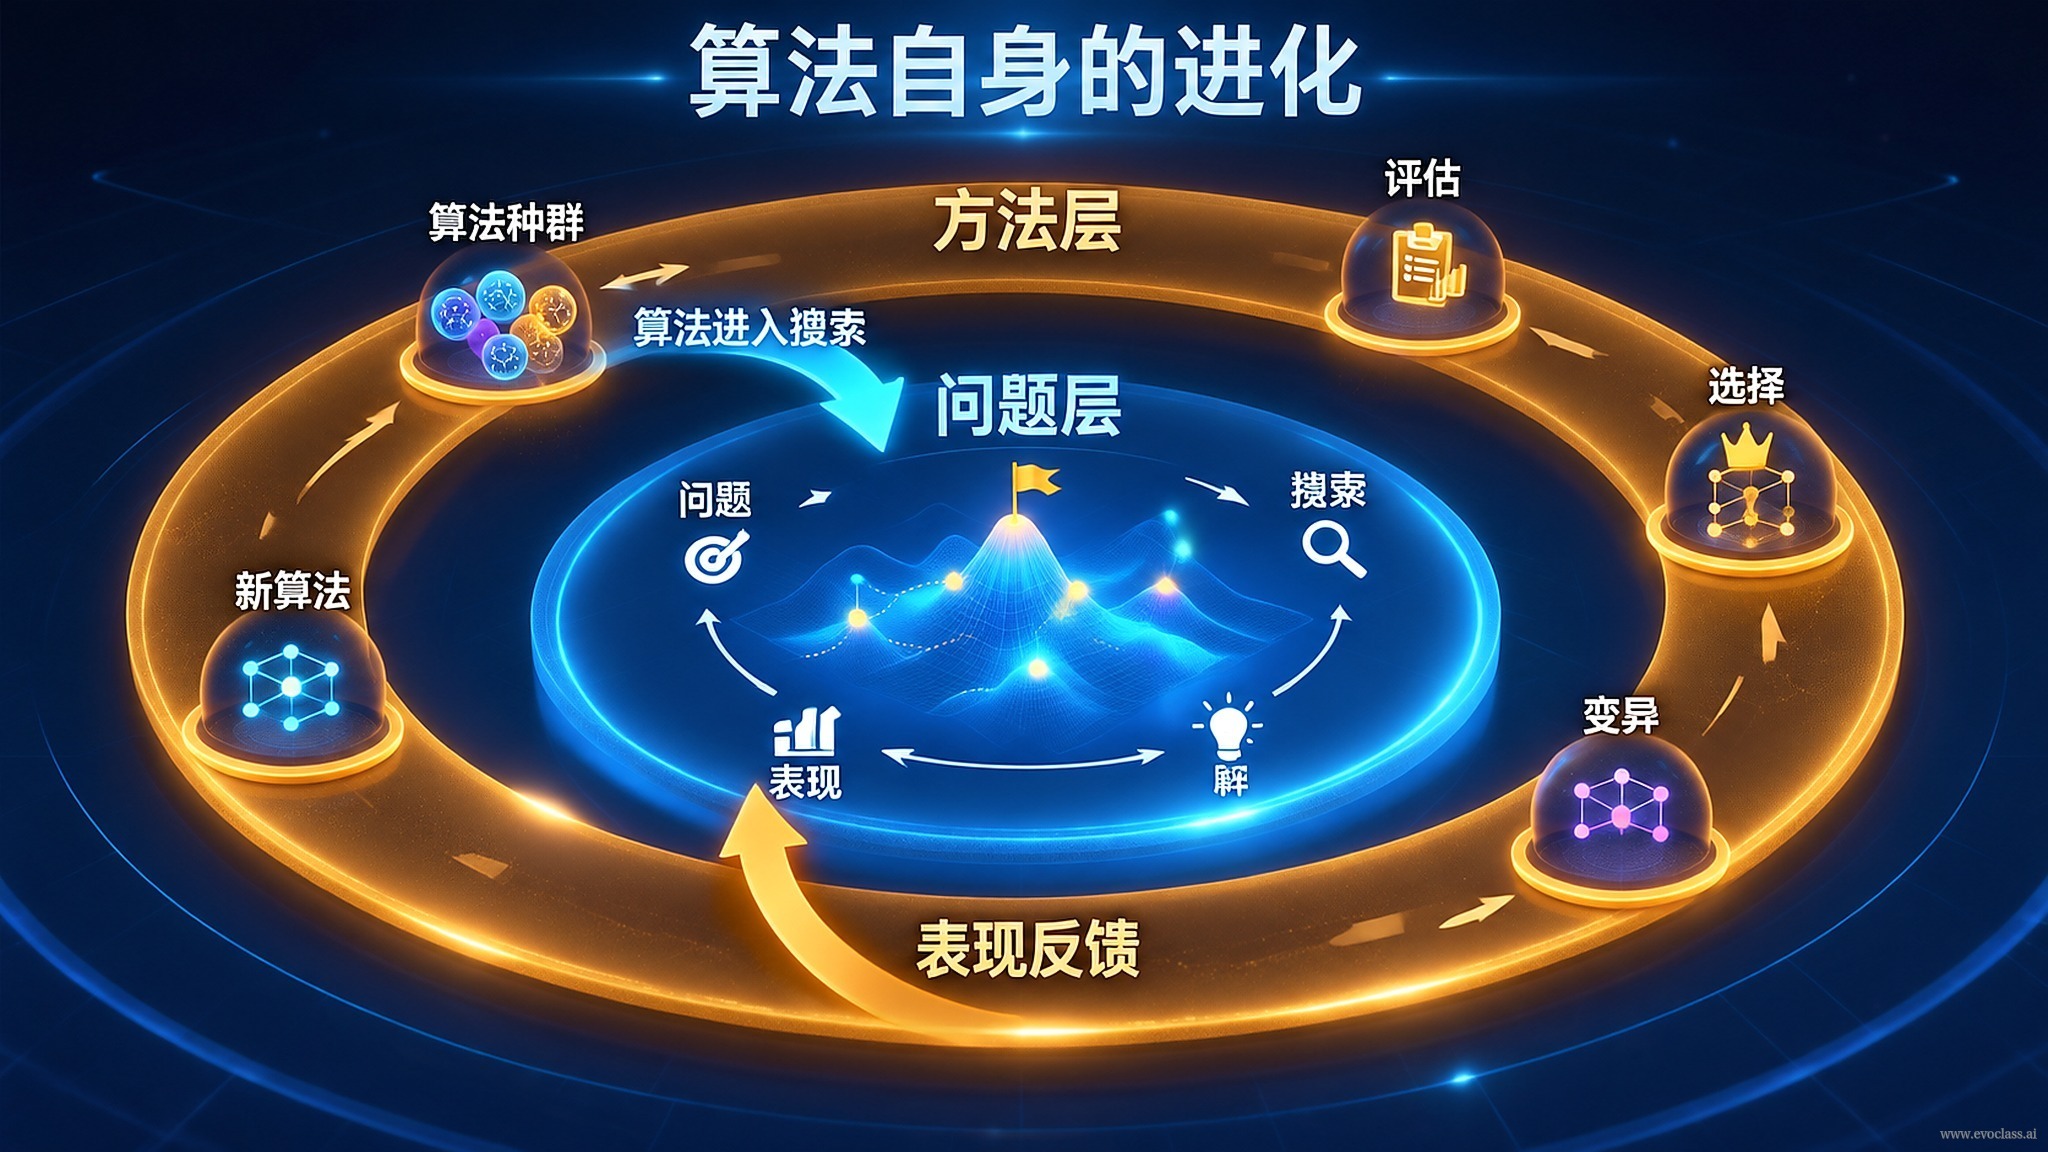
傳統的演化演算法在固定的生成機制下運作:選擇、交叉、變異等「如何產生答案」的規則由人預先寫好,搜尋只在答案空間中移動,被最佳化的始終是候選解。當算力規模打開之後,這種預設反而成了天花板——如果產生候選的方法不變,系統只能重複既定套路。
方法演化(Meta-Evolution)把問題向上推進一層:演算法不只輸出更好的答案,還透過外層搜尋持續改進產生答案的策略、參數與元件,完成從「求解答案」到「改進方法」的進化。EvoX 正是沿這條路線推進的工作,它把候選生成的方法本身(如差分進化的變異策略與參數設定)納入演化對象。
兩層邏輯:內層求答案,外層改方法
- 內層:用當前方法求解具體問題,產生候選解。
- 外層:依據解品質、偏好訊號、穩定性或成本等回饋,改進下一輪使用的方法。
- 被上移到搜尋空間的對象不是某個解,而是候選生成機制本身;正因如此,它才成為可評價、可選擇、可更新的對象。
偏好最佳化該放在哪一層
偏好最佳化可以參與上層回饋,但必須把兩類目標分開:評價當前答案與改進生成答案的方法。把「這個解更討喜」直接讀成「這個策略更優」,就是用答案偏好冒充方法優劣,外層搜尋會被單次結果的雜訊牽著走。
典型形態
MetaDE 讓外層演化差分進化的變異策略與參數,內層照常求解任務;AutoPSO 與 EvoGO 進一步組合粒子群元件、利用歷史回饋學習候選生成方式,實現了從「改參數」到「改演算法結構」的跨越。
換來什麼,付出什麼
這一轉變把演算法設計從一次性人工調參推向可持續自適應,但代價同樣清楚:搜尋空間膨脹(方法空間遠大於解空間)、評估成本上升(每套候選方法都要跑內層任務,通常依賴 GPU 平行批次評估來攤薄)、驗證複雜度增加(外層改進是否真的泛化,需要獨立的驗證設計)。
雙層演化邏輯框圖圖示把演化分為內外兩層:內層用當前方法求解具體問題並產生候選解,外層依據解品質、偏好、穩定性或成本等回饋,改進下一輪生成候選的策略、參數與元件;被搜尋的對象由此從解上移為候選生成機制。
雙層演化邏輯框圖
圖示把演化分為內外兩層:內層用當前方法求解具體問題並產生候選解,外層依據解品質、偏好、穩定性或成本等回饋,改進下一輪生成候選的策略、參數與元件;被搜尋的對象由此從解上移為候選生成機制。