大模型已經能夠穩定承擔強理解、生成與工具調用三類核心工作:把模糊需求解析為結構化任務、產出程式碼與文件、按需調用檢索與模擬工具。因此,把大模型作為智能組件接入科研與工程流程,已經是現實可用的做法。
但必須區分兩件事:能力增長與系統適應。模型再強,也只是某一次調用中的能力;真實的工程項目往往持續數月乃至數年,而單個 Agent 的上下文終會耗盡。如果經驗無法沉澱,每一輪工作都要從零開始,能力增長也就不會自動轉化為系統的長期適應能力。
一、能力組件:大模型究竟提供了什麼
- 理解:把目標、約束與上下文解析為可執行的任務描述。
- 生成:產出候選假設、程式碼、實驗設計與文件。
- 工具調用:連接檢索、計算、編譯與模擬等外部資源。
這三類能力回答的是「單次任務能不能做對」,卻回答不了「長期任務能不能持續做對」。
二、把單次能力變成持續演化能力
要在真實世界中長期適應,智能組件必須被放進一個系統級閉環。由於單個 Agent 的上下文終會耗盡,而項目又要跨越多個任務週期持續存在,就需要把演化對象擴展為持續存在的軟體世界,並依賴項目級持久化讓經驗不隨單次實驗丟失。這個閉環至少包含四個環節:
- 候選產生:由智能組件提出假設、修改或實現;此刻它們只是候選,不是結論。
- 真實檢驗:候選必須經過真實環境、模擬或實驗的檢驗,並跨過編譯、測試、行為檢查與上層驗收等關卡。
- 成果沉澱:只有通過檢驗的有效結果才被寫入被接納的項目版本,成為可複用的資產。
- 再演化:後續工作繼承已沉澱的成果,在其基礎上繼續提出候選,進入下一輪循環。
Genesis 這類多 Agent 協作系統就是該閉環的一個實例:參與工作的 Agent 生命週期有限,上層執行者理解目標並遞迴拆解任務,下層執行者完成局部實現與測試,必要時繼續向下遞迴;候選修改僅作為候選提交,必須通過編譯、測試、行為檢查與上層驗收才被接納,失敗嘗試被拒絕,通過驗證的成果則寫入項目版本,成為後續執行者的歷史基礎。在編譯器重構與科學軟體升級等場景中,這種機制展現出極高的可靠性和運行加速比。
三、關鍵區分:組件與系統閉環
因此,「大模型能力」與「持續演化系統」是組件與系統的關係,而不是替代關係。能力組件負責在單點產生高質量的候選;系統閉環負責判定哪些候選值得留下、如何留下、以及如何被下一輪繼承。缺少閉環,能力越強只會產生更多未被檢驗的候選;缺少強組件,閉環則缺少高質量的候選來源。
常見誤區
把「模型能力提升」直接等同於「系統能長期適應」。判斷標準不是模型在某次任務中表現多好,而是有效成果能否被穩定沉澱,並被下一輪工作繼承。
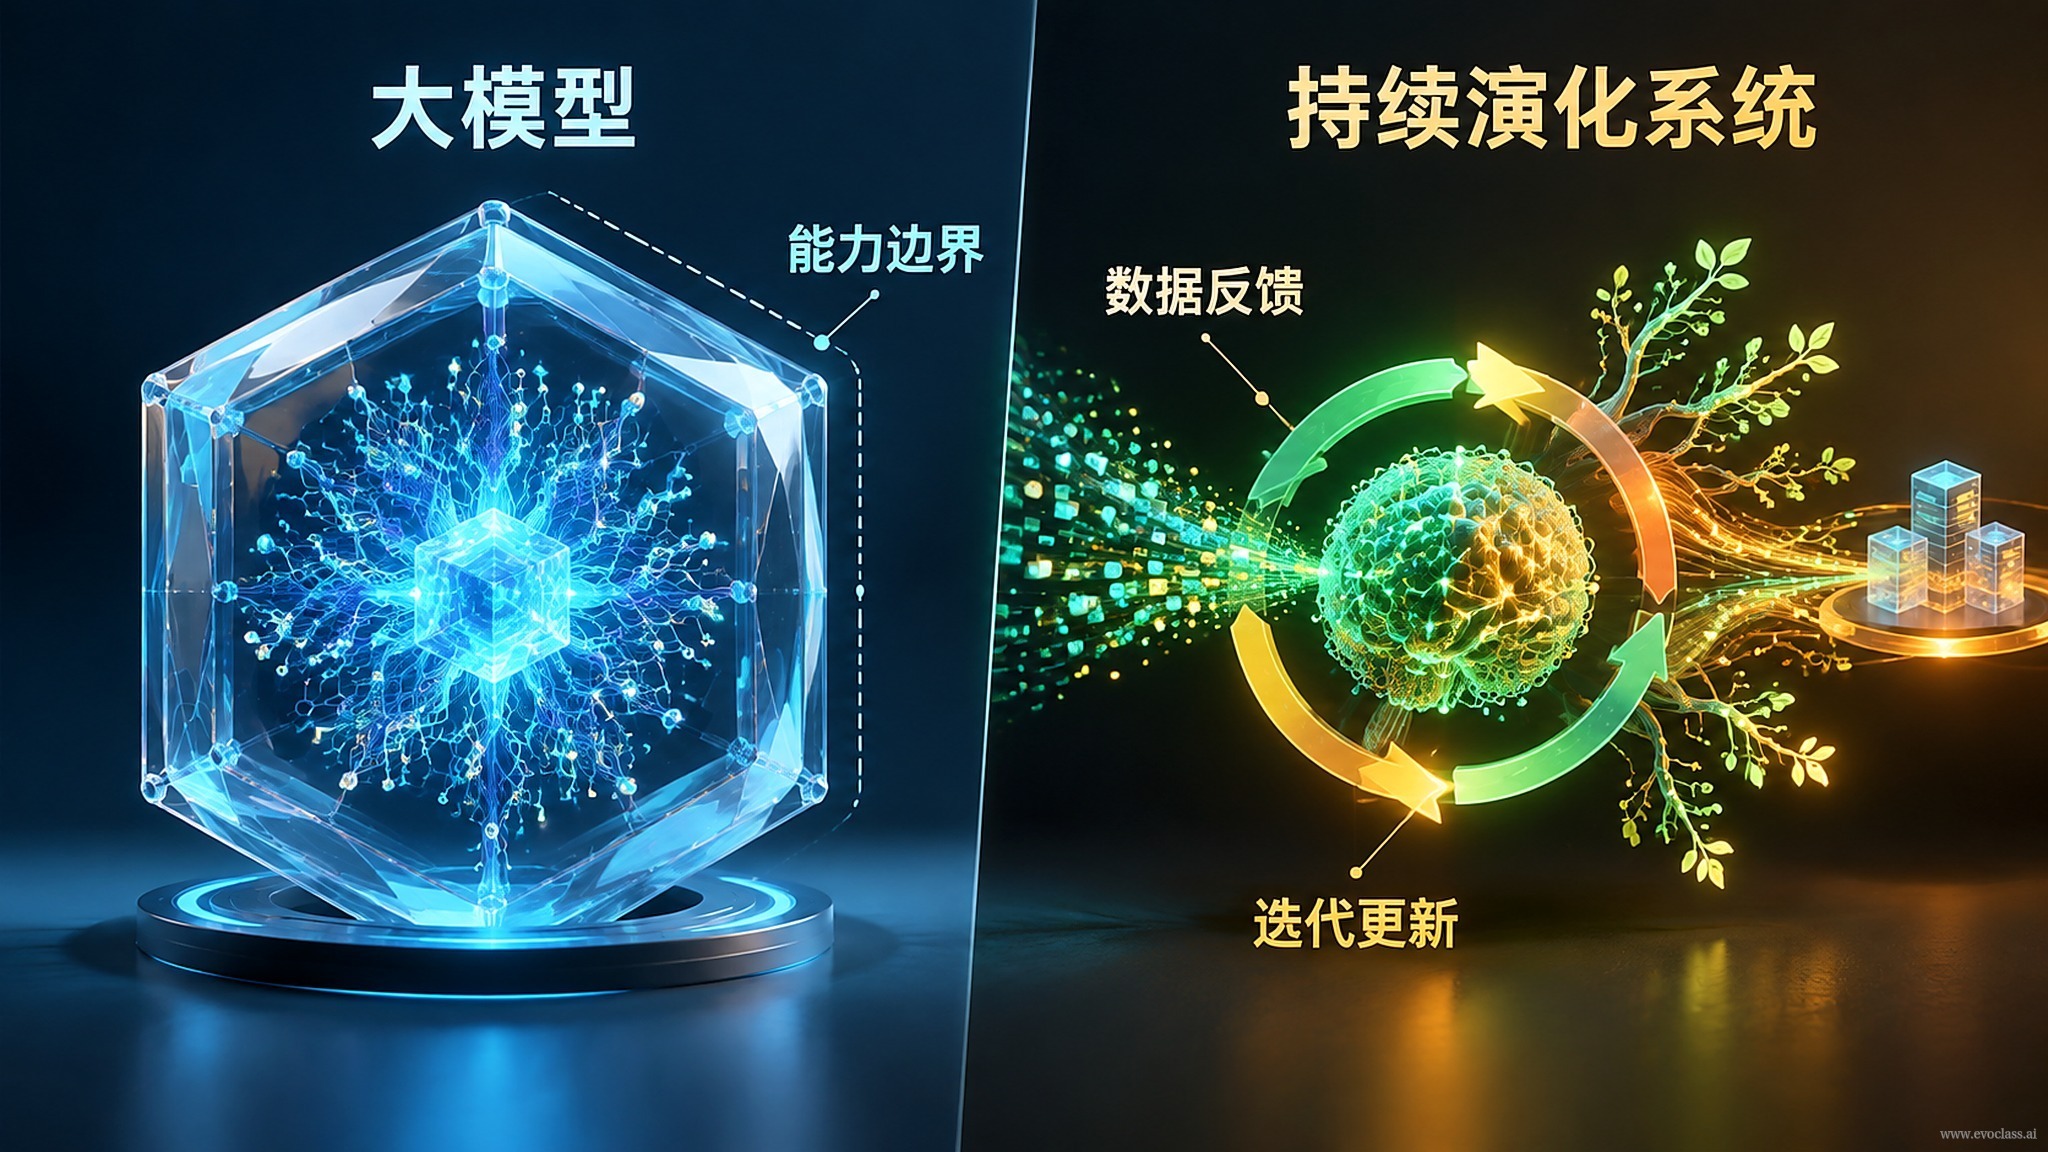
組件與系統閉環對比圖中把大模型能力與持續演化系統並列對比:左側的能力組件只在單次調用中產生候選,負責理解、生成與工具調用;右側的系統閉環通過候選產生、真實檢驗、成果沉澱、再演化四個環節,判定哪些候選值得寫入項目版本並被下一輪繼承。
組件與系統閉環對比
圖中把大模型能力與持續演化系統並列對比:左側的能力組件只在單次調用中產生候選,負責理解、生成與工具調用;右側的系統閉環通過候選產生、真實檢驗、成果沉澱、再演化四個環節,判定哪些候選值得寫入項目版本並被下一輪繼承。