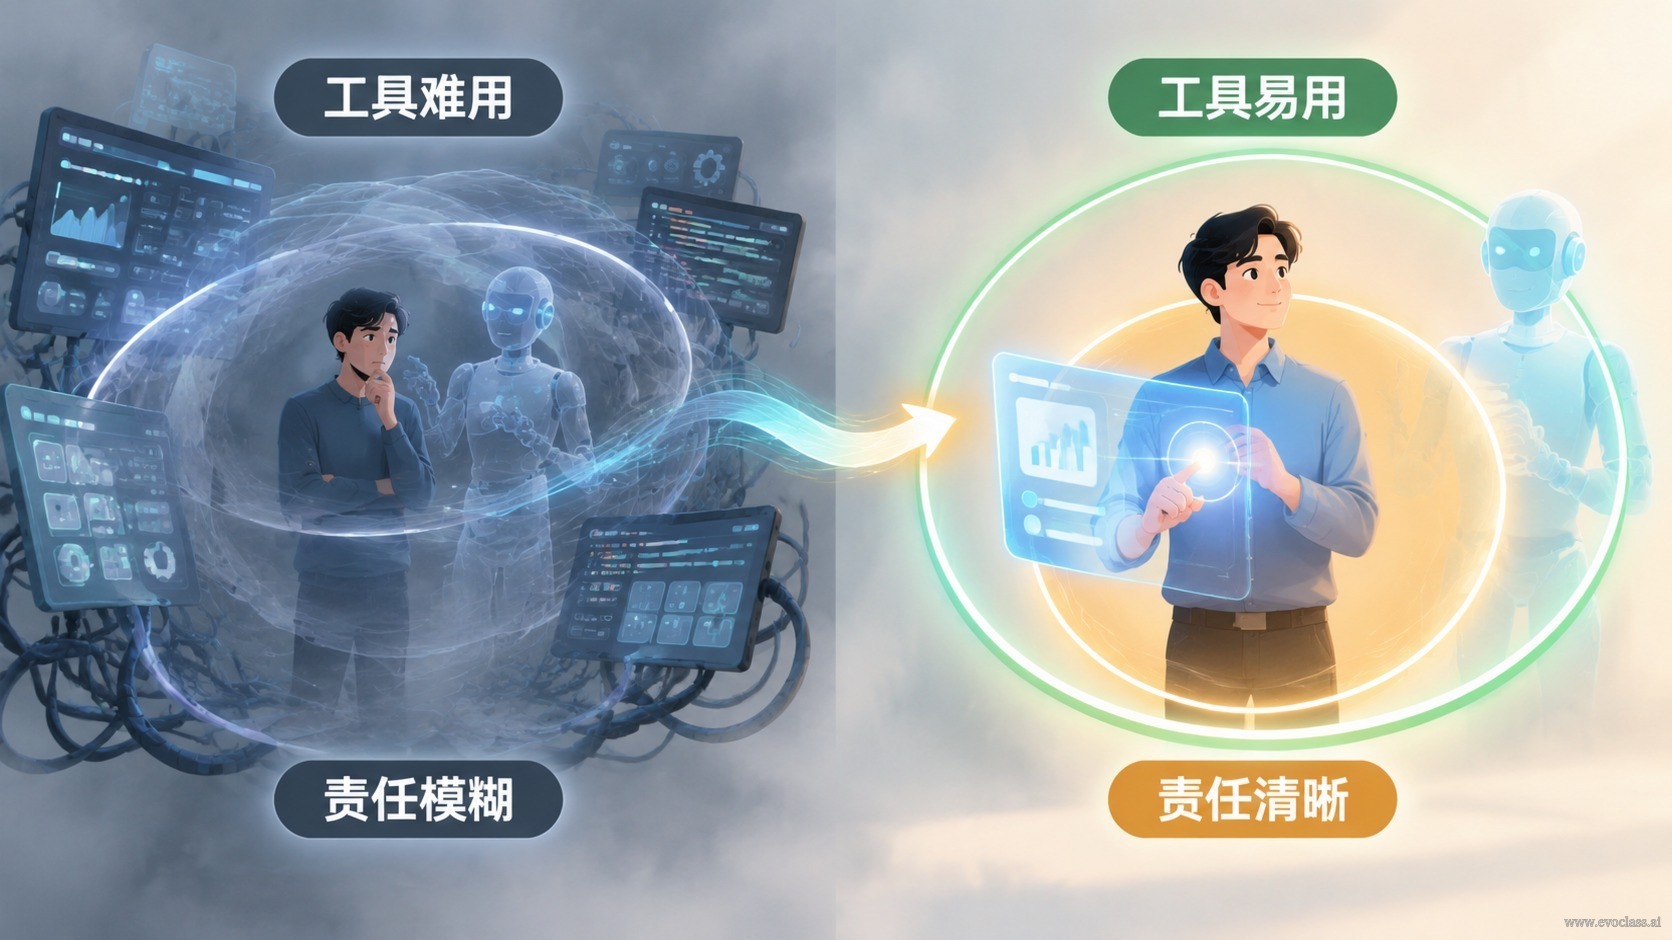
當 AI 與 EvoX 把「想法 → 程式碼 → 實驗」的執行成本壓到極低時,最容易出現的錯覺是:判斷也變得廉價了。事實恰恰相反——工具越容易使用,人的責任越清晰。模型可以迅速把想法變成可執行的候選實作,卻不能替研究者決定這個想法是否值得研究、目標是否準確、比較是否公平。
責任上移:從實作到定義與裁決
- 執行成本下降 ≠ 判斷成本消失:AI 與 EvoX 加速程式碼生成與實驗循環,但問題選擇、目標定義、評價標準仍由人承擔。能跑通只是一份候選修改,不等於科學結論成立。
- 三類不可外包的判斷:問題是否值得研究;目標是否準確;比較是否公平。這三者是科學效度的前置條件,也是自動化系統無法替代的裁決點。
- 責任邊界隨自動化顯影:工具越強,越要明確哪些決策由 Agent 提議、哪些必須由人批准、哪些驗收標準不可妥協。Genesis 的驗收閘道把這條邊界工程化——候選修改必須通過編譯、測試、行為檢查與上層驗收,才能進入專案歷史。
結果有效性優先於運行成功
在多目標 EvoX 實驗中,Agent 可以快速生成候選方案、批量調參並畫出漂亮的收斂曲線;但「目標函數是否代表真實需求、候選多樣性是否被單一指標掩蓋、失敗模式是否被選擇性展示」,必須由研究者逐一審查。工具真正的價值,是讓低價值實作更快被淘汰,讓高價值判斷更早成為瓶頸——這也正是研究者專業性的落點。
圖靈提示
前方有許多事要完成:Code is cheap. Taste matters. 核心能力是提出關鍵問題,並以可複現的方式把控結論的有效性——研究者的品味,決定技術便利最終轉化為何種科學價值。
人機協作責任邊界該圖說明人機協作的責任邊界:AI 與 EvoX 壓縮的是想法到程式碼再到實驗的執行成本,而問題是否值得研究、目標是否準確、比較是否公平仍由人裁決。候選修改須通過編譯、測試、行為檢查與上層驗收的閘道,才能進入專案歷史,結果有效性優先於運行成功。
人機協作責任邊界
該圖說明人機協作的責任邊界:AI 與 EvoX 壓縮的是想法到程式碼再到實驗的執行成本,而問題是否值得研究、目標是否準確、比較是否公平仍由人裁決。候選修改須通過編譯、測試、行為檢查與上層驗收的閘道,才能進入專案歷史,結果有效性優先於運行成功。