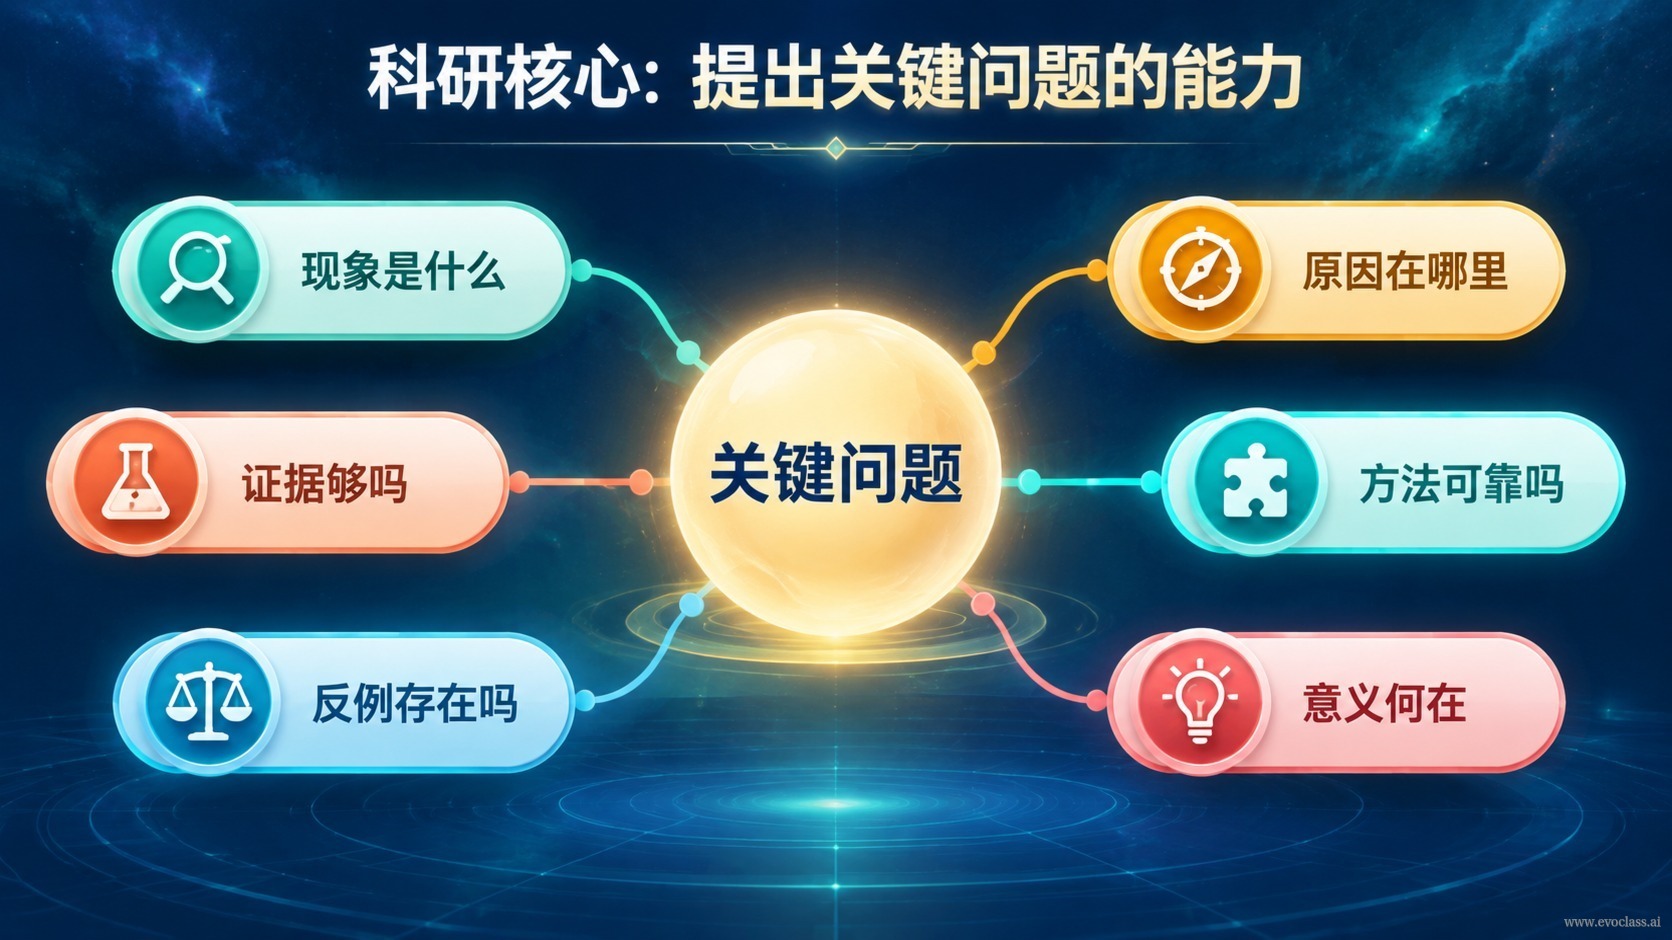
在 AI Native 科研中,自動化程式設計與大模型能力已經把「實現答案」的成本壓得很低:程式碼生成、方案搜尋、實驗執行都可以交給 AI 完成。當答案變得廉價,科研的重心就不再是「能不能做出來」,而是值不值得做、該往哪裡做——這正是提出關鍵問題的能力。
一個關鍵問題通常需要說清什麼
關鍵提問不是追問實作細節,而是把模糊直覺轉化為可檢驗、可演化、可分工的研究結構。它至少要把下面幾件事定義清楚:
- 真實目標與多目標衝突:真正要改善的量是什麼?幾個目標之間如何取捨、誰優先?
- 不可交易的約束:哪些條件是硬邊界,任何方案都不能突破?
- 可觀測的評價指標:用什麼量、在什麼條件下測量,才能讓結論站得住?
- 候選空間邊界:搜尋與演化的可行範圍有多大,需要何種多樣性與穩健性?
- 驗證協定與失敗判據:用多少評價預算、按什麼流程驗證,以及何種結果應當被判定為失敗?
提問品質決定解空間品質
AI 探索的解空間是由問題定義圈出來的。問題定義越清晰,搜尋與演化越可能落在有意義的區域內,產出也越可能可解釋、可複用;問題定義越模糊,模型只能在過大的空間裡隨機試探,結果往往看似可行卻無法沉澱。以「用 EvoX 做最佳化」為例,關鍵提問應轉成:「真實衝突是什麼?目標與約束如何量化?評價預算與驗證標準是什麼?需要何種多樣性與穩健性?何種結果應被判定為失敗?」 這樣 AI 才能高效實現答案,人則把控方向。
人機分工與研究者的核心品味
人機分工的核心是:AI 擴展答案空間與執行路徑,人類把控方向、取捨標準與科學意義。在 Genesis 這類系統級持續演化實踐中,這一點尤其明顯——候選修改必須通過編譯、測試與上層驗收,才能進入被接納的專案版本並成為後續工作的歷史基礎。如果關鍵問題沒有把評價協定與失敗判據定義清楚,驗收關卡就無從判斷,AI 產出只會停留在一次性程式碼產物,無法跨越上下文與任務週期持續累積。
因此,研究者的核心品味體現為三種判斷:什麼值得問、什麼證據可接受、什麼方案雖可行但不值得做。在 EvoX 實踐中,關鍵問題應當能引導出可運行、可評估、可迭代的工作流,而不是只追求一次性的實現結果。
學習目標
明確研究者在自動化程式設計時代應堅持的核心鑑賞力與關鍵提問能力:把方向、衝突、約束、評價與品味邊界定義清楚,讓 AI 負責答案生成與執行。
補充線索:人機分工與研究者的核心品味——AI 擴展答案空間,人守住方向、取捨標準與科學意義。
補充線索:人機分工與研究者的核心品味——AI 擴展答案空間,人守住方向、取捨標準與科學意義。
關鍵問題清單思維導圖這張思維導圖把關鍵問題拆成真實目標與多目標衝突、不可交易的硬約束、可觀測評價指標、候選空間邊界,以及驗證協定與失敗判據。它說明提問品質會決定 AI 搜尋與演化落在什麼區域:以 EvoX 最佳化為例,只有把衝突、量化和驗收標準說清,產出才更可能可解釋、可複用。
關鍵問題清單思維導圖
這張思維導圖把關鍵問題拆成真實目標與多目標衝突、不可交易的硬約束、可觀測評價指標、候選空間邊界,以及驗證協定與失敗判據。它說明提問品質會決定 AI 搜尋與演化落在什麼區域:以 EvoX 最佳化為例,只有把衝突、量化和驗收標準說清,產出才更可能可解釋、可複用。