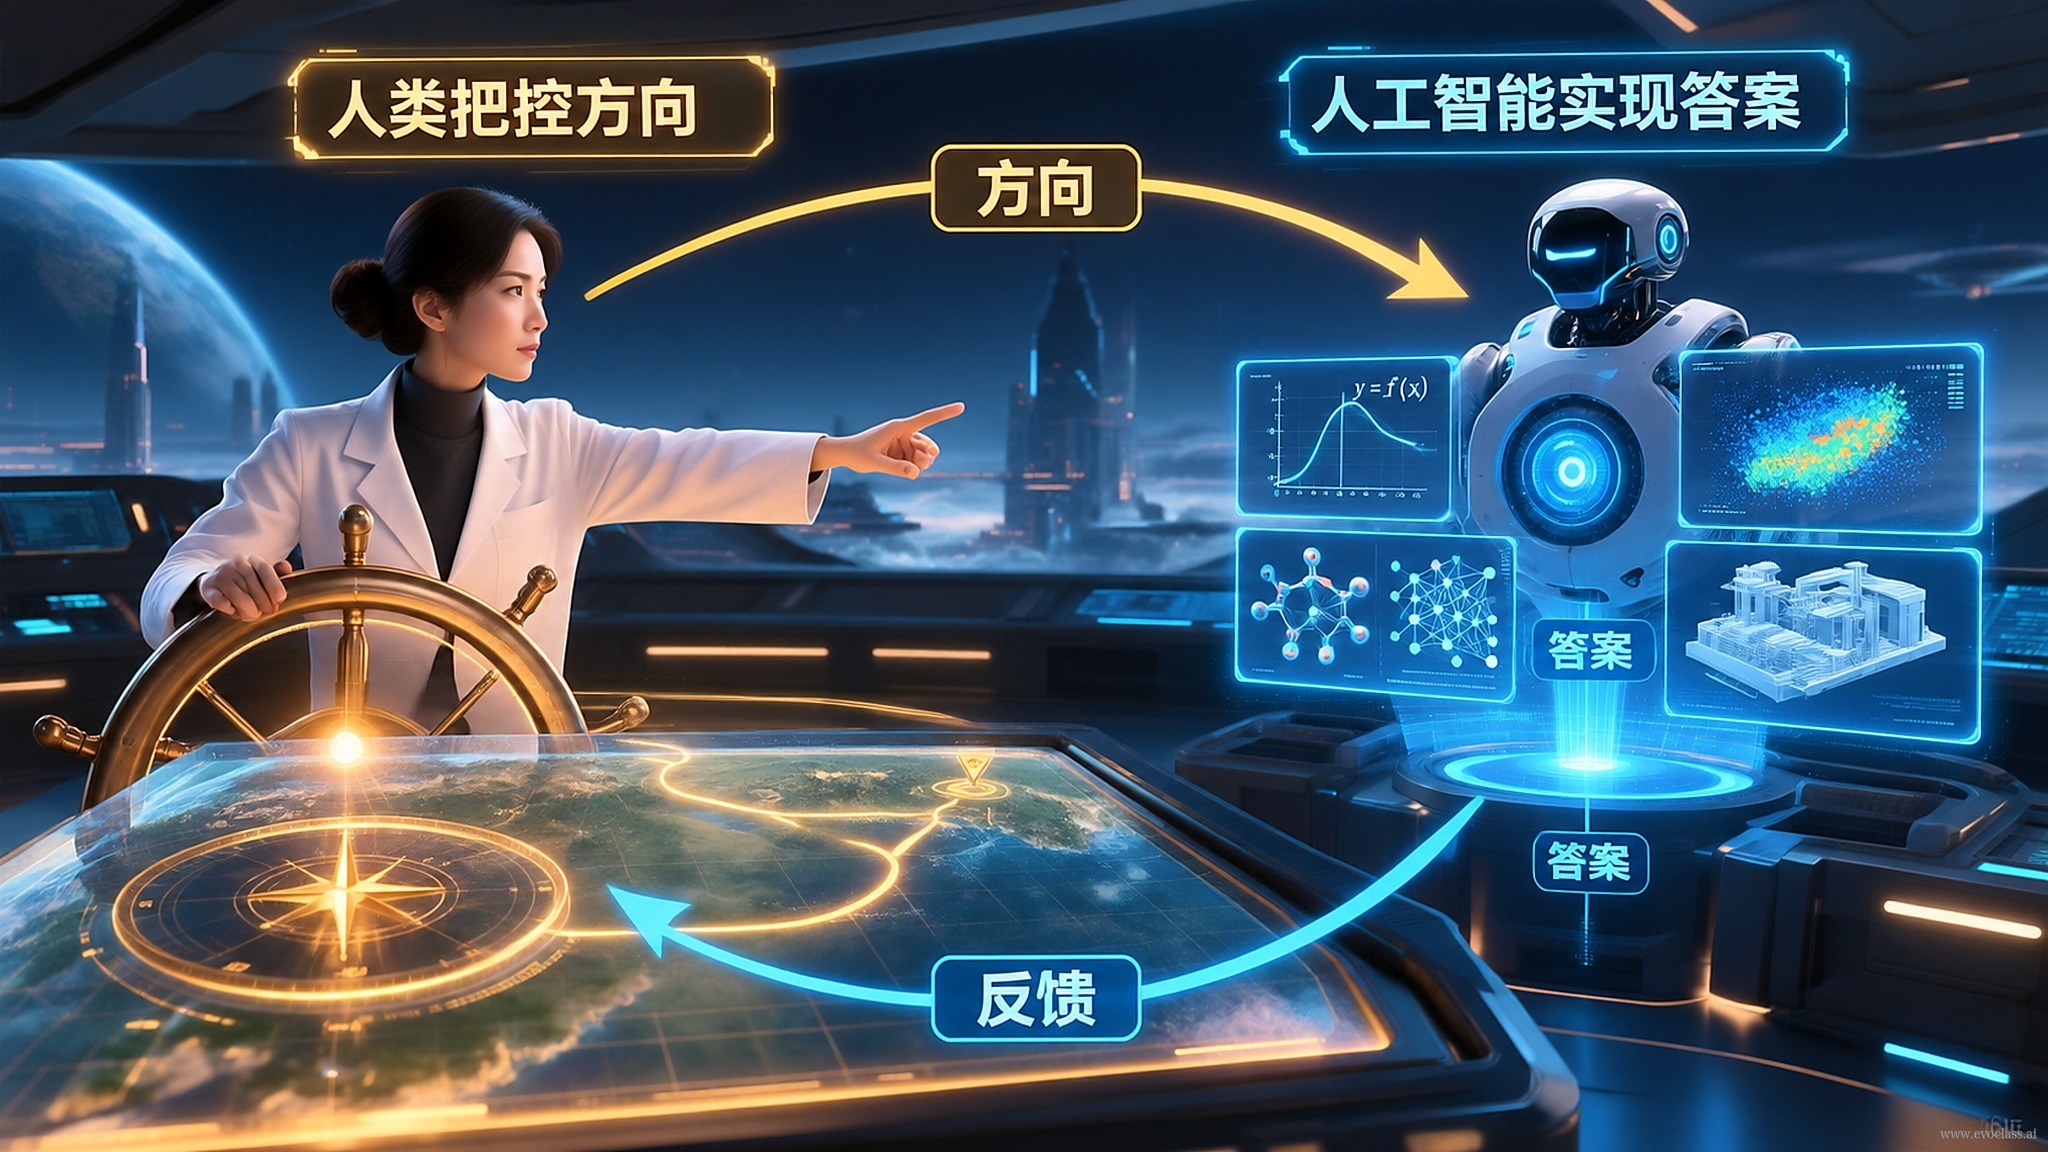
在真實的科研與工程系統裡,AI 最被低估的能力不是「想得更深」,而是把實現與探索的頻寬擴展到人類無法企及的規模。人機分工的本質因此可以畫成一條清晰的分界線:把實現與探索交給 AI,把方向與判斷交給研究者。AI 快速生成答案、批量執行實驗、搜尋候選解並回饋結果;人類決定什麼問題值得回答、什麼證據值得相信,並確保結果具有真正的科學意義。
AI 一側:把實現成本壓到接近於零
- 快速實現答案:一旦問題與評價標準被明確下來,AI 能在很短時間內給出可執行、可檢驗的方案與解釋,實現不再是瓶頸。
- 批量執行實驗:同一套流程可以並行鋪開成百上千次試驗,讓「試錯」從稀缺資源變成常規操作。
- 搜尋候選解並回饋:在巨大的搜尋空間中生成、篩選並回收結果,把探索的觸角伸到人力達不到的地方。
人類一側:把判斷成本留在自己手裡
- 提出關鍵問題:決定什麼問題值得回答,而不是順手去回答一個容易回答的問題。
- 設定目標、約束與評價標準:檢查最佳化目標、約束條件與評價指標是否真實刻畫了現實問題。
- 判斷證據是否可信:區分「跑得通的結果」與「可靠的結果」,識別過擬合、資料洩漏與指標造假。
- 科學意義驗收:最終交付的不是更多數字,而是科學上站得住腳、值得繼續投入的結論。
為什麼必須形成閉環
兩側透過「結果上行、標準下行」耦合在一起:AI 把候選答案與實驗回饋推給研究者,研究者把目標、約束與驗收標準交回給 AI。閉環的價值在於AI 擴展探索頻寬,人類把控方向與驗收標準,任何一側缺席都會失效——只有 AI 會得到大量無意義的結果;只有人類則探索頻寬受限。以多目標演化探索為例,AI 可以自動生成並執行大量候選方案,而研究者決定最佳化目標、約束條件和評價指標是否反映真實問題,並篩選出科學上可信、值得繼續探索的方向。
常見誤區
把評價標準也一併交給 AI 自動決定。這樣系統會非常高效地最佳化一個並不反映真實科學問題的目標,產出大量「看起來合理」卻毫無意義的結果。凡是會改變「什麼算好」的決策,都必須留在人類一側。
自檢:回想你最近一次實驗,其中「這個問題要不要做」「什麼算成功」這兩個判斷,分別是誰做出的?如果答案都是模型,那麼分工已經失衡。
人機分工閉環這張分工模型把 AI 一側歸為快速實現答案、批量執行實驗、搜尋候選解並回饋結果,把人類一側歸為提出關鍵問題、設定目標約束與評價標準、判斷證據可信並驗收科學意義。兩側透過結果上行、標準下行形成閉環,若評價標準也交給 AI,系統就會高效最佳化一個並不反映真實科學問題的目標。
人機分工閉環
這張分工模型把 AI 一側歸為快速實現答案、批量執行實驗、搜尋候選解並回饋結果,把人類一側歸為提出關鍵問題、設定目標約束與評價標準、判斷證據可信並驗收科學意義。兩側透過結果上行、標準下行形成閉環,若評價標準也交給 AI,系統就會高效最佳化一個並不反映真實科學問題的目標。