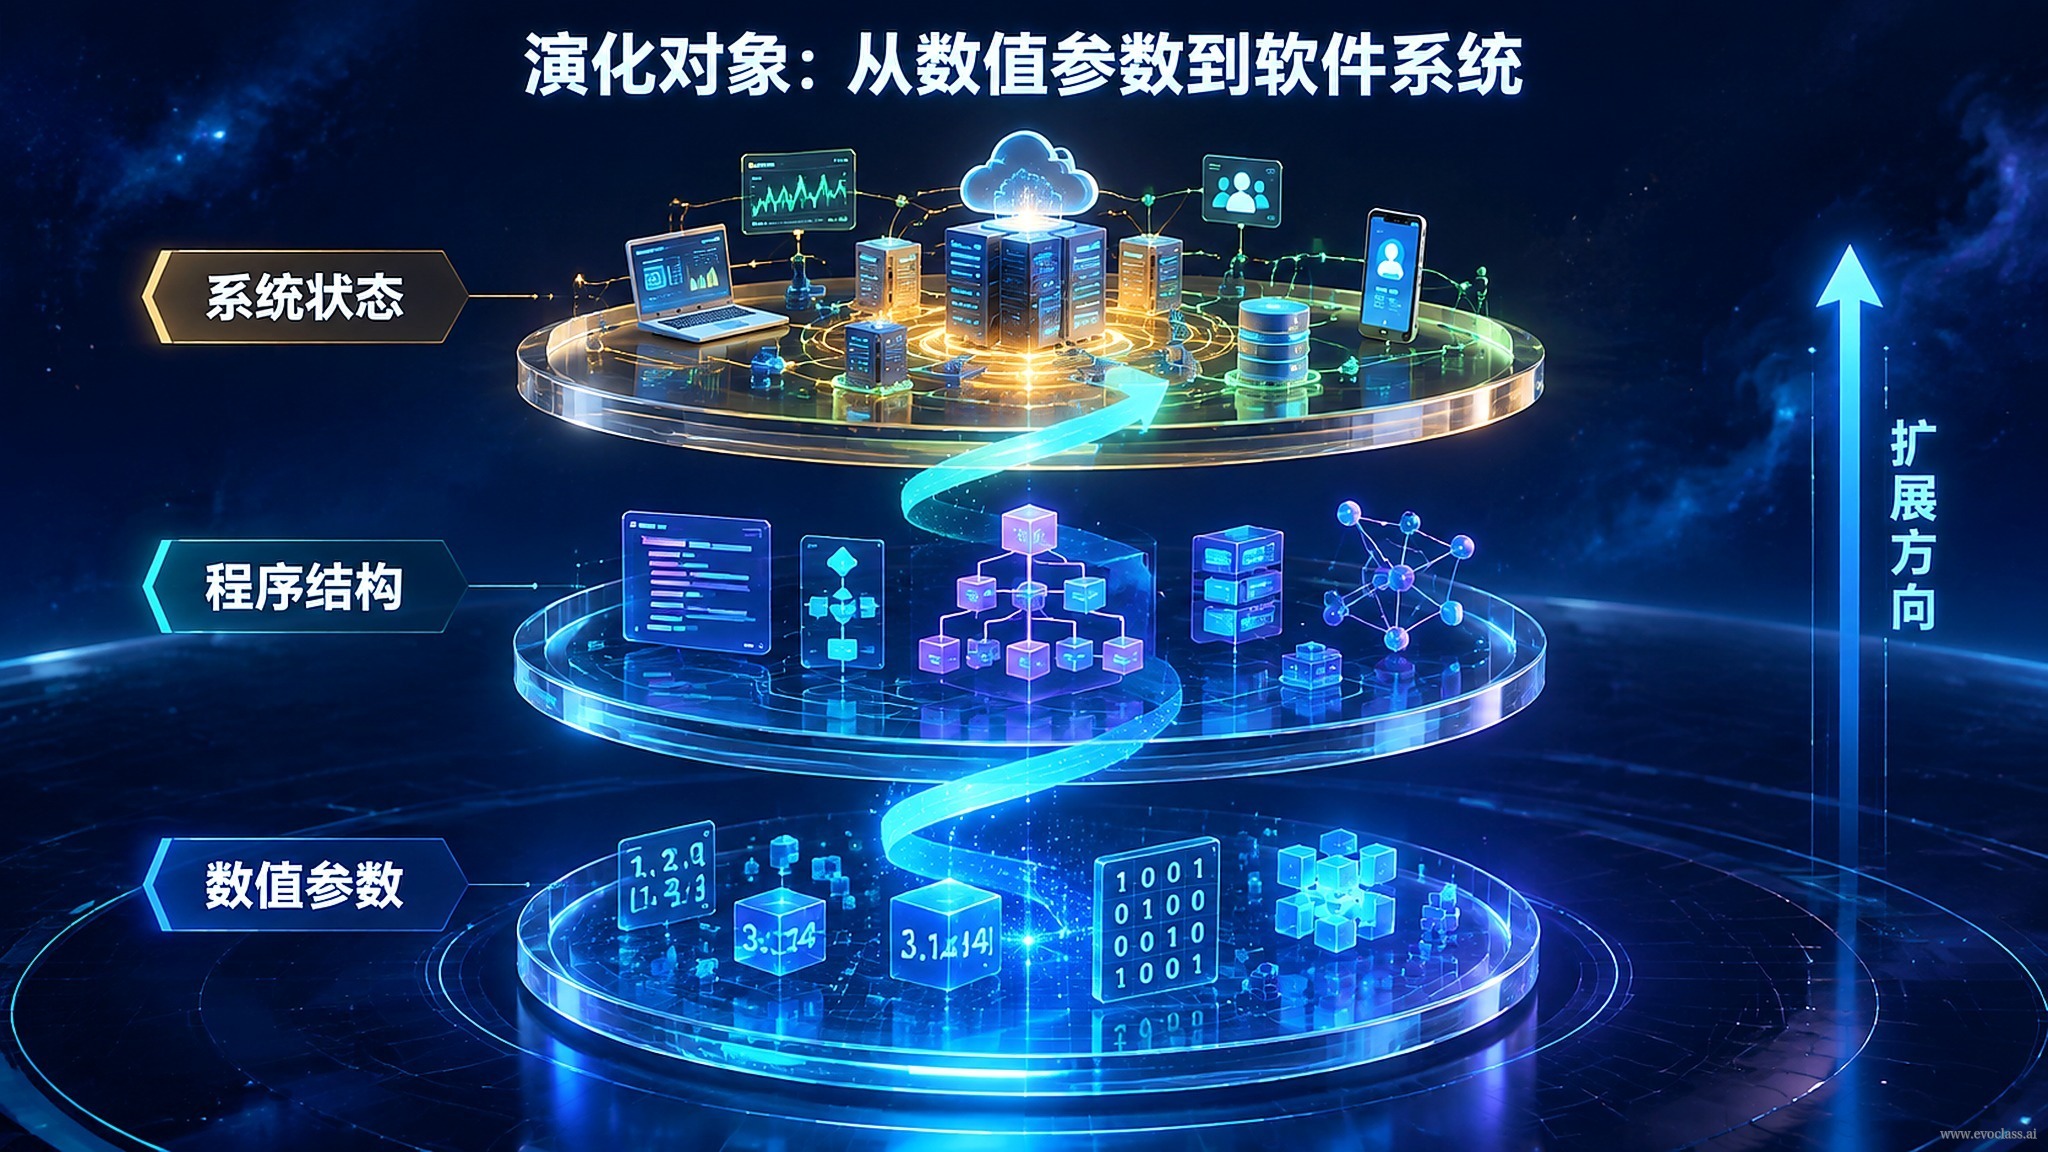
在演化计算的早期实践中,被“演化”的对象几乎都是数值参数——学习率、批大小、正则强度、权重初始化方式。搜索空间就是一组数字,评价方式就是一次训练加一次验证。随着算力规模提升与大模型能力的成熟,可被演化的对象明显扩展:程序、模型结构、算法机制,乃至一整块软件工程状态(配置、依赖版本、接口契约、部署与运行策略)。
这条扩展路径可以用一条清晰的箭头链表示:数值参数 → 程序与模型结构 → 软件工程状态与系统级候选。层级越靠右,表达力越强,能覆盖的变化类型越多,系统级演化也因此成为可能。
三层演化对象,各自的代价不同
- 数值参数层:候选就是一组数字,生成便宜、评价快,但它只能回答“调得好不好”,无法补上一个本来就缺失的机制。
- 程序与模型结构层:候选是网络结构、算子组合、提示工作流或代码补丁,变化会改变“系统能做什么”,而不只是“做得多准”。
- 软件工程状态层:候选是配置、依赖版本、接口契约与部署策略,直接决定系统能否稳定运行、能否被复现。
重心转移:从“如何生成候选”到“如何执行与评价”
当候选从数字变成程序,“生成候选”这一步反而不再是瓶颈:大模型可以批量产出结构、机制与补丁。真正决定演化是否有效的,是执行与评价机制——谁能把候选真正跑起来,谁能在可接受的成本内判断它是否值得保留。
表达力越强,评价负担越重。一个数值参数只需一次训练就能打分;而一个代码补丁需要沙箱隔离、回归测试与基准对照,才能回答三个问题:它是否真的有效、是否带来风险、结果能否复现。沙箱、回归测试与基准正是用来约束成本、风险与可复现性的工程装置,也让变化可以被稳定地保留或淘汰。
工程权衡:候选变多不等于演化变好
在团队实践中,常见路径是先调学习率与超参数,再逐步扩展到搜索网络结构、算子组合、提示工作流或代码补丁。每扩展一层,都要同步回答:评价要花多少算力与时间?失败的候选会不会污染现有系统?同样的结果下次还能复现吗?只有在表达力、评价成本、可复现性与安全性之间取得平衡,系统级演化才真正可行。
常见误区
把“候选更多”直接等同于“演化更有效”。候选数量增加只扩大了搜索范围;只有当执行与评价机制足以筛掉无效变化时,更多的候选才会转化为更好的系统。
演化对象的三层扩展
图中箭头链从数值参数指向程序与模型结构,再指向软件工程状态与系统级候选:越往右可改变的对象越多、表达力越强。但代价同步上升,数值参数只需一次训练打分,代码补丁则要沙箱隔离、回归测试与基准对照才能判断有效性、风险与可复现性。
演化对象的三层扩展
图中箭头链从数值参数指向程序与模型结构,再指向软件工程状态与系统级候选:越往右可改变的对象越多、表达力越强。但代价同步上升,数值参数只需一次训练打分,代码补丁则要沙箱隔离、回归测试与基准对照才能判断有效性、风险与可复现性。