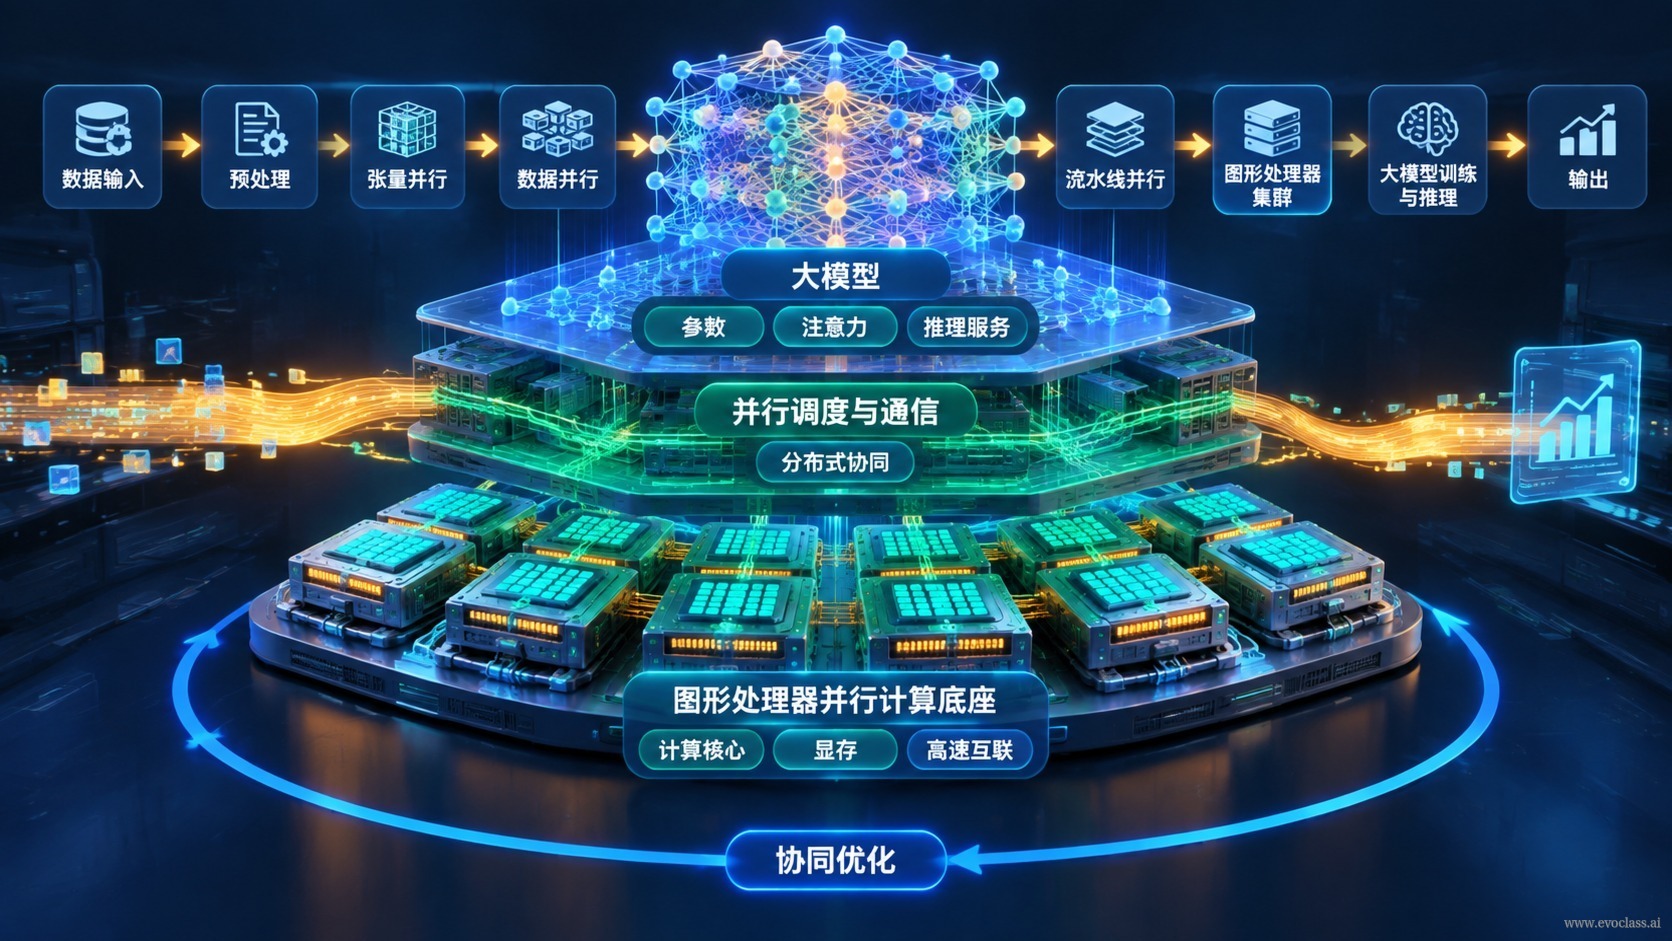
本页讨论 EvoX 之所以能够展开大规模演化探索的工程底座:GPU 提供高强度并行算力,大模型 提供对自然语言、代码与项目上下文的理解与生成能力。二者叠加之后,计算规模被打开,候选解的来源、数量以及可以作用的探索范围都发生了根本变化。
算力打开了什么:从串行小批量到大规模同时探索
在算力受限的条件下,评价一个候选解往往需要排队等待,搜索只能以小批量、串行的方式推进,「多试几个」是一种奢侈。GPU 的并行能力把评价与搜索推进到大规模同时进行:种群或大批候选解可以一次性送入并行评价,反馈几乎同时回流。于是「同时尝试大量可能」不再是特殊手段,而成为默认的工程能力。
- 吞吐:批量评价把单次迭代的等待时间压缩到可接受范围,使演化循环能够高频运转,而不是被评价环节拖慢。
- 规模:可同时探索的候选数量上升,搜索能够覆盖的假设空间随之扩大,探索边界从「少量试错」变为「成批铺开」。
候选解的来源发生了什么变化
计算规模打开之后,候选来源从「人工设计 + 少量采样」转向混合模式:并行计算批量供给 与 大模型生成与改写 共同产出候选。大模型能够理解自然语言、代码与项目上下文,可以把研究意图更快地转化为可执行的候选、脚本或算子草案,并保持与项目语境的衔接;GPU 侧则负责把这些草案批量验证,把结果反馈回搜索过程。两者一前一后,恰好覆盖了「生成」与「验证」两头。
底座不替代演化算法
需要明确的是,这一层是底座而不是算法本体。它承担的是吞吐、语义入口 与 上下文衔接;搜索、选择与反馈闭环仍然由演化算法负责。把分工划清楚,在实践中才有判断力:当一个系统效果不佳时,需要先判断缺的究竟是算力吞吐、是语义入口,还是闭环机制本身。
在同一条工程脉络上,底座还需要支撑 多 Agent 协作与递归任务拆解 这类工程模式:一个复杂目标被拆成若干子任务,由不同 Agent 分别认领与推进。而要让这些子任务彼此不脱节,就需要项目级持久化——把目标、约束、中间产物与评价结果沉淀在项目层面,使其能够跨越 Agent 上下文 延续。否则每更换一个 Agent,上下文就要重新对齐,递归拆解会退化为互不相干的一次性调用。
概念澄清
算力与模型扩大了探索边界,但并不自动带来正确性。候选再多,也需要环境反馈与评价选择把它们筛成可持续积累的能力。本页只定位到「工程底座」这一层,先把算力与模型如何扩大探索边界说清楚;Runtime 的组织方式、演化对象的边界划分等实现细节,留到后续展开。
GPU 并行与大模型协同工作的架构图
觀察圖中的GPU 并行与大模型协同工作的架构图,想一想它和「大模型能够理解自然语言代码和项目上下文」有什麼關係。
GPU 并行与大模型协同工作的架构图
觀察圖中的GPU 并行与大模型协同工作的架构图,想一想它和「大模型能够理解自然语言代码和项目上下文」有什麼關係。