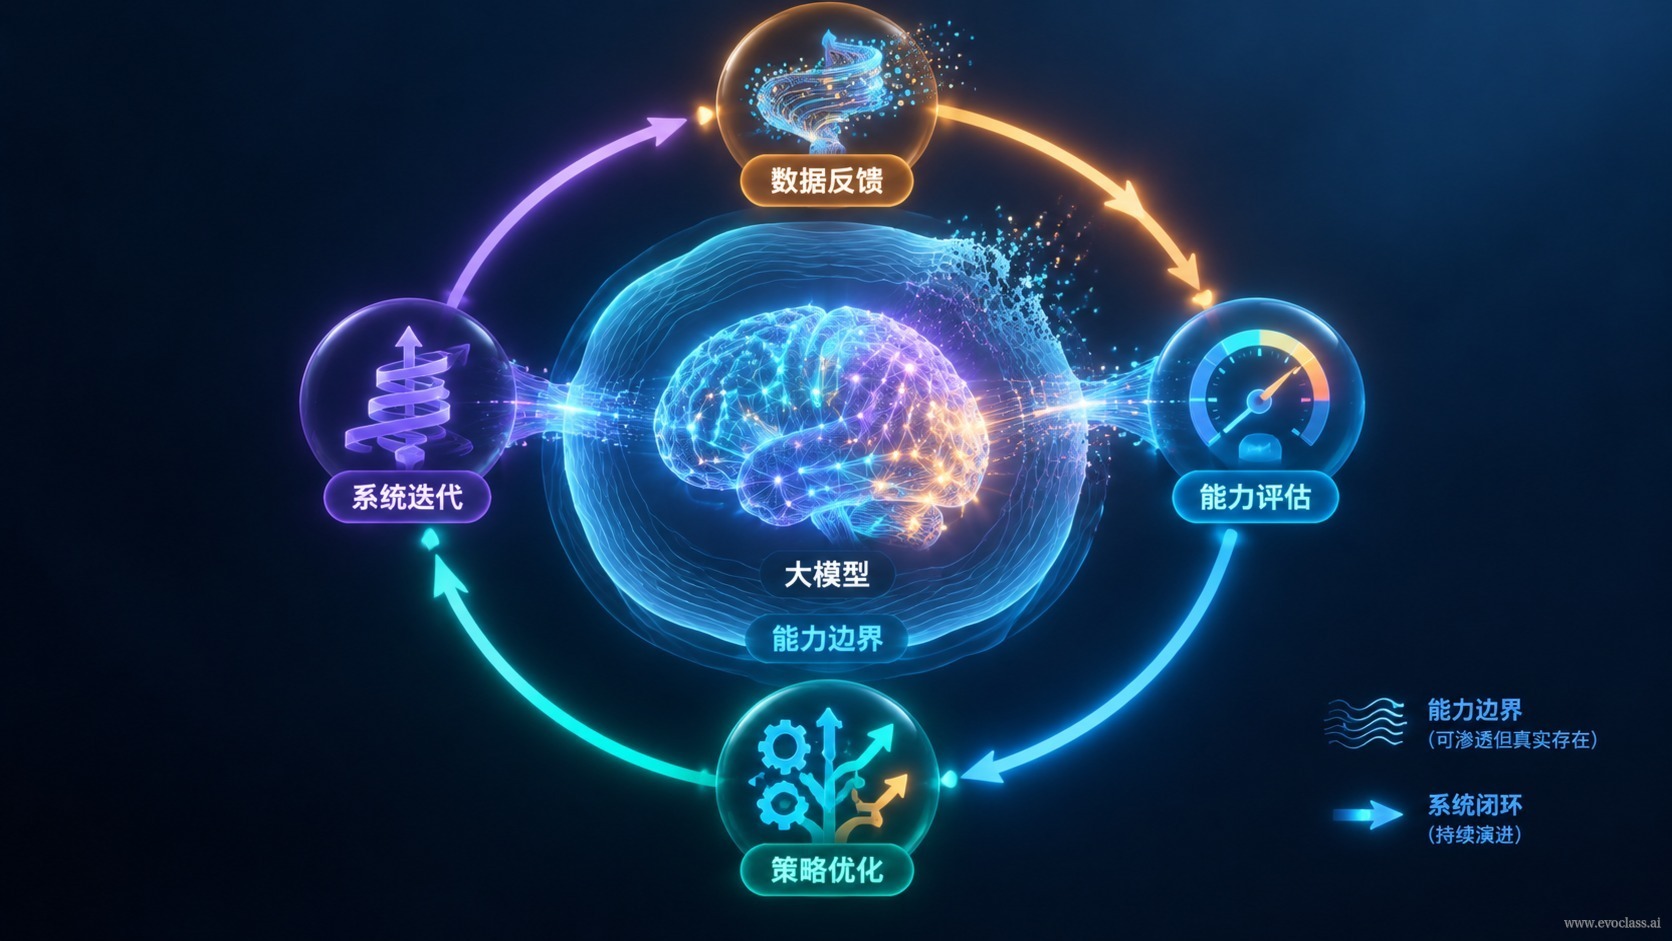
大模型已经把自己变成了可靠的能力基座:语义理解、代码与方案生成、多步推理、工具与函数调用——它足以支撑“提出问题即产出候选”的交互形态。但基座越强,越容易掩盖一个工程事实:模型负责生成可能性,闭环必须由系统承担。本页要论证的正是这条能力边界,以及为什么持续演化是一项系统级责任,而不是模型能力的自然延伸。
一、模型侧已经胜任的部分
- 语义理解:把模糊需求解析成可执行的问题描述,并识别其中隐含的约束与目标。
- 生成能力:在数分钟内产出代码、配置、方案与解释,并能在同一轮对话内自我修订。
- 多步推理:完成任务分解、链式推导与取舍说明,天然具备“提出候选并解释理由”的输出形态。
- 工具调用:通过函数调用触发检索、计算与外部接口,把语言输出接到真实动作上。
这四点合起来意味着“候选的产生”已经近乎免费。真正稀缺的资源不是候选的数量,而是对候选施加选择压力的机制。
二、结构性缺口:单次会话无法闭环
- 会话内状态易失:上下文一旦耗尽,跨任务的记忆随之断裂,上一轮学到的教训无法自动进入下一轮。
- 真值缺位:模型无法自主定义“什么算对”,也无法给出独立于自身输出的评价标准。
- 实验调度缺位:批量基准测试、统计显著性检验、约束合规判定,以及高成本真实环境的执行,都不在模型的控制范围内。
结论很清晰:模型无法在单次会话或单次任务内独立完成候选产生—环境检验—结果沉淀的闭环。这不是能力不够,而是职责本来就不在模型身上。
三、系统侧必须补位的四类工作
- 候选的产生与变异:组织模型输出,主动扩大并结构化搜索空间。
- 环境的构造与调用:搭建可重复执行的实验环境,负责调度、执行与验收。
- 评价与筛选:定义真值与评价器,完成排序、筛选与显著性判断。
- 沉淀与复用:把成功结果与失败经验写入长期记忆,成为下一次任务的起点。
分工原则只有一句:模型负责生成可能性,系统负责施加选择压力并保留历史。二者不可互相替代——没有模型,系统就没有可筛选的多样性;没有系统,模型只能一次次归零。
四、判据转换:从“单次输出多好”到“改进能否累积”
衡量一个系统是否真正在演化,标准不应是“单次输出有多好”,而应是“改进能否跨任务、跨 Agent 周期累积”。一次惊艳但无法被继承的输出,本质上仍是一次性消耗。当每一次任务的产出都被固化为可复用的工程资产——代码、配置、评价器、失败案例集——后续任务的起点就高于前一次,这就是项目级持续演化。EvoX 的实践给出了一个稳定可靠的工程沉淀范式:跨越 Agent 与任务周期,把经验固化为资产,而不是留在对话记录里。
关键决策点:边界问题的根因是架构缺位
当我们遇到“改进无法累积”的问题时,第一反应常常是“换一个更强的模型”。但边界问题的根因通常是架构缺位,而不是模型不够强。正确动作是补系统,而不是换模型。可以自检:把同一任务交给能力更强的模型,是否就能自动获得跨任务记忆、真值判定与实验调度?如果不能,问题就不在模型侧。
最后划一条与相邻主题的界线:本页只论证“为什么需要系统级持续演化”,不展开算法自身的双层演化机制(见后续 MetaDE 相关内容)。
AI 模型能力与系统级闭环组织关系图
觀察圖中的AI 模型能力与系统级闭环组织关系图,說說你觀察到的重點。
AI 模型能力与系统级闭环组织关系图
觀察圖中的AI 模型能力与系统级闭环组织关系图,說說你觀察到的重點。