在多目标演化中,偏好优化把决策者的偏好作为搜索与筛选的引导信号,而不是等搜索结束之后再做一次性打分。它带来两个结构性改变:一是不提前把多个目标压缩成单一标量得分;二是不只交出一个“最优解”,而是输出一组在权衡结构上彼此有差异的候选方案,把最终取舍权保留给领域专家。
为什么需要候选方案组
多目标问题中并不存在天然唯一的“最优解”。当目标彼此冲突时,一个解在某个目标上的改善往往要以另一个目标的恶化为代价,因此可比较的解会连成一条理想权衡前沿。如果提前用一个加权和把目标合并,等价于在尚不清楚真实偏好的情况下,替决策者选定了一个隐含的折中点;一旦现实约束或偏好发生变化,这个解可能立刻失去价值。偏好优化要做的,是把“人希望往哪个方向看”编码进搜索过程,让搜索资源集中在真正被关心的区域。
偏好如何进入搜索
- 参考点:给出一个理想的目标取值组合,引导种群向该方向逼近。
- 目标优先级:声明哪个目标更不能被牺牲,用于非支配排序或淘汰判断。
- 权重区间:不是固定权重,而是一段可接受的权重范围,允许多种折中同时成立。
- 交互式反馈:由专家在多轮迭代中逐步给出偏好,搜索随之收窄。
这些形式的功能是一致的:收窄关注区域、提高搜索效率,而不是提前把整个解空间坍缩成一个点。
候选方案组的核心:差异性保留
候选方案组的价值不在于“数量多”,而在于组内方案在目标权衡上分布分散:偏保守端、偏激进端与折中段各有代表,覆盖不同的折中模式。如果只是在同一个解附近给出若干微扰副本,它们无法支撑任何有意义的取舍判断。
差异性也不会自然维持。演化过程若没有机制干预,会自发向当前最优区域收敛,候选组最终退化为单一答案的重复表达。因此需要分布维护、拥挤度控制或归档集策略等机制,把“分散”作为显式保护目标之一。
边界区分
偏好不等于替人决策,差异也不等于随机噪声。候选方案之间的差异必须能用目标权衡结构解释——否则那只是不可用的无效多样性。
输出形态因此从“单一最优解”转变为“可解释、可比较的候选方案组”:专家可以结合领域知识与现实约束做出选择,并把选择结果作为新一轮反馈送回搜索过程。
候选方案分布散点
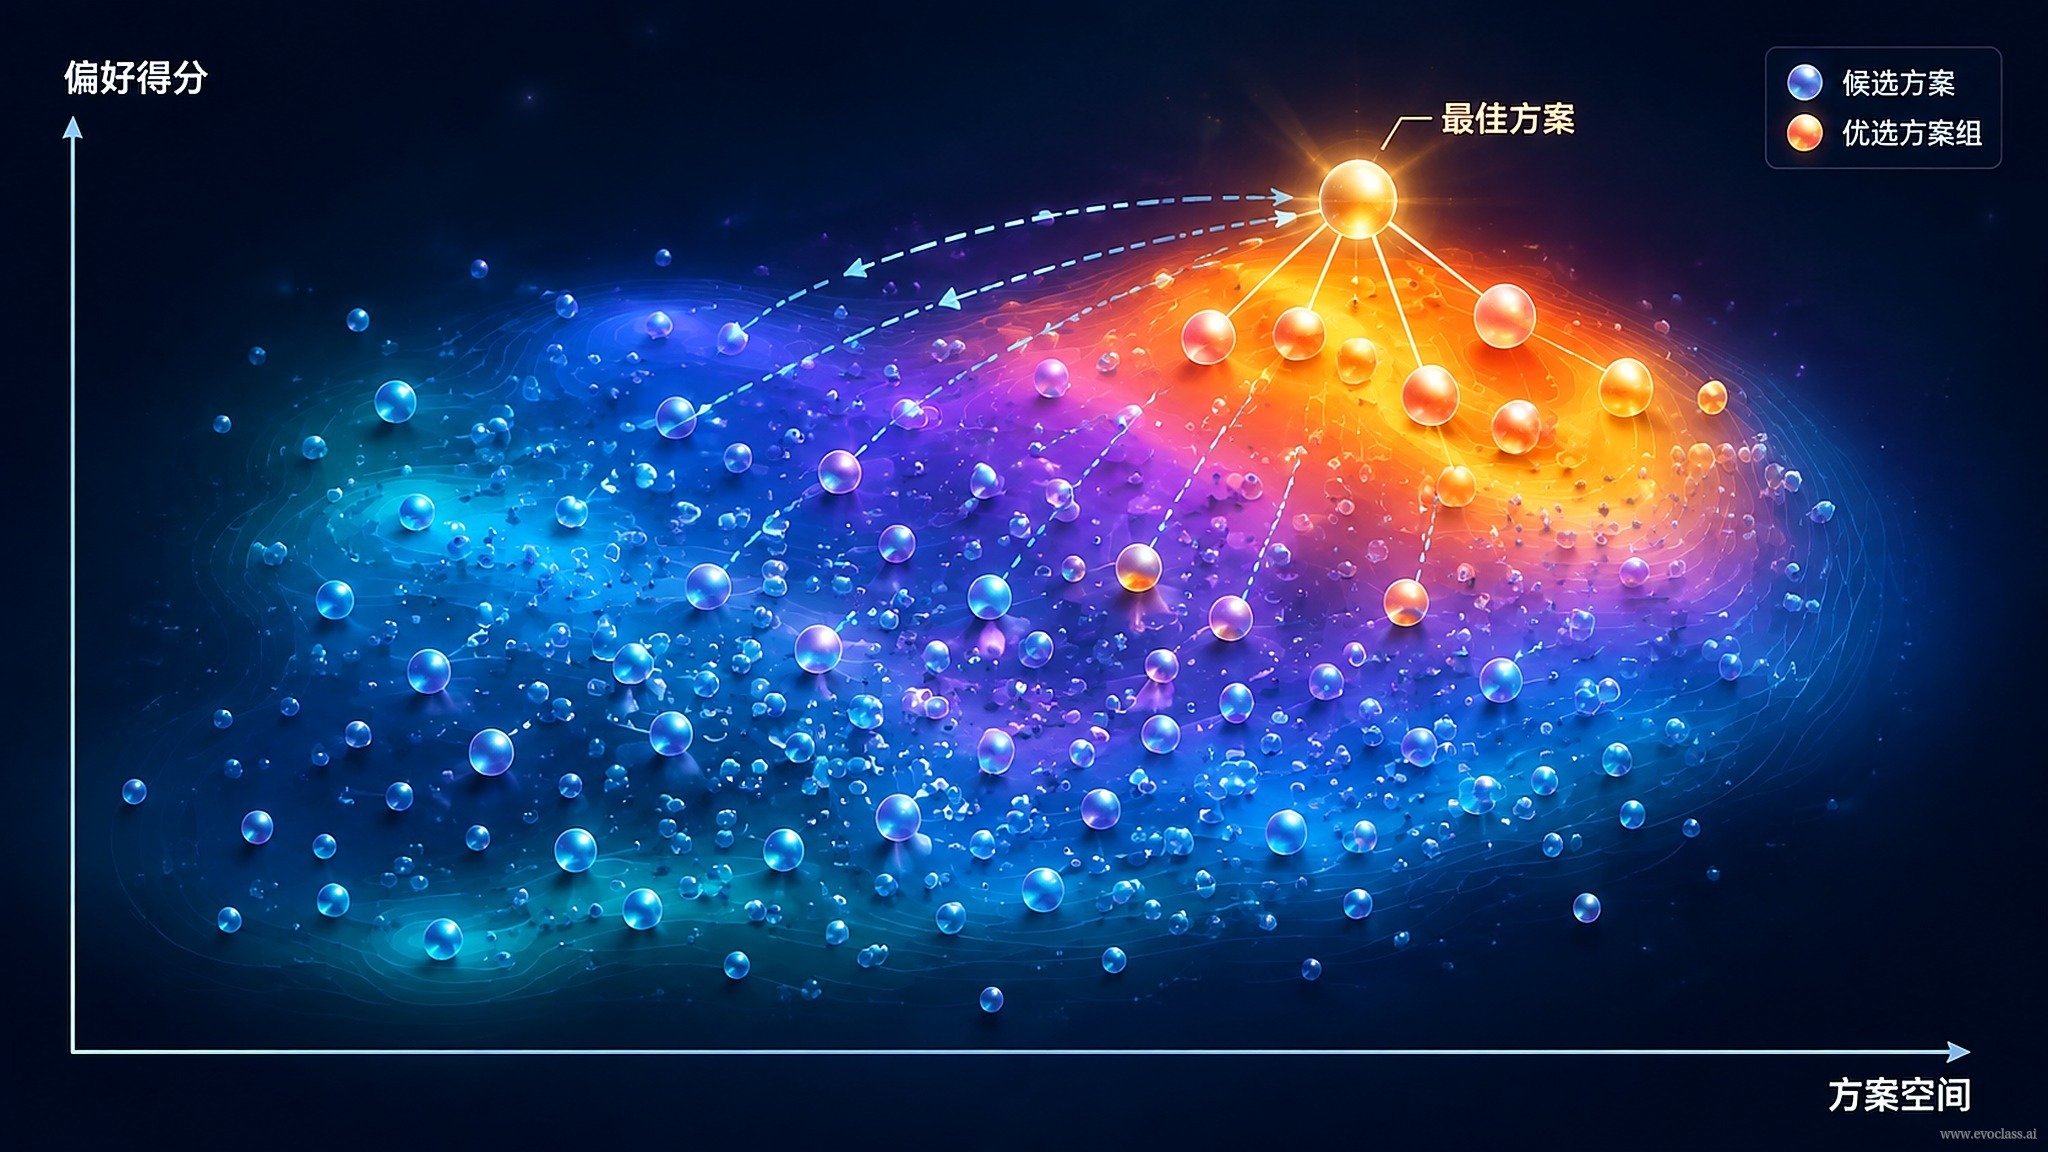
图示用分散的候选点表示偏好优化后的搜索输出:参考点、目标优先级、权重区间或交互反馈引导搜索收窄,但分布维护与拥挤度控制保留差异性。组内方案应覆盖保守端、激进端与折中段,让专家结合现实约束做最终取舍,而非提前坍缩成单一解。
候选方案分布散点
图示用分散的候选点表示偏好优化后的搜索输出:参考点、目标优先级、权重区间或交互反馈引导搜索收窄,但分布维护与拥挤度控制保留差异性。组内方案应覆盖保守端、激进端与折中段,让专家结合现实约束做最终取舍,而非提前坍缩成单一解。