在超临界翼型等复杂工程设计中,高保真仿真(CFD、有限元分析)的单次评估往往需要数十分钟到数小时。若把这种仿真直接嵌入演化循环,每一代种群都要逐个评估,计算预算会在几十代之内被迅速耗尽,可探索的搜索空间也随之被压缩。
代理模型(surrogate model,也称近似模型、元模型)用低成本近似计算替代或部分替代高保真仿真:它从已有仿真样本中学习输入—输出映射,在多目标演化优化中快速预测候选方案的性能,从而突破高精度仿真成本高昂的瓶颈。
为什么不能把高保真仿真直接塞进演化循环
- 瓶颈来源:超临界翼型、结构强度等问题的单次 CFD / 有限元仿真耗时长,而演化算法每一代都要评估整个种群,评估次数与计算预算近似线性消耗。
- 直接后果:预算被少数几代吃光,种群规模与迭代代数只能被迫压缩,多目标前沿难以被充分探索,真正的设计空间被「评估不起」所封锁。
代理模型的基本原理
用基础翼型、扰动样本等已有数据训练一个映射关系「候选方案 → 目标值与约束表现」,它就成为一个廉价近似评估器。演化循环中候选解先由代理批量评分,只有评分靠前、或不确定性偏大的少数候选才交给高保真仿真校核。
加速路径的四个环节
- 离线训练:用初始采样样本训练代理模型,建立初步的输入—输出映射。
- 在线批量预测:每一代对全部候选同时预测多个目标值,替代逐点高保真仿真。
- 代理辅助选点:结合预测值与不确定性,挑选高潜力或高信息量的候选。
- 回填校正:把少量高保真结果写回样本库并增量更新代理,使后续预测持续贴近真实响应面。
精度与成本的权衡
代理模型越复杂(从简单回归到高斯过程、深度网络),通常越准,但训练与推断开销也随之上升。关键约束是代理必须显著快于高保真仿真,否则它会变成新的瓶颈;同时精度要足以支撑选择压力,否则演化会被错误的方向带偏。
边界与风险
代理只在训练分布附近可靠。当搜索把候选推向分布外区域时,预测可能给出看似合理却严重偏离的数值,误导搜索方向。可行做法是:输出不确定性估计、设置置信阈值筛选、对越界候选强制高保真验证,并用实际误差统计定期检查代理质量。
常见误区
代理模型不是「更精确的仿真」,而是「更便宜的近似」。它的价值来自把稀缺的高保真预算集中投向最关键、最不确定的候选,而不是取消验证环节。
代理模型加速仿真对比
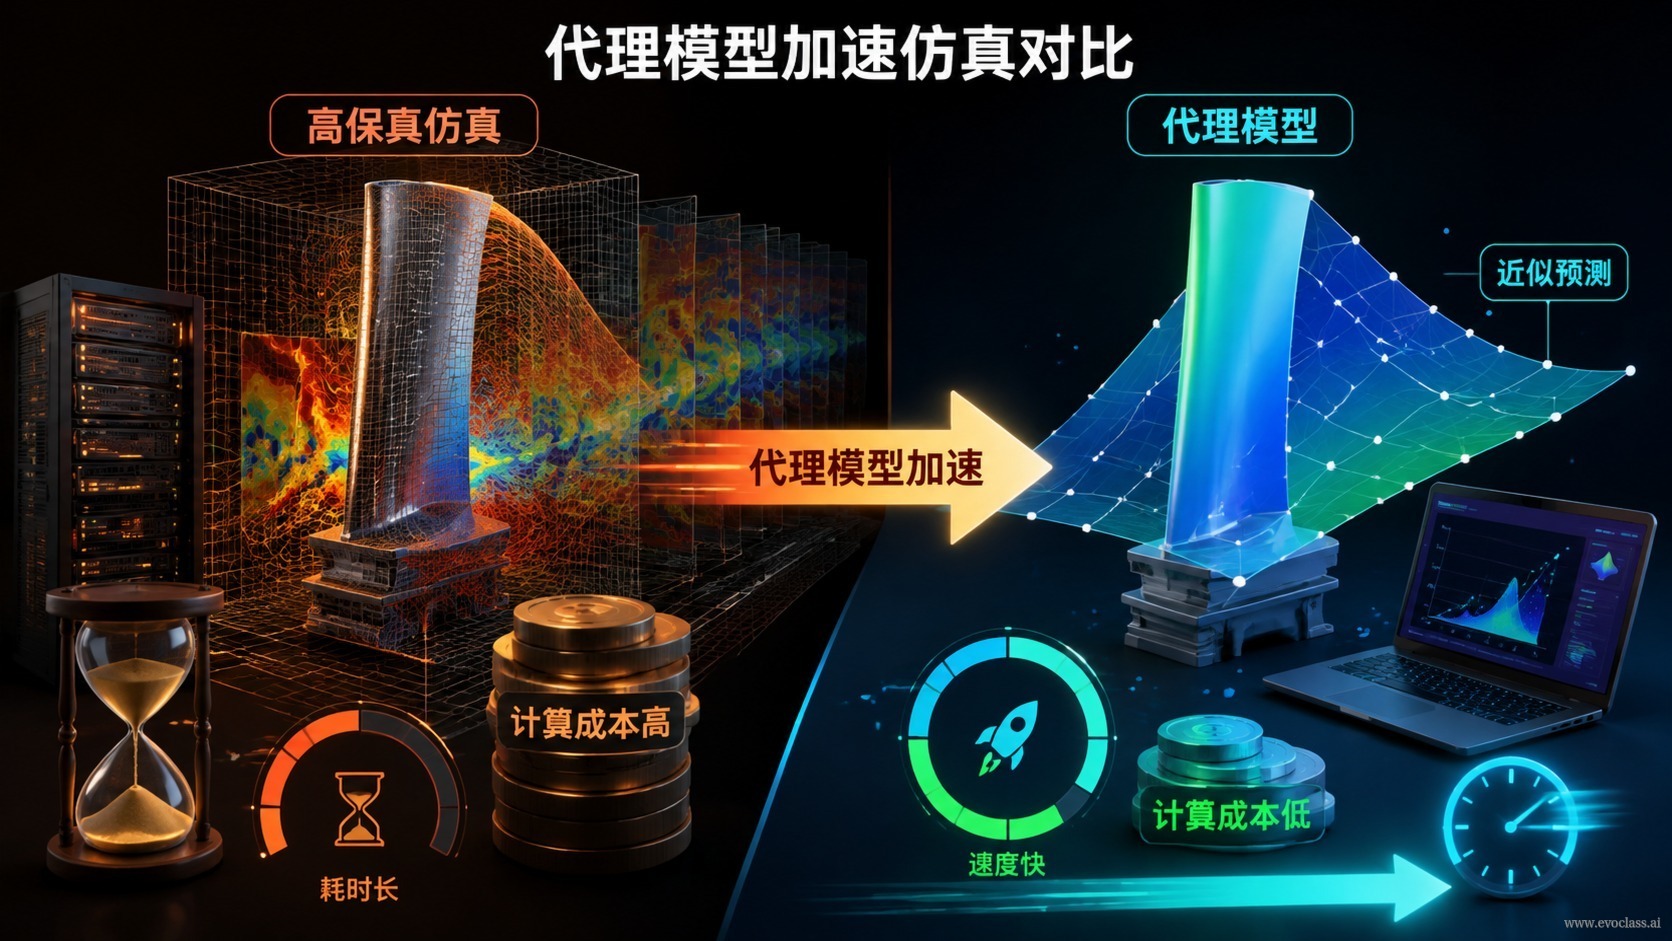
图示对比高保真仿真与代理模型在演化优化中的评估流程:前者逐点耗时,难以支撑大种群多代搜索;后者用已有样本学习候选方案到目标值的映射,批量快速预测。仅把靠前或不确定性大的候选交给高保真校核,并将结果回填更新代理,从而把稀缺仿真预算集中在关键候选上。
代理模型加速仿真对比
图示对比高保真仿真与代理模型在演化优化中的评估流程:前者逐点耗时,难以支撑大种群多代搜索;后者用已有样本学习候选方案到目标值的映射,批量快速预测。仅把靠前或不确定性大的候选交给高保真校核,并将结果回填更新代理,从而把稀缺仿真预算集中在关键候选上。