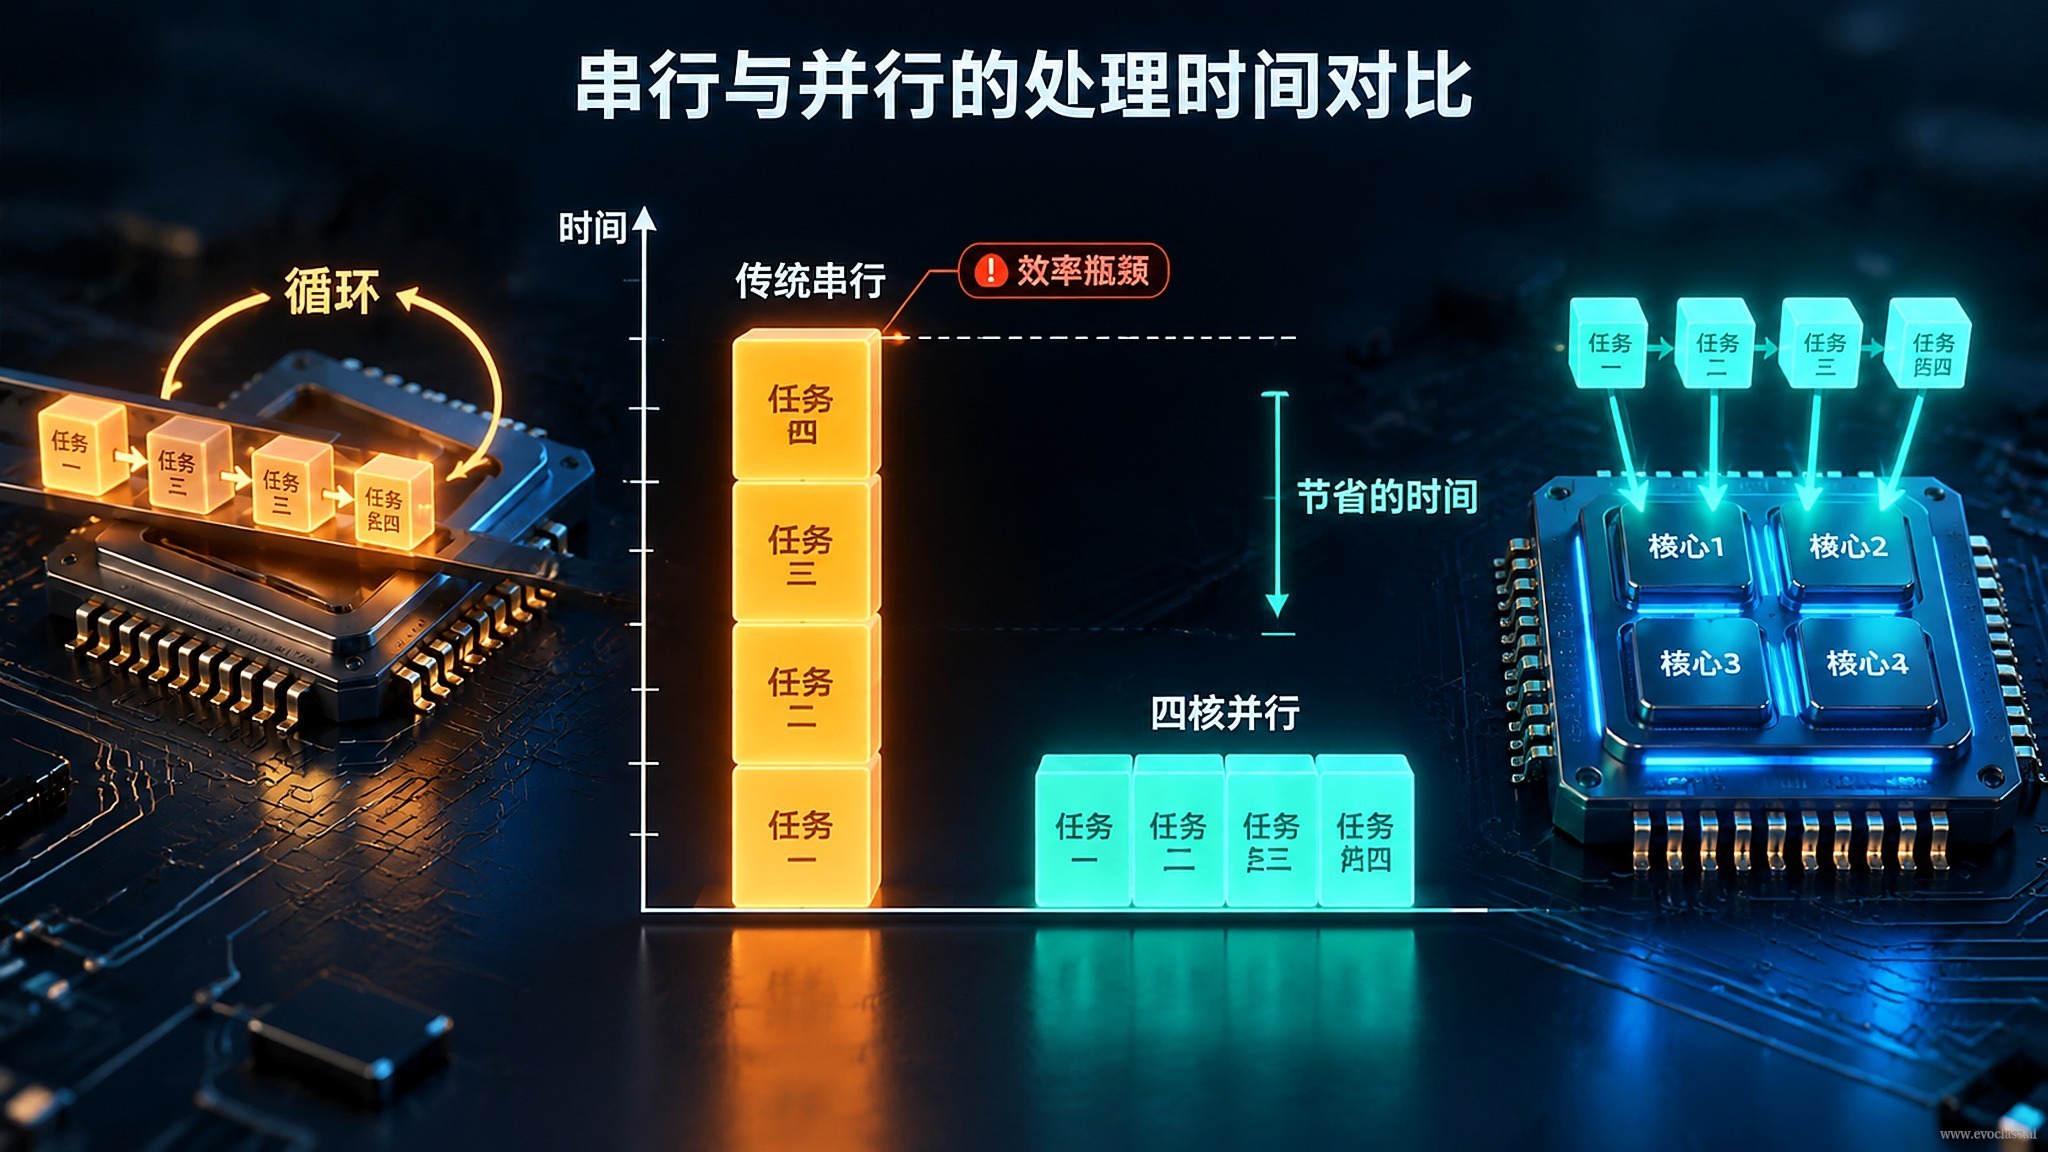
演化过程依赖种群多样性,而多样性意味着种群规模与评价次数的成倍增长。当候选评价达到数万次量级时,传统串行 CPU 循环就成了整条流水线上最窄的一段:它一次只处理一个个体,硬件的并行能力几乎被闲置。
一次一个:串行循环的执行模型
最朴素的实现是把整个种群当成一个列表,用循环逐个取出个体:取个体 → 解码为具体参数 → 调用评价函数 → 把适应度写回。相邻迭代之间几乎无法重叠:评价结果不回来,写回就无法推进;写回不完成,下一个体就无处安放结果。于是多核、SIMD、GPU 这些并行单元大部分时间处于空闲,只能看着一个个体在流水线上跑完。
开销到底来自哪里
- 线性膨胀的评价次数:总评价次数约为种群规模 × 迭代代数,达到 10⁵ 量级时,串行墙钟耗时近似线性增长。
- 解释器层的逐个执行:逐个体循环、边界检查与类型分发带来固定却高昂的常数开销。
- 非连续访存与数据搬运:逐个取用的个体在内存中往往不连续,缓存命中率偏低,搬运成本被反复支付。
- 同步与调度:为了取到下一个个体,执行流必须反复停顿再恢复。
把规模换算成时间
以种群 1000、迭代 100 代为例,共约 10 万次候选评价。若单次评价平均 1 ms,仅评价环节串行就需约 100 秒,尚未计入算子计算与调度开销;若为维持多样性把重启次数从 1 次增加到 5 次,代价近似线性上升到约 500 秒。同等工作量若按批组织并交由并行硬件处理,墙钟时间主要由批次数而非个体数决定。
什么时候这个瓶颈会收窄
边界条件同样重要:当单次评价极廉价(微秒级)或种群极小(百量级以下)时,调度与内存开销可能反超计算开销,串行与并行的差距明显收窄,张量化的边际收益递减,瓶颈会转移到调度粒度与内存带宽。因此是否值得改造执行模型,需要结合评价成本与规模共同评估。
结构性瓶颈,而非代码瑕疵
串行 CPU 循环的效率瓶颈属于执行模型层面:单点代码调优无法消除它。要真正解决,需要把逐个重构为逐批——批处理、张量化与并行调度,这也构成后续张量化计算图设计的直接动机。
串行与并行的耗时对比
以种群1000、迭代100代为例,共约10万次候选评价;单次评价1毫秒时串行仅评价环节就需约100秒,重启5次则近似线性增至约500秒。改按批组织交给并行硬件后,墙钟时间主要由批次数而非个体数决定。
串行与并行的耗时对比
以种群1000、迭代100代为例,共约10万次候选评价;单次评价1毫秒时串行仅评价环节就需约100秒,重启5次则近似线性增至约500秒。改按批组织交给并行硬件后,墙钟时间主要由批次数而非个体数决定。