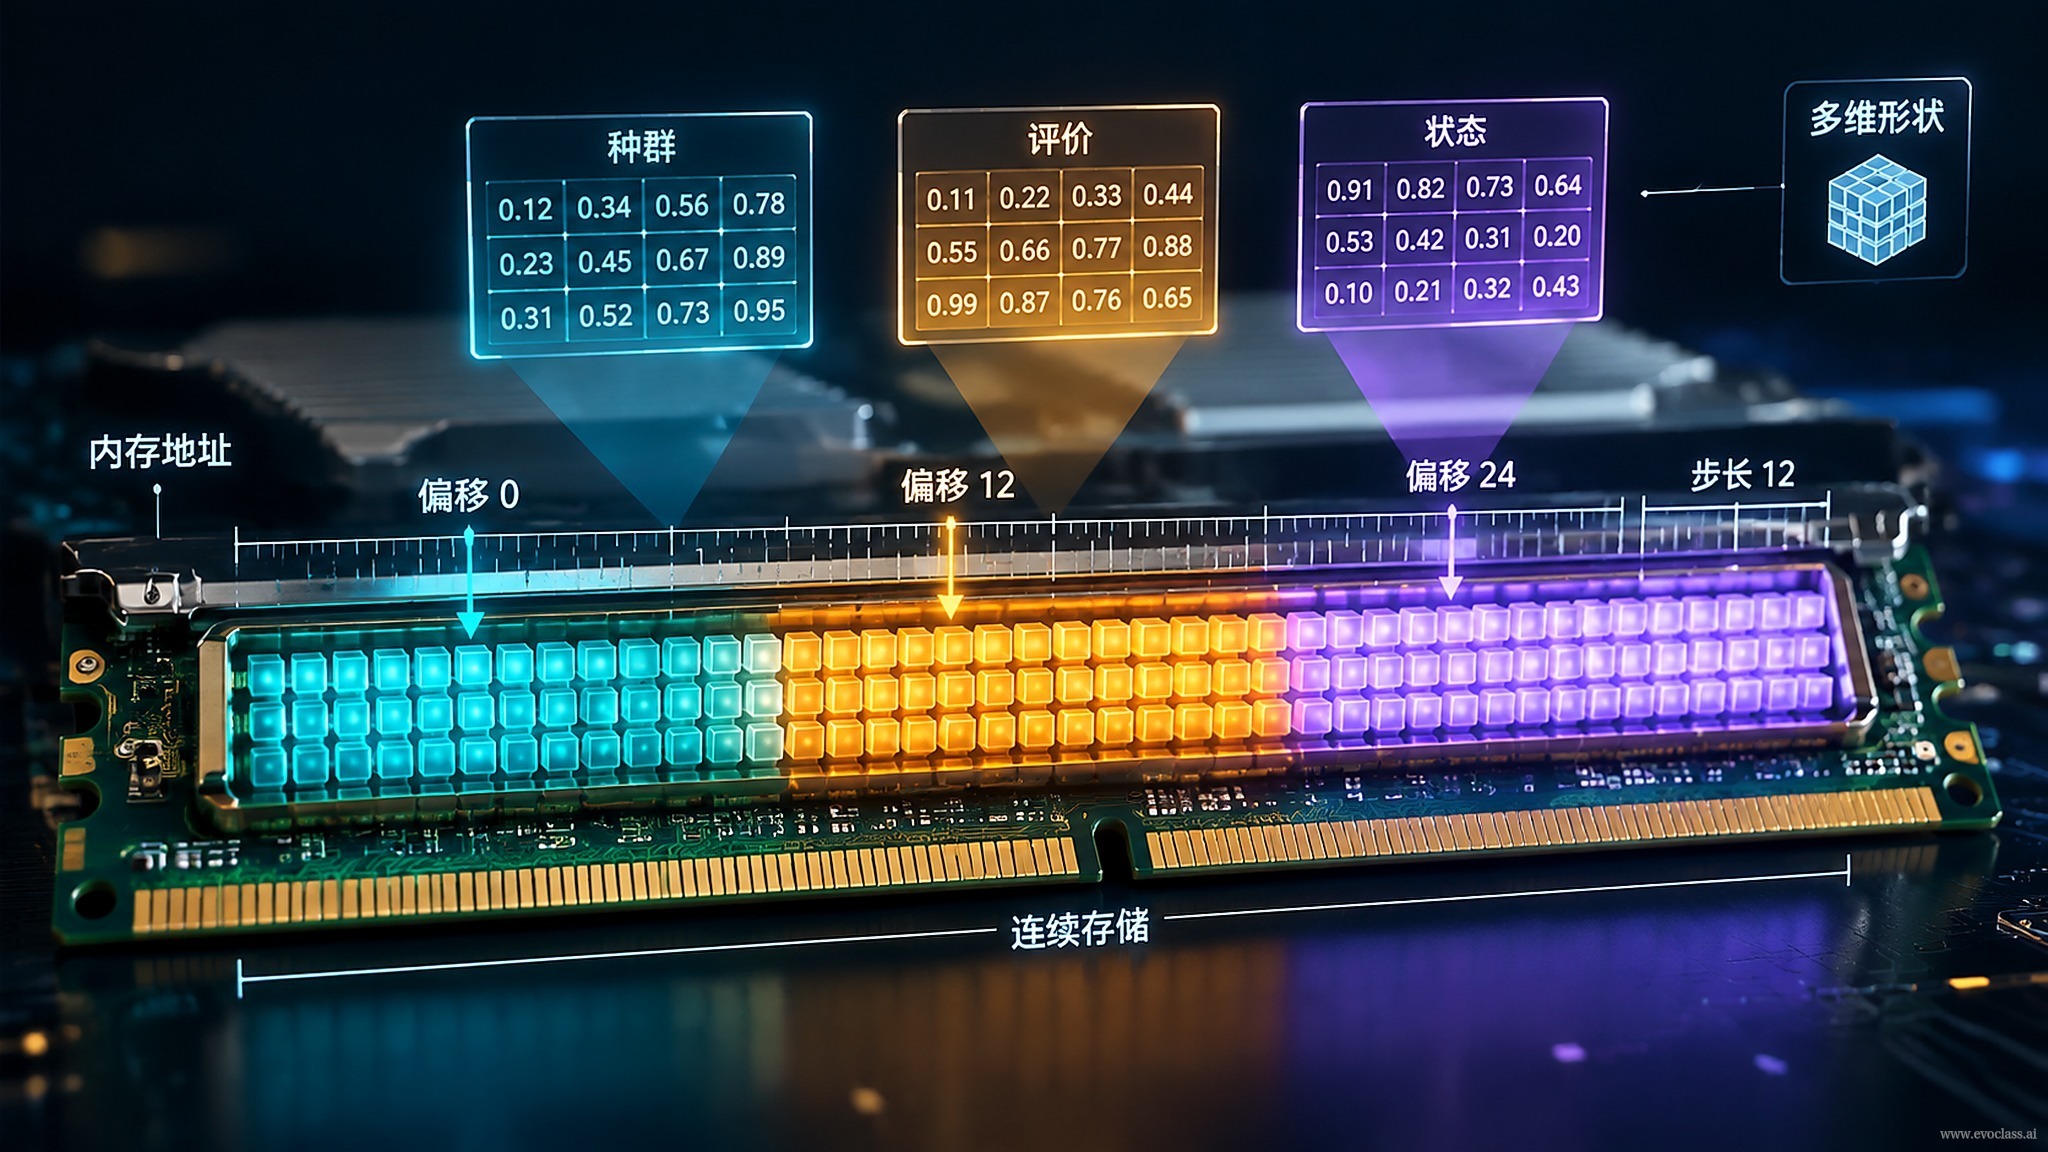
在演化算法的工程实现中,张量化组织把“种群是什么、评价得怎样、运行到哪一步”从零散对象与列表统一映射为规则张量。其本质是建立种群、评价与状态的统一数据契约,使批量计算、设备驻留与后续并行调度具备共同内存语义。
种群张量化:编码为 [N, D]
将 N 个候选解按批维组织为形状 [N, D] 的编码张量。连续变量、离散变量或多段编码可用字段张量或分组块表达,并保持统一数据类型与设备位置。
- 批维在外:通常将 N 置于最外层,使同一算子在整批上向量化执行。
- 字段分块:若个体由多段参数组成,可拆成 [N, D1] + [N, D2] + … 并保持连续存储。
- 变长处理:变长个体用填充加掩码或分桶处理,防止异构结构破坏整批计算。
评价结果矩阵化:[N, M] 与 [N, K]
一次批量评价产生 [N, M] 适应度矩阵;多目标、多约束与附加指标可并列为 [N, M+K] 或分表存储,避免逐个体循环调用评价函数。
状态张量统一管理
代数、随机数状态、策略超参、最优解、历史缓存、排名或采样状态等也进入张量或结构化状态容器,保证可复现、可追踪与可批量更新。
实例:N=1024, D=50, M=2
种群表示为 [1024, 50] 张量,评价值为 [1024, 2] 张量,约束为 [1024, K]。代数 generation、最优解 best_x、随机状态 rng_state 作为状态张量统一驻留设备。每代更新可在同一批维上整体完成,而非逐个体 Python 循环。
组织收益与边界
统一张量能减少主机与设备间往返、降低循环开销,并为后续算子并行提供数据基础;但需处理掩码有效性、填充浪费、多目标规模增长与状态同步成本。
种群、评价与状态的张量布局
种群编码为[N, D]张量、一次批量评价得到[N, M]适应度矩阵,多目标或约束可扩展为[N, M+K];代数、最优解、随机数状态等也作为张量统一驻留设备,使每代更新在同一批维上整体完成,减少主机与设备间往返与逐个体循环开销。
种群、评价与状态的张量布局
种群编码为[N, D]张量、一次批量评价得到[N, M]适应度矩阵,多目标或约束可扩展为[N, M+K];代数、最优解、随机数状态等也作为张量统一驻留设备,使每代更新在同一批维上整体完成,减少主机与设备间往返与逐个体循环开销。