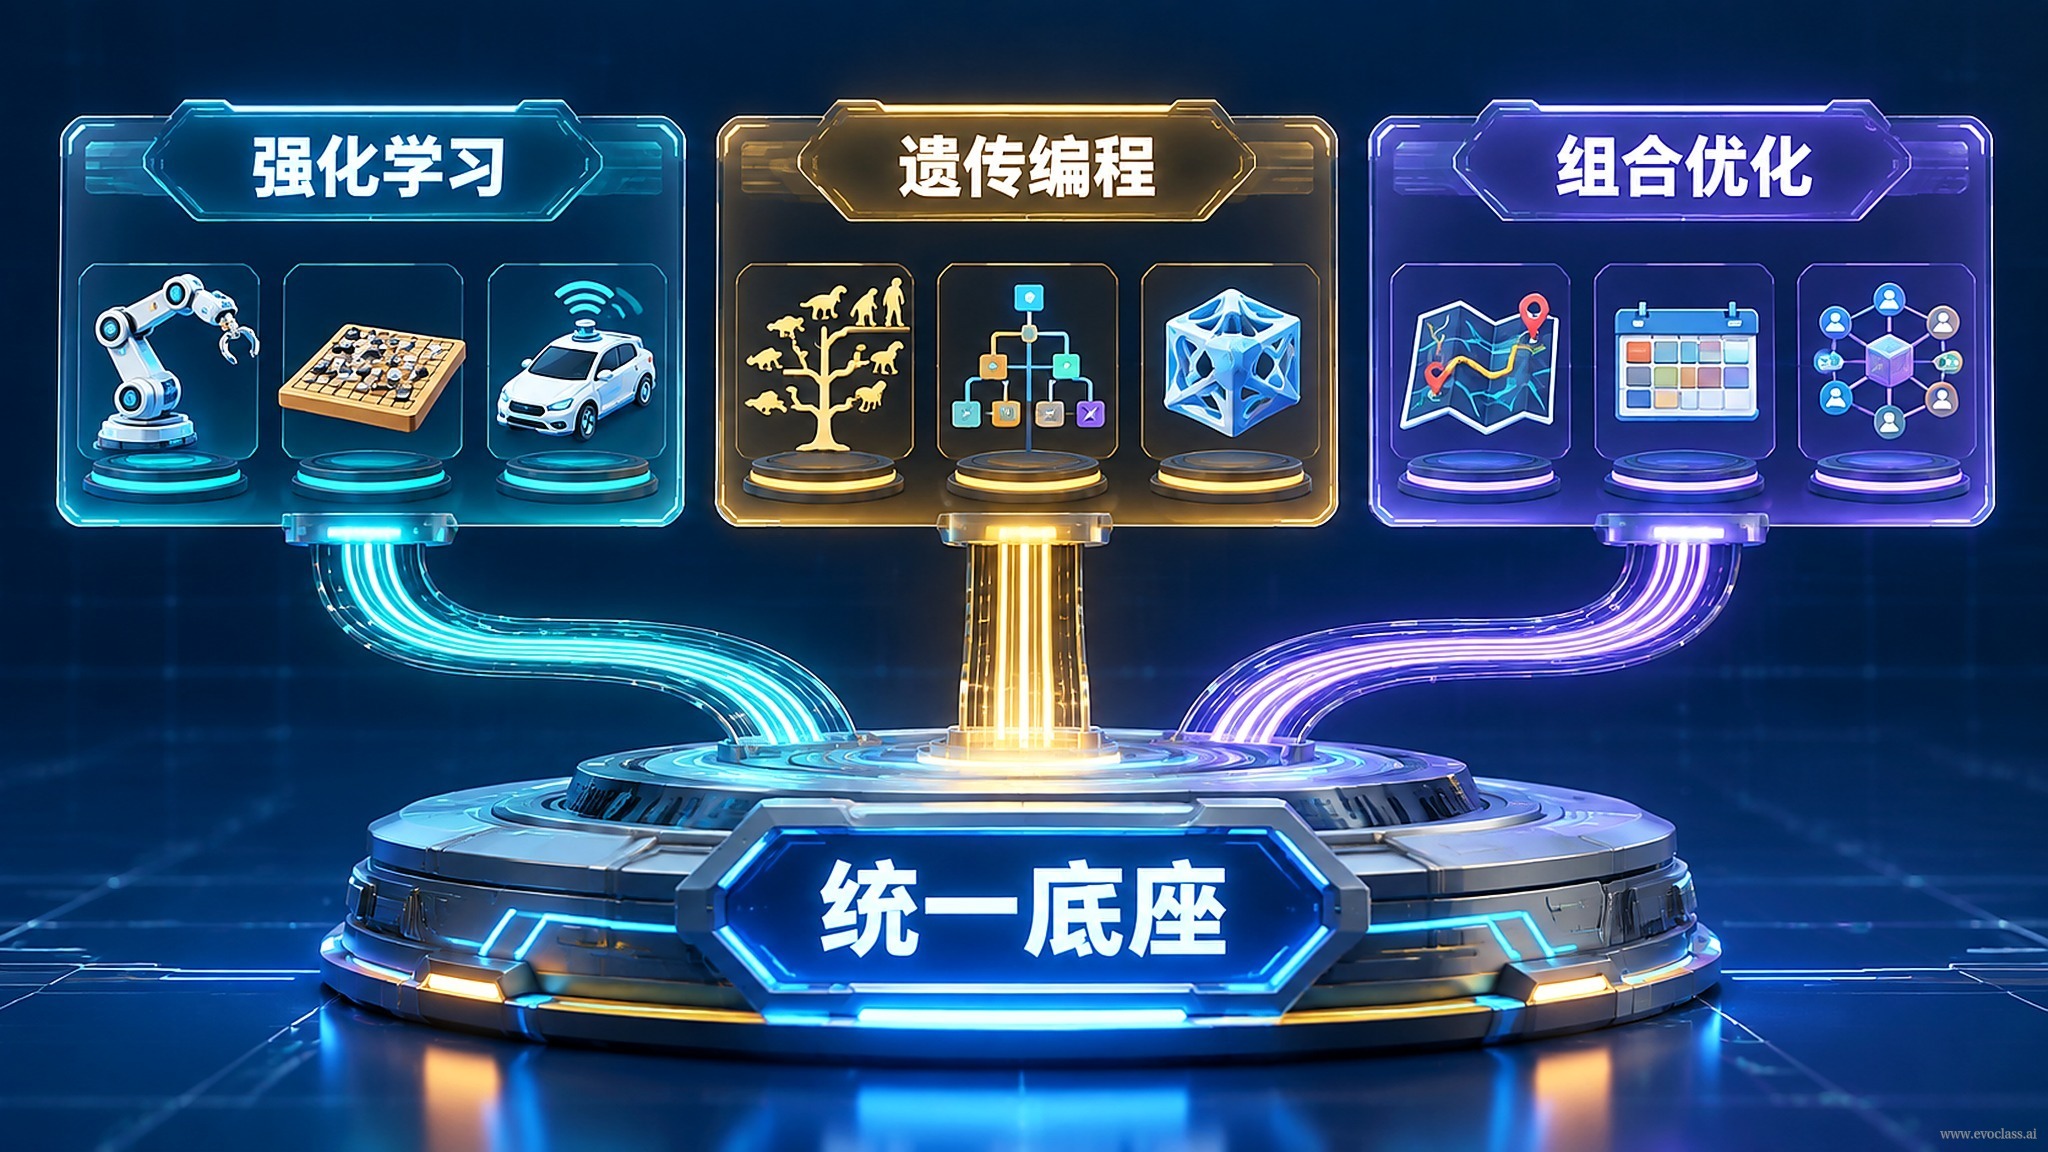
真实工程中的问题形态高度异质:控制与决策任务需要与不断变化的环境持续交互,结构设计任务需要在可变长度的程序与表达式空间中搜索,资源分配与路径规划任务则要在离散的排列与约束中求解。如果为每一类问题单独重建一套系统,评价接口、状态存储、算子库与算力调度都要重复实现,工程迁移成本极高。统一底座的核心思路,就是用同一套演化基础设施承载这些异构任务,让多领域应用共享评价、状态、算子与算力管理。
统一底座由三根支柱构成:开放接入(用统一的注册与接口规范接入任务)、张量化执行(把候选解组织为批次,批量并行评价)、运行时调度(在异构算力上分配任务并维护状态)。三者共同保证跨领域复用,也解释了为什么“为强化学习、遗传编程及组合优化提供了统一的开放接入底座”这一能力值得单独讨论。
三类典型任务如何落到同一底座
- 强化学习:底座提供并行环境交互能力,支持多环境实例批量采样、一批候选策略并行评价,并与演化优化形成闭环。
- 遗传编程:底座支持程序树等变长、层次化结构的演化,可在统一种群与评价流程中处理结构表示及其变异、交叉。
- 组合优化:把离散决策、选择、排列与约束目标适配为张量化求解,通过批量候选与并行评价提升搜索吞吐。
共享什么,适配什么
领域差异由适配层吸收:强化学习重在环境步进的并行,遗传编程重在程序树结构的演化,组合优化重在离散决策到张量的映射。三者共享底层 Runtime 调度与状态管理——共享评价流程、状态载体、算子组织方式与算力管理,而不是为每类问题重建系统。判断边界是否划对,可以问一句:如果把某个领域的专有结构直接写进共享调度逻辑,说明抽象层级选错了。
本页范围
本页聚焦“统一底座能支撑什么”,不展开具体性能对比与调度器实现细节;后者留给后续计算效率与批量张量方法部分继续讨论。
统一底座的支柱与三类任务映射
统一底座用开放接入、张量化执行与运行时调度三根支柱承载异构任务:强化学习侧重并行环境交互,遗传编程演化变长程序树,组合优化把离散决策映射为张量。三者共享评价流程、状态载体、算子组织与算力管理,领域差异由适配层吸收,避免为每类问题重建系统。
统一底座的支柱与三类任务映射
统一底座用开放接入、张量化执行与运行时调度三根支柱承载异构任务:强化学习侧重并行环境交互,遗传编程演化变长程序树,组合优化把离散决策映射为张量。三者共享评价流程、状态载体、算子组织与算力管理,领域差异由适配层吸收,避免为每类问题重建系统。