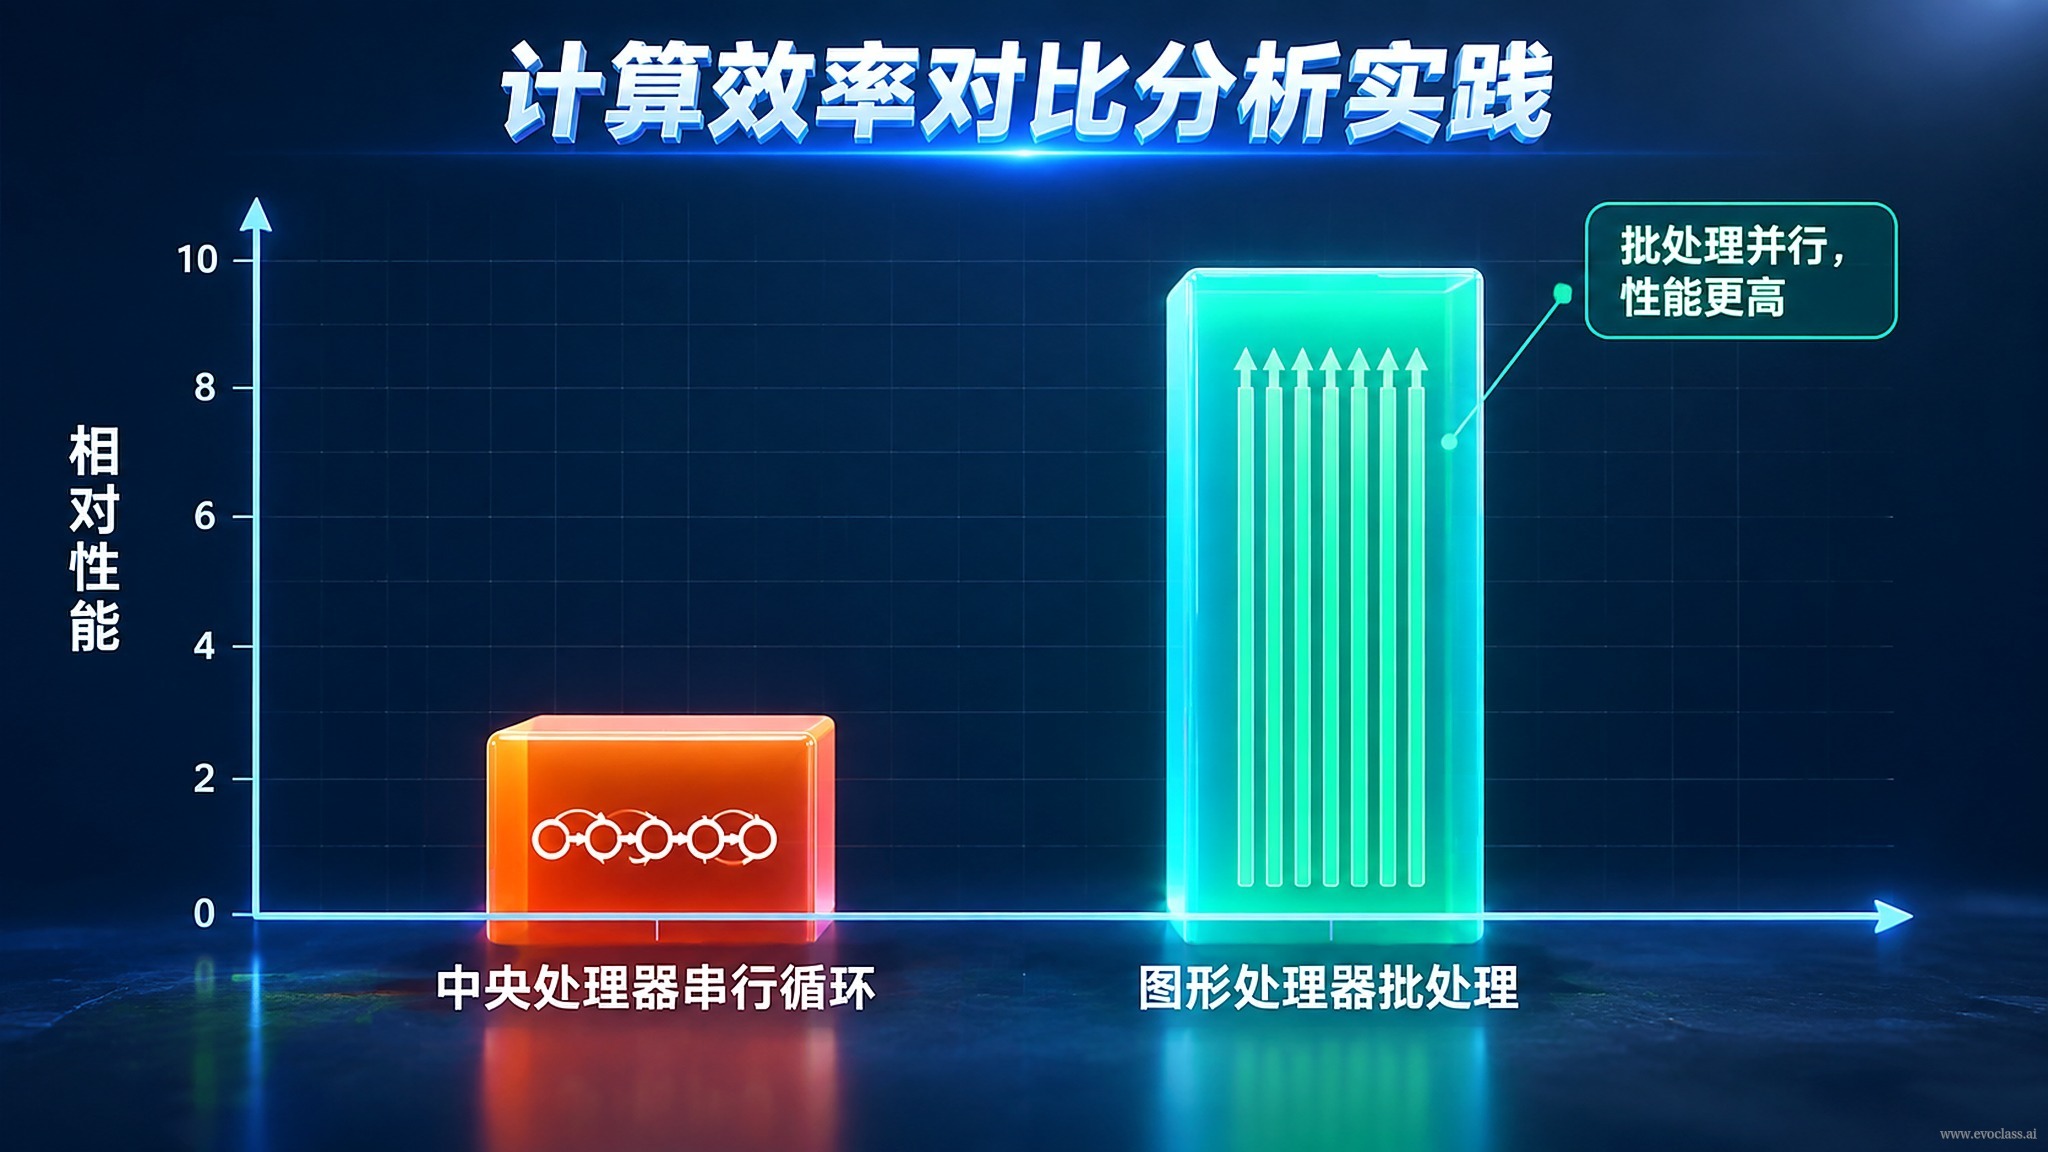
本页把「计算效率对比」落到一次可复现的实践上:在同一个演化任务上,比较传统 CPU 串行个体遍历与 EvoX GPU 张量批处理的端到端效率。目标不是记住「GPU 更快」这个结论,而是理解张量化并行带来的加速究竟来自哪里、代价是什么、边界在何处。
两条基线,同一任务
- CPU 串行基线:用循环逐个个体调用评价函数,每代需要 N 次独立调度、状态更新与结果汇总。循环控制、解释器开销和分散的内存访问会稀释有效算力,个体越多,这些「非计算」成本占比越高。
- GPU 张量对比实现:EvoX 把种群、评价输入与运行状态组织为张量,在 GPU 上批量执行评价与算子,一次调用覆盖整个候选集,从而大幅减少串行循环与调度次数。
度量协议:让对比可复现
可复现的对比必须固定问题、种群规模、迭代代数与随机种子,然后记录:每代 wall-clock、总耗时、吞吐(评估/秒)、加速比,以及 GPU 利用率与显存占用。计时前需要预热以排除首次编译与显存分配的影响,并在计时点做设备同步,同时把计算耗时与主机—设备数据传输耗时分开统计。缺少任一环节,得到的加速比都可能失真。
差异从何而来,又受什么约束
- 收益来源:批量并行、张量化算子以及设备内并行,使一次调用处理整个候选集,单位时间完成更多评价。
- 约束条件:批大小、问题维度、评价函数的可向量化程度、主机—设备拷贝开销与内核启动开销都会影响最终加速。批量过小会被启动开销吃掉收益;评价函数若无法向量化,批处理几乎无从发挥。
实践结论
正确的顺序是:先验证评价函数能否批量化,再对比 CPU 与 GPU 实现。效率优势最终应落到「在相同计算预算下获得更多代或更多候选方案」上,并据此决定部署方式与实验设计,而不是单纯追求一个漂亮的加速比数字。
CPU 串行与 GPU 批处理效率对比
对比中 CPU 串行基线逐个个体循环评价,每代需 N 次调度与状态更新,解释器与内存访问开销稀释有效算力;GPU 批处理把种群与评价输入组织为张量,一次调用覆盖整个候选集。加速比受批大小、评价函数可向量化程度与主机—设备拷贝开销约束。
CPU 串行与 GPU 批处理效率对比
对比中 CPU 串行基线逐个个体循环评价,每代需 N 次调度与状态更新,解释器与内存访问开销稀释有效算力;GPU 批处理把种群与评价输入组织为张量,一次调用覆盖整个候选集。加速比受批大小、评价函数可向量化程度与主机—设备拷贝开销约束。