在 EvoX 的张量化底座中,批量张量计算处于算法表达层:它把演化循环里的候选、评价与状态统一映射为带批维度的张量,再交给 GPU 友好的批量算子与编译计算图执行。目标十分明确——把“逐个体串行演化”改造成“整种群并行演化”,让算力真正作用在搜索本身,而不是消耗在调度与启动上。
一、把演化过程表达成张量
约定批维度 N 表示候选(个体)数,则演化中的三要素可以直接落成张量:
- 候选张量:种群 X 组织为 [N × D],D 是单个候选的决策变量个数。
- 目标张量:目标与约束 F 组织为 [N × M],M 是目标/约束项数;多目标情形下,各目标即 F 的不同列。
- 状态量:代数、当前最优值、步长等用标量或小张量缓冲维护,而不是用 Python 对象逐个体记录。
这样一来,交叉、变异、选择、评价全部沿 N 维批处理,演化循环中不再出现逐个体的分支与控制流。
二、批量算子:从 N 次单候选调用到一次批运算
三个最小可对照的表达式,勾勒出批量算子的基本形态:
- 变异:X′ = X + σ·randn(X),整批候选在一次批量运算中各自获得随机扰动,σ 控制扰动强度。
- 选择:idx = topk(F, k),在 N 个候选的适应度上一次选出前 k 个候选的索引。
- 评价:Y = fθ(X),用一次批前向或批仿真替代 N 次单候选调用。
关键并不在某个具体算子,而在于所有候选共享同一张张量运算图:一次批调用即可削减解释器开销与内核启动开销,使 GPU/多核算力真正作用于演化搜索。约束与越界处理同样可以用掩码张量在同一批运算内完成,不必为个别候选单独走分支。
三、计算图优化与吞吐量指标
把多代演化写成可编译的数据流图,还能进一步榨取性能:算子融合减少内核启动次数,批内并行让全候选同时执行,异步执行让计算与数据传输彼此重叠,内存复用减少中间张量分配。相应地,性能指标也应从“单步延迟”转向候选/秒或代/秒的吞吐量——批量执行下一次调用就处理整批候选,只有整体吞吐才真实反映搜索效率。
常见误区
不要把批量算子包在逐个体循环里,那等于把解释器开销与内核启动开销重新引入,批维度也失去了并行意义。判断标准很简单:一次演化步骤里,应该只有“批”而没有“个体”层级的调度。
批量张量计算核心方法导图
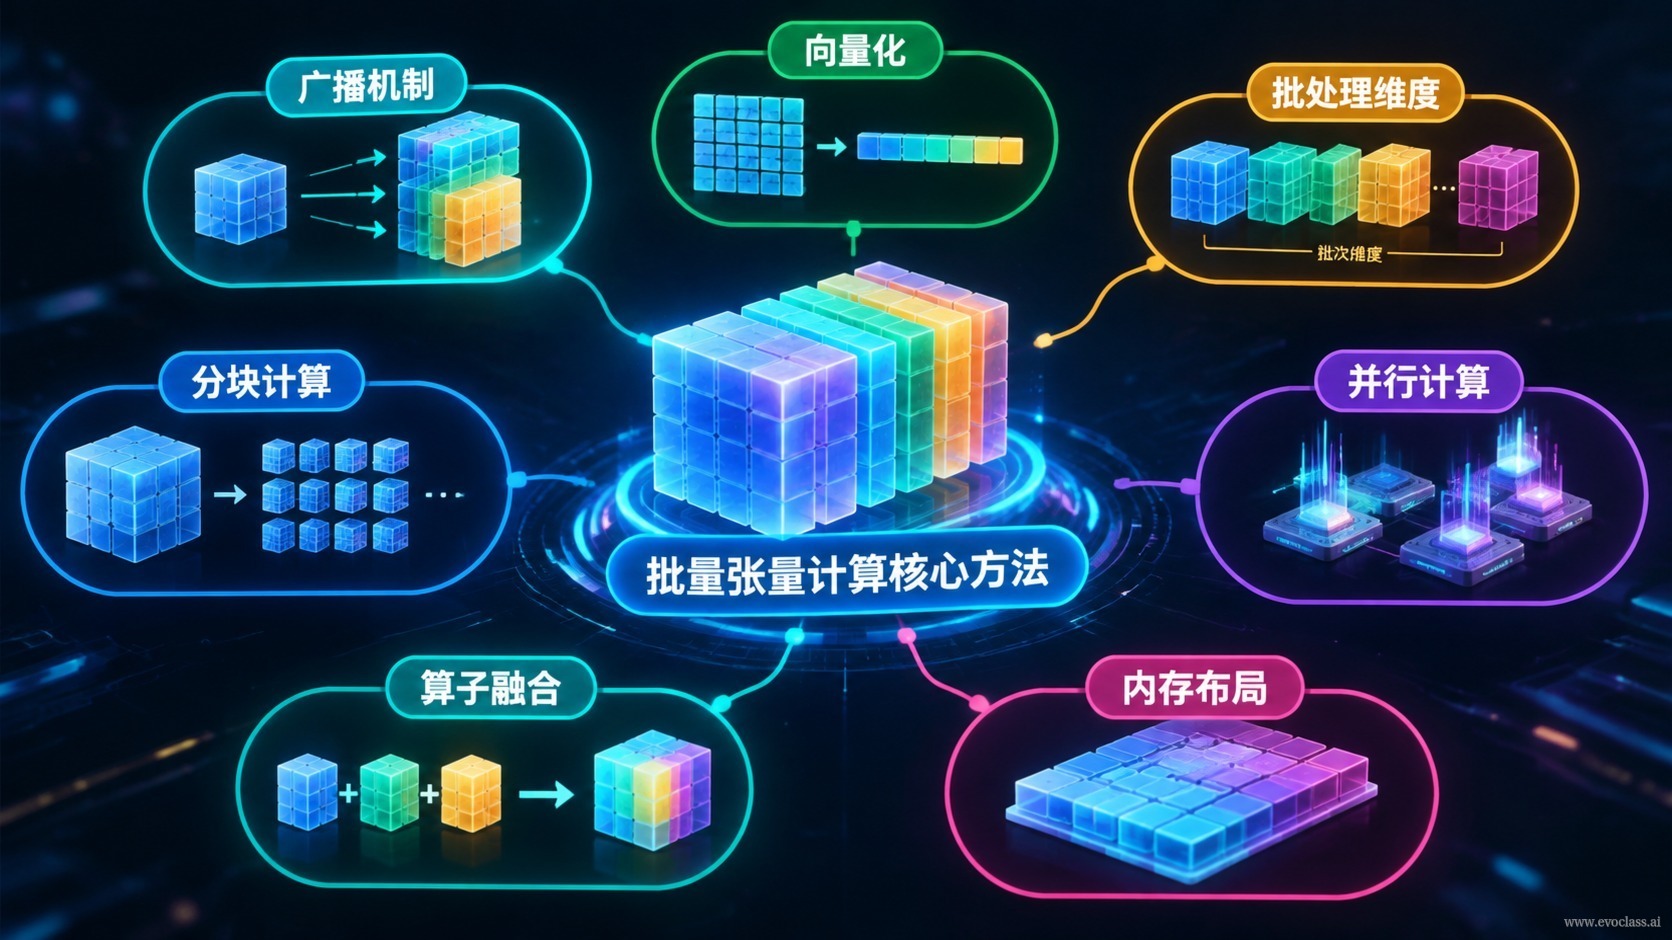
导图把演化过程表达为带批维度的张量:种群 X 为 N×D,目标与约束 F 为 N×M,交叉、变异、选择、评价全部沿 N 维批处理。变异、topk 选择与批前向评价只需一次批量调用,性能指标也从单步延迟转向候选/秒的吞吐量。
批量张量计算核心方法导图
导图把演化过程表达为带批维度的张量:种群 X 为 N×D,目标与约束 F 为 N×M,交叉、变异、选择、评价全部沿 N 维批处理。变异、topk 选择与批前向评价只需一次批量调用,性能指标也从单步延迟转向候选/秒的吞吐量。