EvoX 之所以能够支撑高强度并行演化探索,其基石可以概括为一句话:从候选列表到张量化计算图。传统演化实验把每个个体当作独立的 Python 对象,逐个建模、逐个评价;当候选规模扩大到成千上万时,真正的瓶颈往往不再是算法本身,而是逐候选的调度、同步与 I/O 开销。EvoX 的做法是:把种群、评价与运行时状态重新组织为可整体计算的张量,再由统一 Runtime 调度到 GPU 与异构算力上批量执行,从而支撑大规模、多目标、多解并行的演化搜索。
三大张量化对象
张量化不是对某一处做局部优化,而是贯穿演化循环的三个层面。任何一层退回逐对象循环,并行度都会在那一层被卡住。
- 种群张量化:个体参数、基因或策略不再逐个 Python 对象循环,而是按批次维度组织为张量,个体之间的差异由张量的一个维度承载。
- 评价张量化:适应度、约束、多目标指标以及仿真或模型评价结果可批量计算,同一批次内的候选共享一次设备调用,显著降低逐候选调度与 I/O 开销。
- 状态张量化:演化代数、随机种子、缓存与监控指标等运行时状态被统一管理,使并行加速之后的实验依然可复现、可追踪。
计算图化与统一架构
把候选列表提升为张量化计算图之后,算子并行与编译优化才有施展空间:种群规模与评价并行度可以随算力扩展,而不是被解释器循环锁死。与之配套的是统一架构——算法、问题、工作流与监视、Runtime 调度器相互解耦:算法可组合、问题可插拔、异构算力统一管理,使用者在写算法时不必同时操心底层调度。
这一底座最直接的收益是突破串行瓶颈:替代传统 CPU 串行循环,在 GPU 与异构算力上实现大规模加速,为高强度探索提供稳定的吞吐基础;在相同的墙钟时间内,可以探索更多候选、更多目标组合或更多随机重复。
例如,设一次演化实验需要评价大量候选方案。传统做法是在 CPU 上逐个候选调用评价函数,调度、同步与 Python 循环可能主导耗时;EvoX 将候选矩阵批量送入设备,由 Runtime 调度算子与评价,并统一记录状态与监视指标,使相同墙钟时间内可探索更多候选、更多目标组合或更多随机重复。这也正是真实世界多目标问题(例如超临界翼型设计中巡航升阻比与临界抖振升力系数彼此牵制)需要保留多样化候选方案时的工程支撑。
实践意义
当底层循环与调度工程被底座吸收,研究者可以把精力转向问题建模、目标权衡与实验假设的设计,而不必首先陷入底层循环与调度工程。这一分工既是高强度并行演化探索的前提,也为后续方法演化与 AI Native 科研提供工程基础。
EvoX 现代计算底座全景生态图
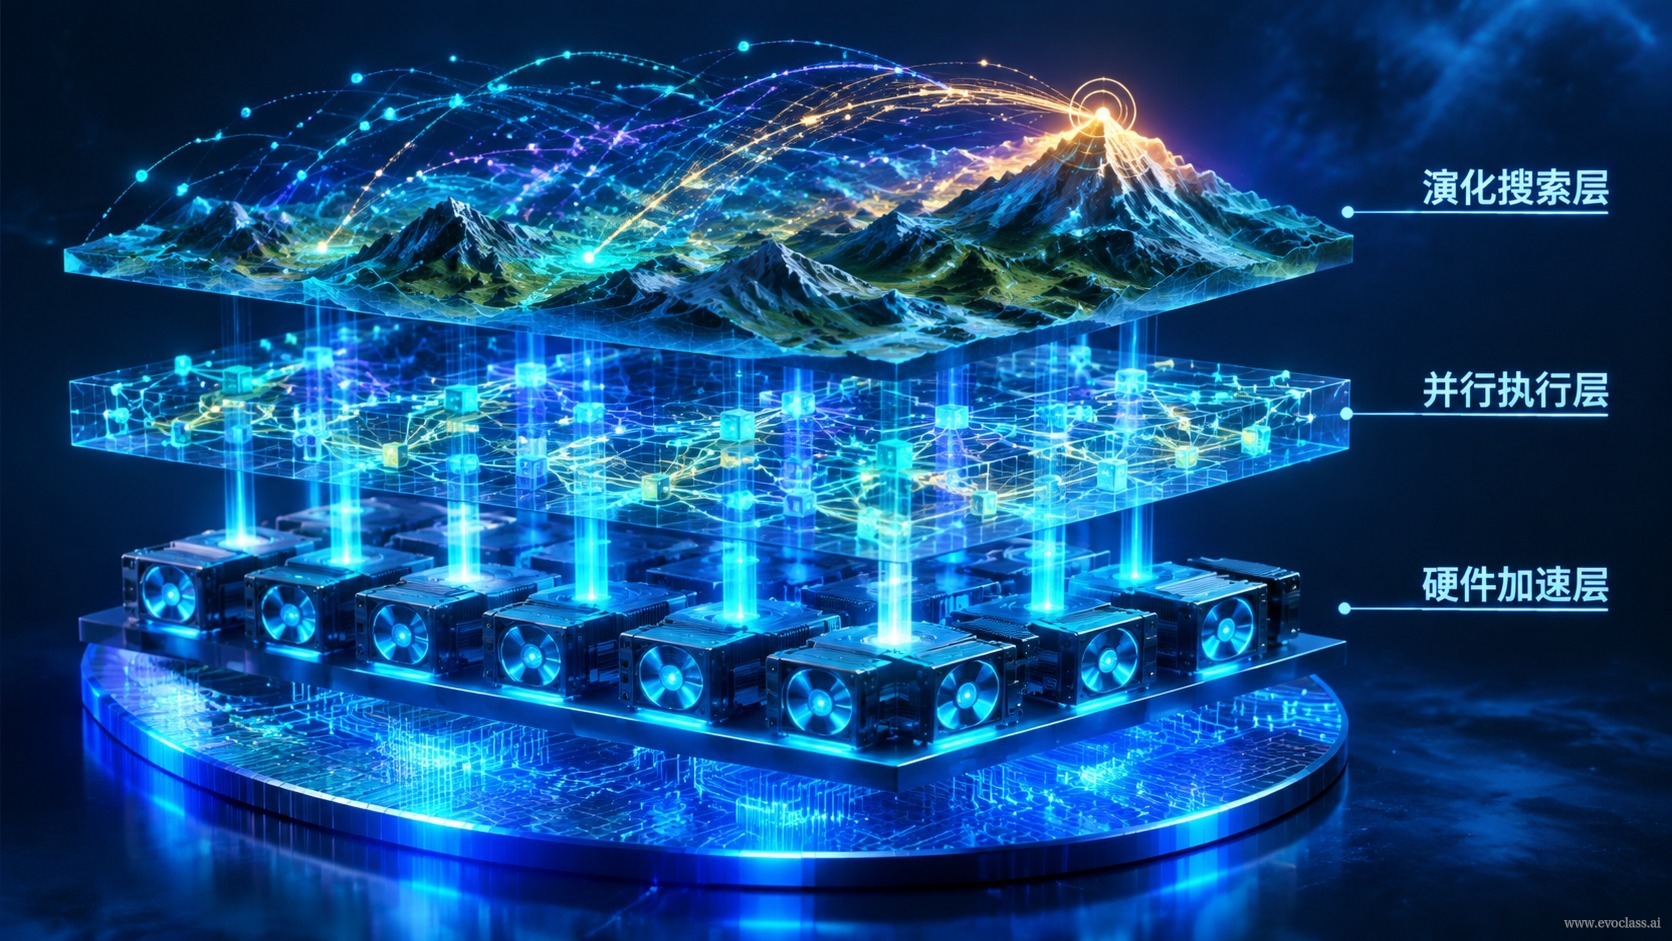
图示把 EvoX 底座概括为从候选列表升级为张量化计算图:种群、评价与运行时状态三层统一张量化,再由 Runtime 调度到 GPU 与异构算力批量执行。这样算法、问题、工作流与监视彼此解耦,算力扩展时并行度不被逐候选循环卡住,相同墙钟时间可探索更多候选与目标组合。
EvoX 现代计算底座全景生态图
图示把 EvoX 底座概括为从候选列表升级为张量化计算图:种群、评价与运行时状态三层统一张量化,再由 Runtime 调度到 GPU 与异构算力批量执行。这样算法、问题、工作流与监视彼此解耦,算力扩展时并行度不被逐候选循环卡住,相同墙钟时间可探索更多候选与目标组合。