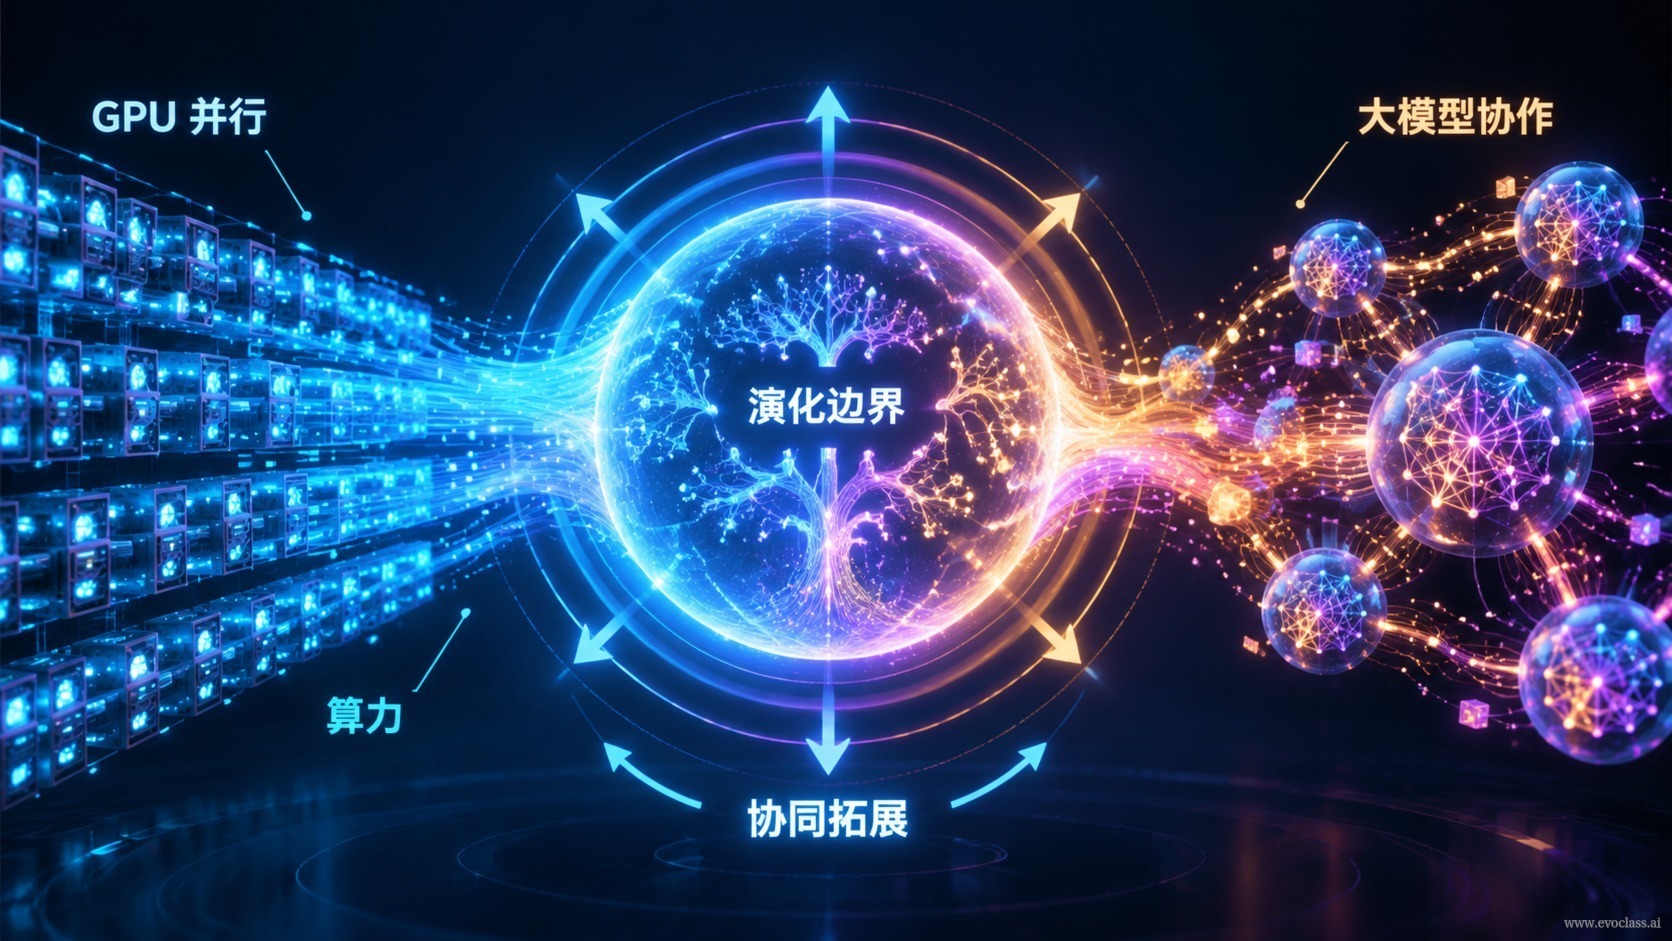
演化计算长期受制于一个现实问题:在有限时间内到底能评价多少候选。今天这一约束被两股工程力量同时松动——GPU 并行算力与大模型语义生成。它们共同构成演化计算的双重工程底座:算力决定“一次能探索多少候选”,大模型决定“能探索什么形态的候选”,二者一起把演化对象的边界从数值参数外扩到程序、模型结构与算法机制本身。
算力底座:把候选空间从串行搬到张量
传统实现里,种群评价是 CPU 上的串行循环:一次只处理一个个体,调度开销随种群规模累积。以 EvoX 为代表的开源底座把候选、评价结果与算法状态统一组织为可整体计算的张量:变异作用于整个种群,评价与状态更新同选择一起进入计算图接受编译优化。工程上的直接结果,就是“数万级候选同时探索”从实验室技巧变成常规做法。
这类底座把系统划分为算法、问题模块、工作流与 Runtime 调度器:研究者只需专注“如何演化”,Runtime 负责把批量计算调度到 GPU、加速设备或分布式集群。需要看清的是:算力解决的是吞吐,不是“聪明”。它不判断候选好不好,只负责把整个种群的适应度一次性算出来。它是候选空间扩张的底层支撑,但不决定候选长什么样。
语义底座:把候选形态从数值向量抬升到结构方案
大模型的贡献不在算得更快,而在于它理解代码、领域知识与任务上下文,具备语义级生成能力。因此它可以构造结构复杂的候选——一段可直接调用的求解代码、一个代理模型的拓扑结构——而不是只输出一个数值向量。候选的“形态”空间由此被打开。
演化对象边界的三级外扩
- 数值参数:经典设定,种群成员是固定结构下的一组参数值。
- 程序 / 模型结构:种群成员变成可执行代码片段,或网络与代理模型的拓扑结构。大模型的生成能力正是这一级的入口。
- 算法机制:连“怎么生成、怎么评价”的流程本身也进入被演化的对象。这正是后续“用演化改进演化”(如 MetaDE、AutoPSO)得以成立的前提。
以翼型优化为例:传统做法只能在若干预设的数值参数上做搜索;当大模型可以读写求解代码、构造代理模型结构,而 GPU 又能批量并行评价一个种群时,搜索对象就从“一组参数值”上移为“一套生成与评价方案本身”。
互补而非替代
两者是互补关系:算力扩大搜索广度,大模型提升候选的质量与形态复杂度;缺少任一方,边界拓展都不成立。只有算力而无语义生成,搜索对象仍被限制在预先写死的编码里;只有生成能力而无批量评价,海量候选无法在可接受时间内完成筛选。
边界外扩的代价
边界外扩同时引入新约束:一是评价成本上升,单次评价可能从毫秒级变成分钟级;二是正确性验证变难,生成的代码可能无法编译,或不满足物理与工程约束;三是“可用答案”的判定标准更模糊,需要与多目标权衡、专家决策等环节衔接。
GPU 并行与大模型协作拓展演化边界流程图
图示说明演化边界外扩依赖双重底座:GPU 与张量化 Runtime 把种群评价从串行循环搬到批量并行,决定一次能探索多少候选;大模型提供语义级生成,决定能构造何种形态的候选。两者互补后,演化对象可从数值参数扩展到程序/模型结构,再进一步到算法机制,但也会带来评价成本、正确性验证与答案判定标准等新约束。