真实世界的优化任务很少长成教科书里的样子:目标单一、约束清晰、存在一个可以写下来的最优解。工程与研究中的常态是,多个目标彼此牵制、彼此冲突——压缩充电时间往往折损循环寿命,提高气动性能常常推高阻力,放大评测量级就要付出成本与延迟。改善任何一个指标,通常都要在另一个指标上让步,因此不存在全局意义上“免费的最优”。这正是 EvoX 面向真实任务时的定位:不是尽早交出一个“唯一答案”,而是沿不同偏好方向并行探索,保留一组差异化的候选方案,把最终取舍交还给领域专家与真实约束。
一、冲突性:目标之间往往不可兼得
- 指标之间存在真实的折中关系:提升升力常伴随阻力上升,减薄翼型有利于气动却削弱结构强度。
- “最优”必须附带偏好说明:同一组候选方案,在偏重成本与偏重安全的两套偏好下会给出不同的推荐结果。
- 更准确的表述不是“找到最优解”,而是“在给定偏好下找到可接受且可解释的权衡解”。
二、解不是一个点,而是一组权衡解
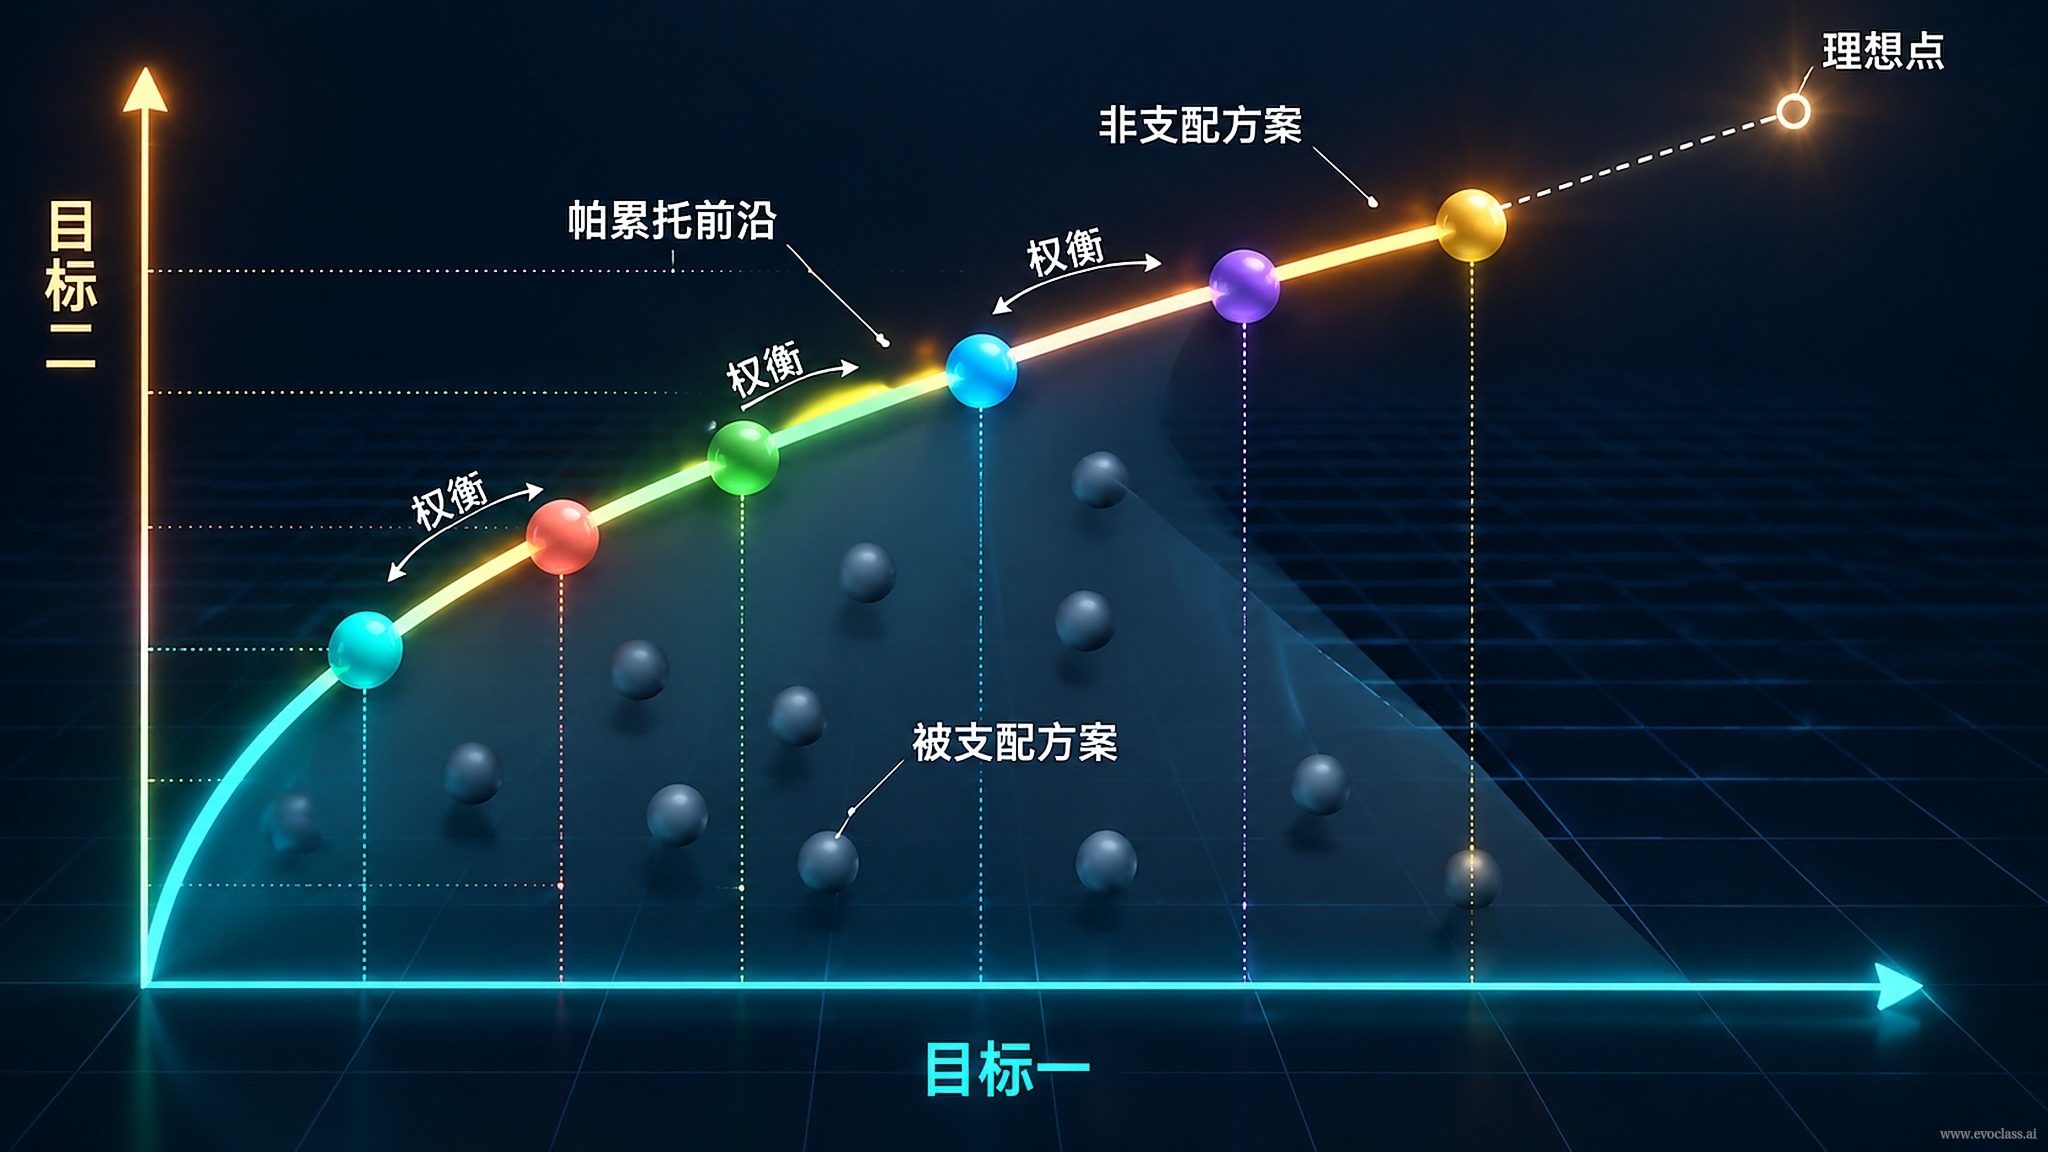
多目标问题的解集合称为 帕累托前沿:前沿上的每个点都代表一种合理的偏好取向,在不再恶化其他目标的前提下无法继续改进任一目标。前沿上的解彼此不支配,没有绝对排名,只有“在什么偏好下更合适”。
三、探索优先于收敛
- 过早收窄到单一解,会丢失方案空间的结构信息,使系统无法回答“如果约束变了,还有哪些备选”。
- 应维持种群多样性,让不同偏好方向同时被采样与评估,避免所有个体塌缩到前沿的一个狭窄区域。
- 差异化的价值在于响应变化:当工程约束、成本或风险发生调整时,决策者能够快速切换备选,而不必重新求解。
要让这种“沿多方向展开”真正跑得动,需要相称的计算底座。EvoX 将候选、评价结果与算法状态组织为可整体计算的张量,使变异、评价与状态更新作为整体进入计算图接受编译优化;Runtime 调度器再把批量计算分发到 GPU、加速设备或分布式集群。正因为张量化并行提供了高吞吐的批量评估,维持大种群、覆盖整条前沿才是工程上可行的选择,而不是被串行评价的开销压垮。
四、反馈稀疏、评估代价高昂
真实评估来自仿真、台架试验或试制,单次代价高、信号稀疏(可能只有通过/不通过,或带噪的少量指标)。这要求把有限预算花在能够扩展权衡空间的区域:用代理模型替代部分高保真评估,把额度投向不确定性高、又可能改善前沿覆盖的候选方案,并在整个前沿范围内保持采样广度,而不是只围着当前的“最优解”反复精修。
五、决策权归属
算法负责展开权衡空间,并提供可比的候选集合;人类专家负责依据场景偏好、法规与商业约束做出最终裁决。两者不可互相替代:算法替代不了对偏好与风险的判断,专家也无法手工穷举权衡空间的广度。
工程视角
交付一组帕累托解并附带“偏好—方案”对应说明,比交付一个看似精确的单点更可靠:约束一旦变化,团队手中有可立即启用的备选方案。
多目标帕累托前沿与候选方案分布
图示把多目标优化呈现为一条帕累托前沿:充电时间、寿命等目标相互牵制,改进一项往往要牺牲另一项,前沿上的解互不支配。EvoX 通过张量化并行维持大种群,沿不同偏好方向采样,保留差异化候选,供决策者按约束取舍。
多目标帕累托前沿与候选方案分布
图示把多目标优化呈现为一条帕累托前沿:充电时间、寿命等目标相互牵制,改进一项往往要牺牲另一项,前沿上的解互不支配。EvoX 通过张量化并行维持大种群,沿不同偏好方向采样,保留差异化候选,供决策者按约束取舍。