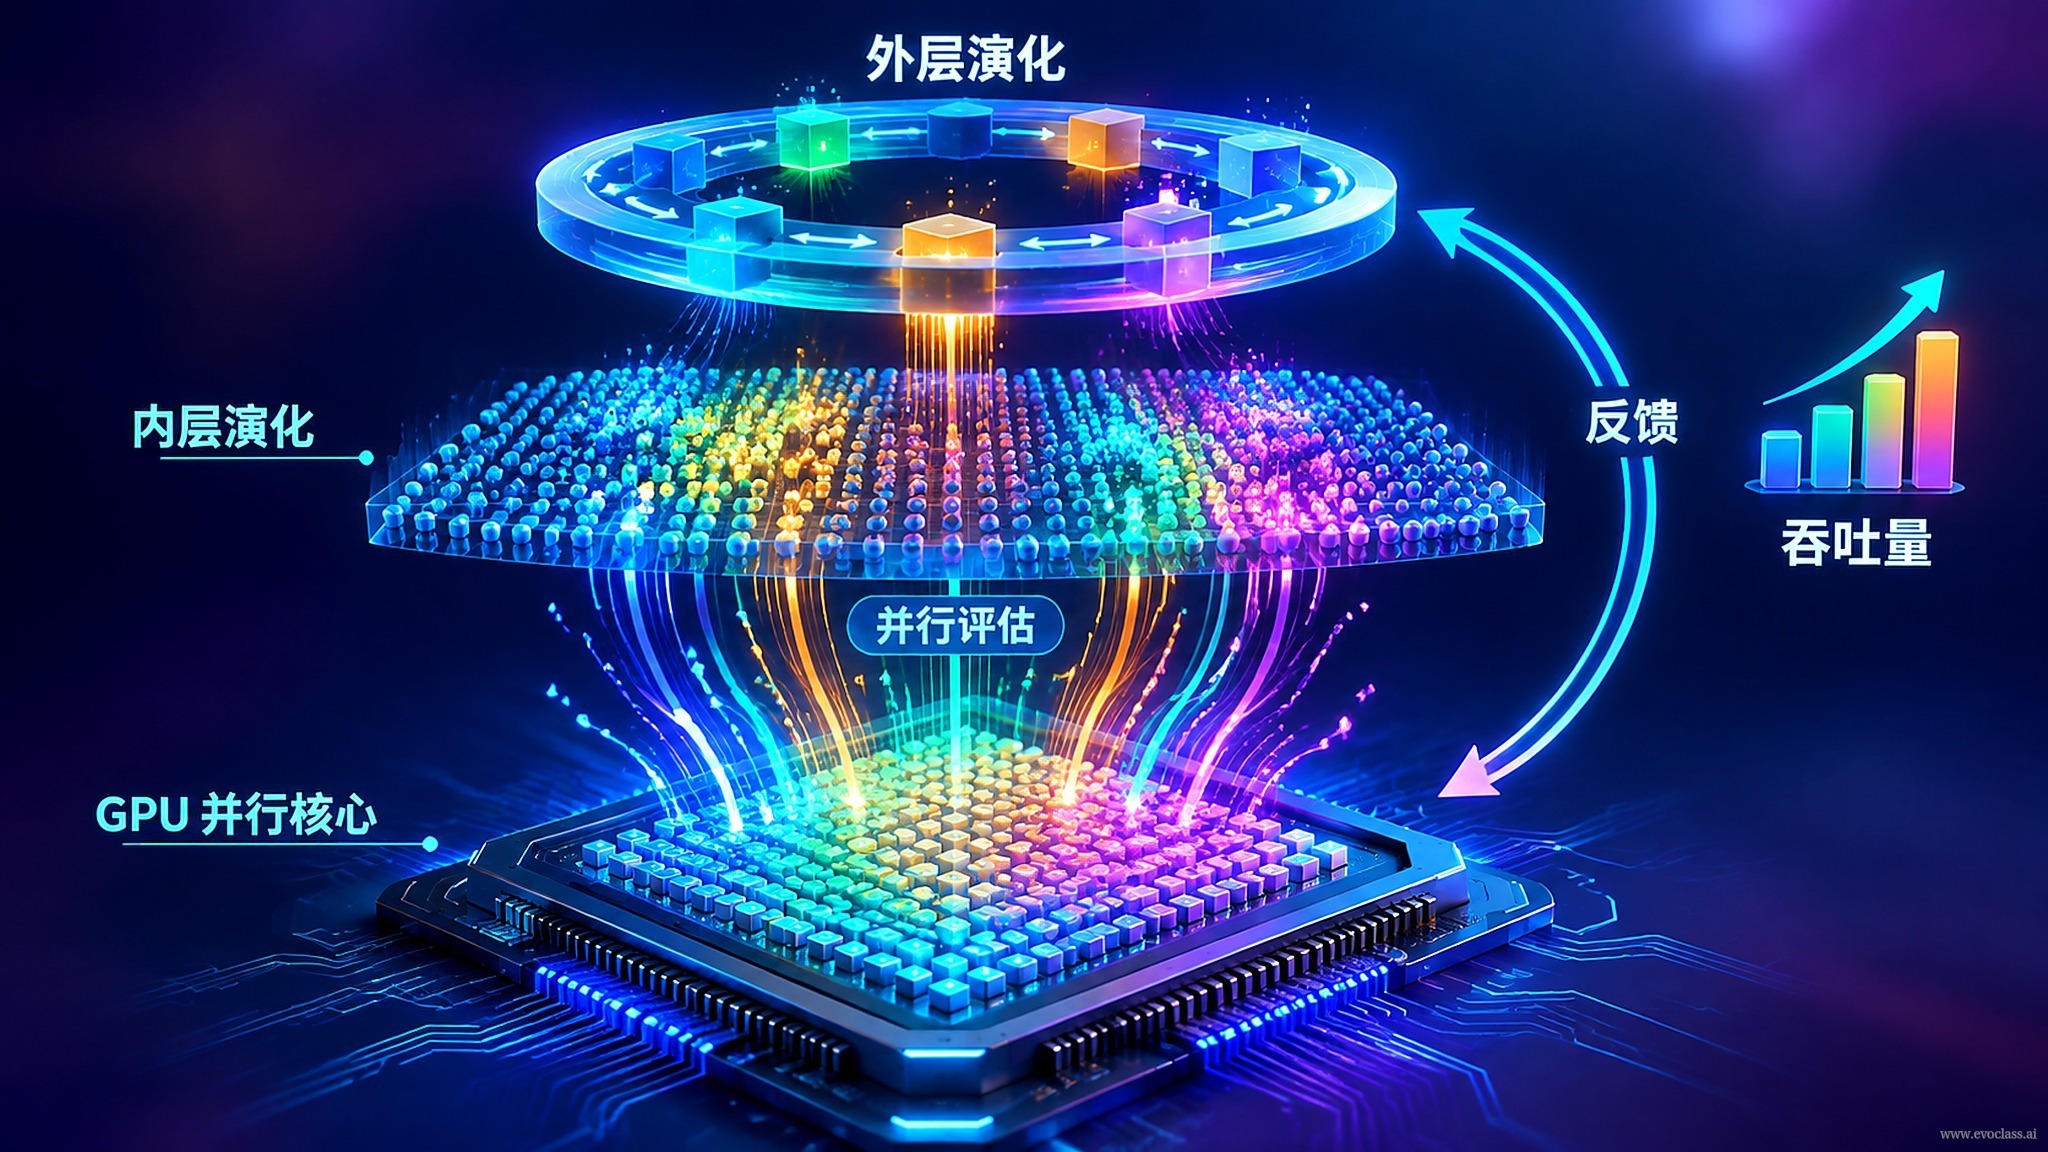
当演化算法被用来改进演化算法自身时,系统里同时存在两层计算:内层是大量算法配置在众多任务实例上的执行与评价,外层则依据这些运行结果选择、变异并更新配置。若没有强力的并行底座,外层演化会被内层的串行评价拖成瓶颈。GPU 并行正是把“用演化改进演化”从理论设想变成高吞吐可执行过程的关键:内层任务成批并行运行并不断产出表现数据,外层演化以这些数据为反馈,持续选出更优的算法配置。
两层各司其职
- 内层(执行与评价):在 GPU 上批量执行大量候选算法配置(不同超参数、算子或搜索策略),对每个任务实例完成运行与评分。任务粒度小、数量大,正好匹配 GPU 的批处理吞吐特性。
- 中层(反馈汇聚):把海量内层任务的原始表现汇总为统计指标,估计每个配置在整个任务分布上的优劣,形成供外层使用的适应度。
- 外层(配置选择):以统计反馈为输入执行选择、变异或更新,生成下一代配置并回送内层,构成闭环。
为什么 GPU 并行不可替代
在传统串行循环下,单轮迭代的墙钟时间由“候选配置数量 × 任务样本数量”共同决定,规模稍大就不可承受,串行循环因此成为限制候选配置与任务样本规模的主要瓶颈。GPU 并行让大量内层算法同时运行,把串行循环从“主要瓶颈”降为“可接受的批处理开销”,从而同时放大可探索的配置空间与任务样本量。
核心机制:一条闭环
整套系统可概括为 “内层任务并行吞吐 → 表现反馈汇聚 → 外层配置选择” 的循环:并行度越高,反馈样本越充分,外层对适应度的估计越稳定,配置改进的方向越可靠;改进后的配置再回送底层,进入下一轮并行吞吐。正是这条闭环,让算法具备了持续自优化的能力,也让“用演化改进演化”从理论设想变成高效可执行的过程。
易错点
不要把两层混淆:内层是“算法跑任务、打出分数”,外层是“演化挑配置”。反馈只能来自内层的真实运行表现,而不是外层的随机猜测或人为设定的常量。
GPU 并行双层演化吞吐架构
图示展示一条闭环:内层在 GPU 上批量执行大量候选算法配置并完成评分,中层把海量内层表现汇总为统计指标并形成适应度,外层据此选择、变异并生成下一代配置,再回送内层。并行度越高,反馈样本越密集,外层对配置优劣的估计越稳定,串行评价瓶颈也随之降为可接受的批处理开销。
GPU 并行双层演化吞吐架构
图示展示一条闭环:内层在 GPU 上批量执行大量候选算法配置并完成评分,中层把海量内层表现汇总为统计指标并形成适应度,外层据此选择、变异并生成下一代配置,再回送内层。并行度越高,反馈样本越密集,外层对配置优劣的估计越稳定,串行评价瓶颈也随之降为可接受的批处理开销。