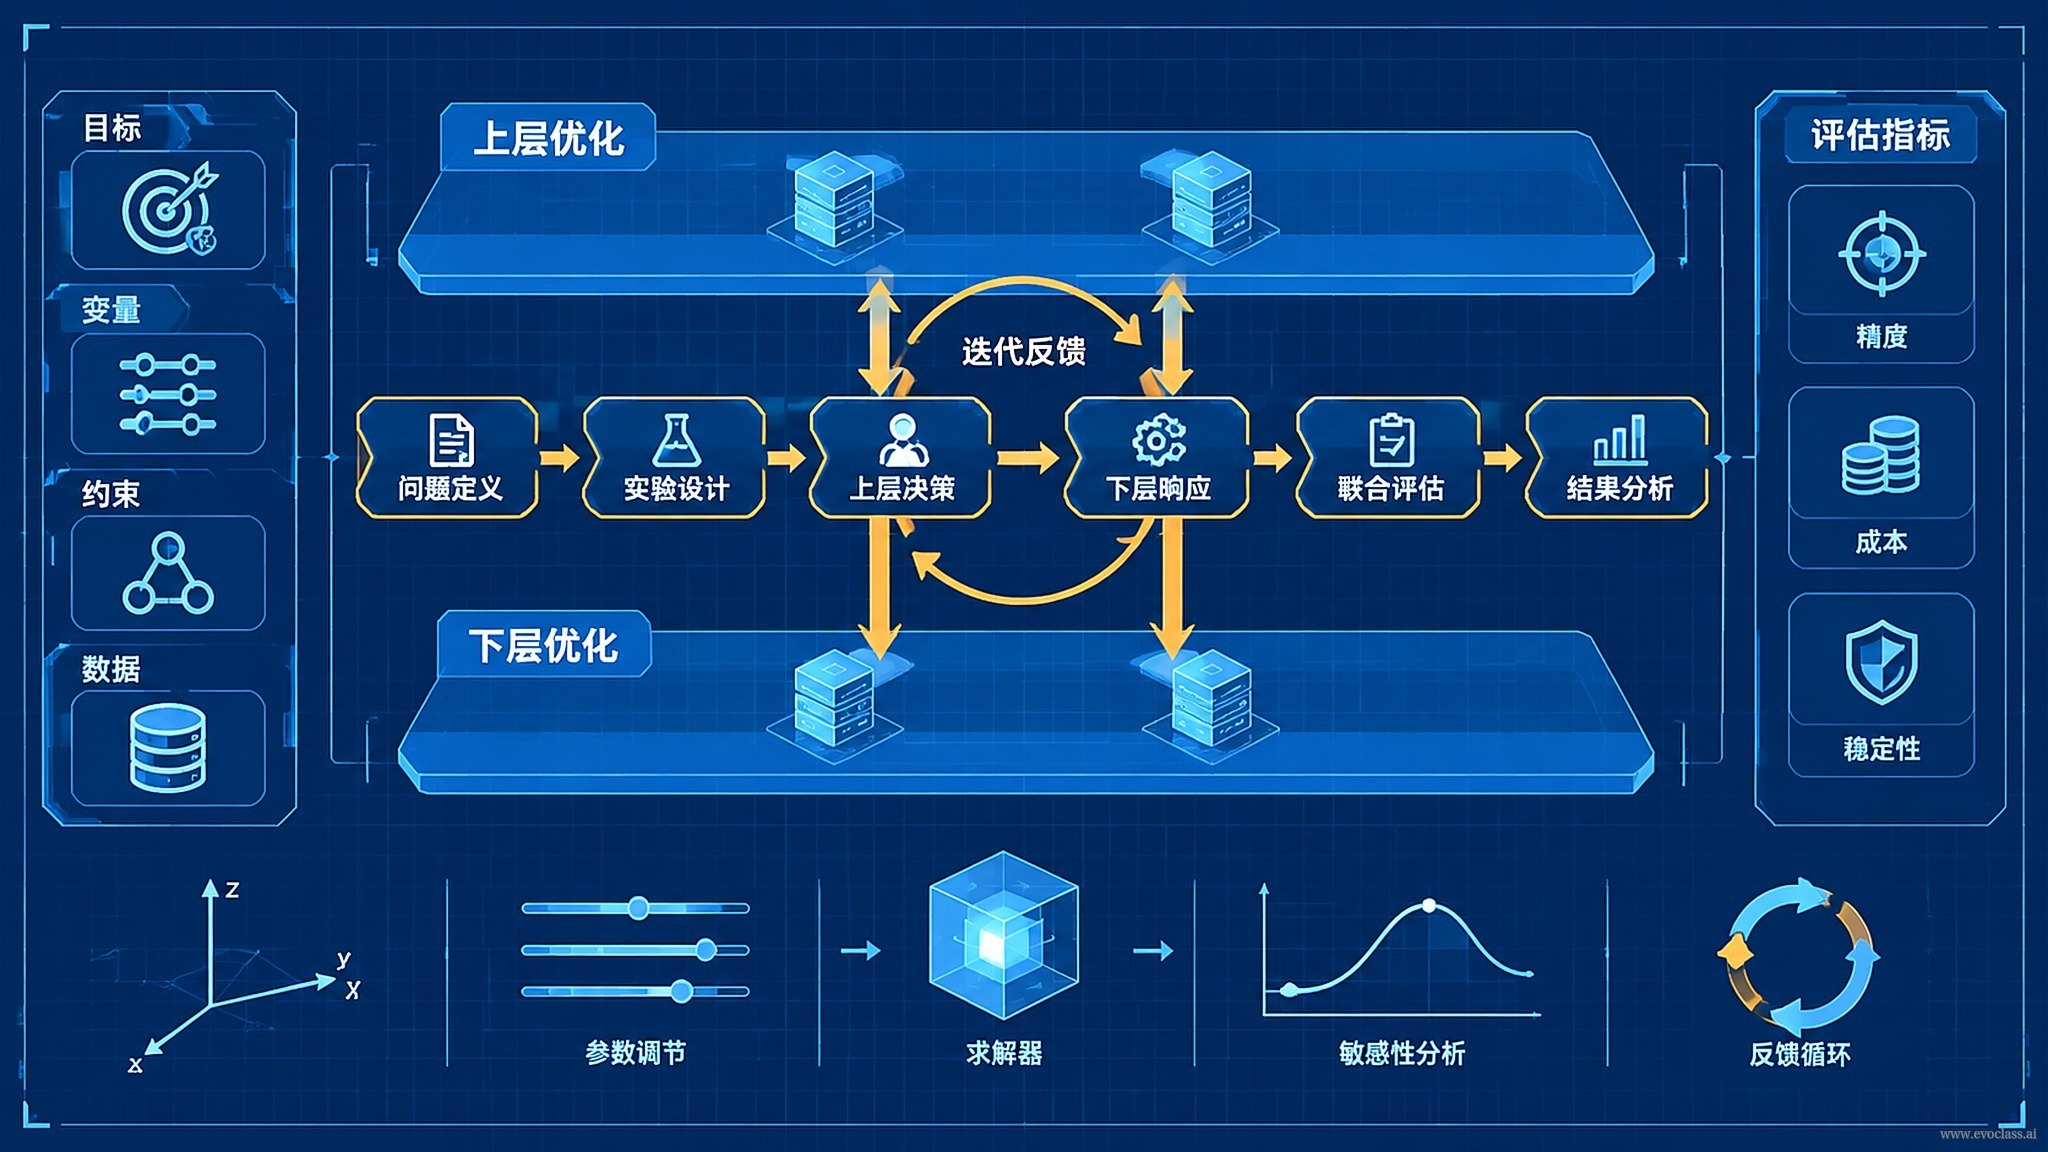
双层优化实验蓝图要回答一个具体问题:差分进化(DE)的变异因子 F 究竟应该设成多少。它的做法不是继续手调,而是把 F 从固定超参数提升为外层可演化的对象,把“用某个 F 设置去跑一次 DE 求解任务”作为内层评价过程;外层依据内层的任务表现更新配置。这套蓝图之所以跑得动,是因为它建立在 EvoX 的现代计算底座之上:种群、评价结果与算法状态被组织为可整体计算的张量,候选配置得以批量变异、批量评价并进入计算图接受编译优化,再由 Runtime 调度器把计算派发到 GPU、加速设备或分布式集群,从而把原本漫长的串行实验周期压缩到可接受的时间窗口。
内层任务:把表现变成可比较的信号
内层是一个可重复的实验。先选定一个优化任务或基准函数集合,再把 DE 的主体结构、维度、评价预算与随机种子集合全部锁定——唯一变化的量,就是外层传进来的 F 配置。每次运行都要记录:最优值、收敛速度(到达阈值所需的代数)、成功率、约束违反量、多目标指标(如超体积)以及候选多样性。这些记录就是外层能“看见”的全部信息,也是外层判断好坏的唯一依据。评价以张量化方式成批执行,同一批候选共用一张计算图,避免逐个体串行评价的开销。
外层策略对象:F 不再是一个常数
外层搜索的不是一个数值,而是一个 F 策略。常见的编码有三类:常数 F;分阶段常数,例如基因 [F1, F2, F3] 按代数区间切换;由少量基因控制的调度函数,例如按当前成功率、种群方差或代数比例触发不同的 F。策略型编码除了基因本身,还必须写明输入特征与输出规则,否则同一段基因在不同实现下会跑出完全不同的结果。
映射方式:基因型到运行时配置
从外层基因型到内层运行时配置的映射必须显式且可复现。例如基因 [F起, F终, 衰减] 映射为随代数衰减的调度:F(t) = F起 + (F终 − F起) × e^(−衰减 × t / T),其中 t 为当前代数、T 为总代数;基因 [F1, F2, F3] 映射为三段常数切换。同一个基因型必须永远映射到同一个运行时配置,否则外层学到的“好基因”无法解释,也无法迁移到新任务。
闭环流程与必录日志
完整回路是:外层种群生成一批 F 配置 → Runtime 调度器按张量化批次并行派发内层 DE 任务 → GPU 批量评价 → 汇总指标 → 外层选择、变异、交叉与更新 → 进入下一轮。这里沿用 EvoX 的分层组织:算法层承载外层的演化与内层的 DE 逻辑,问题模块提供基准任务,Runtime 调度器负责把批量计算派发到 GPU 或分布式集群,监视模块回收指标。闭环上必须留下可重放的记录:随机种子、评价预算、任务 ID、硬件型号与停止条件。任何一次“外层胜出”的结论,都应该能在同样条件下重跑出来。
边界条件与基线:三层防护
噪声防护:内层评价波动大时,单次运行的结果不可信,必须多次独立运行并报告置信区间;适应度可用均值、中位数或最差分位数聚合,同时把训练任务与验证任务分开,防止外层只对某几个幸运种子过拟合。成本防护:内层任务昂贵时,先用低保真模型或代理评价做粗筛,再对少数候选做高保真复评。基线防护:固定 F = 0.5 与经典自适应 DE 必须同台比较,并用消融实验确认收益来自外层演化本身,而不是来自更多评价次数。若外层搜索空间过小,双层优化会退化成手动调参;此时应该扩大编码空间,而不是单纯加大预算。
双层优化实验蓝图与流程
图示以差分进化变异因子 F 为例:内层锁定任务、维度、评价预算与随机种子,只让外层传入的 F 策略变化,并记录最优值、收敛速度、成功率、约束违反量、超体积与候选多样性;外层可编码常数 F、分段 F 或调度函数,经显式映射后批量评价并选择更新。闭环还需保留种子、预算、任务 ID、硬件与停止条件,以保证结论可重跑。