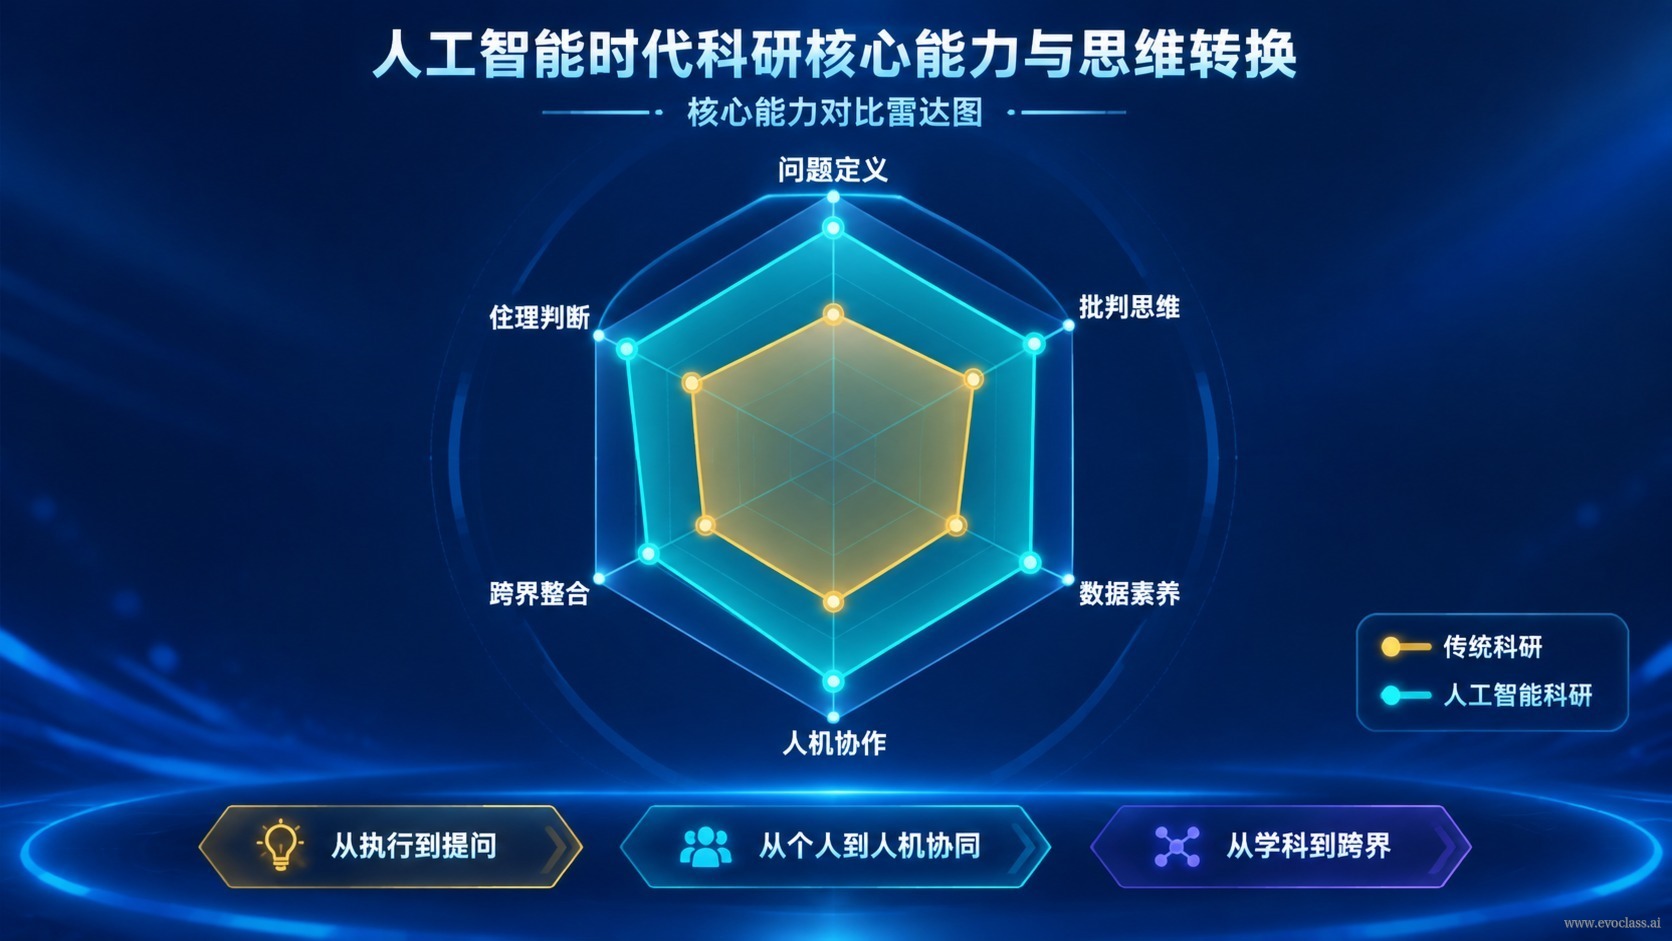
在 AI 辅助科研中,研究者的核心能力正在经历一次思维转换:过去我们用「能否亲手写出实现」来衡量能力,如今代码与实验脚本可由 AI 快速产出,真正稀缺的是提出关键问题、定义评价与公平比较标准,并对 AI 产出的证据做批判性判断。
职责迁移:从实现者到证据仲裁者
当实现成本被大幅压低,研究者的角色从「实现者」上移为问题定义者、实验设计者与证据仲裁者。AI 负责把想法变成可运行的答案,而「什么问题值得回答、什么证据值得相信」仍由研究者决定。
- 问题定义者:判断哪一类问题具有科学价值,而不是哪一类问题最容易出结果。
- 实验设计者:把模糊的想法转成可执行、可复现、可比较的实验协议。
- 证据仲裁者:对 AI 给出的曲线、指标与结论保持怀疑,追问其可信边界与失败条件。
三类必须由人回答的关键问题
- 改变对象:这次要动的是优化参数、程序实现、算法结构,还是研究流程本身?改动所处的层级不同,结论的意义也完全不同。
- 评价反馈:用什么指标观测、用什么代理信号近似真实目标、验收门槛设在哪里、什么情况判为失败——四者缺一不可。
- 公平比较:基线、预算、随机性、算力条件与统计检验是否对齐。不对齐的比较,常把随机波动或算力优势误读为算法进步。
为什么「品味」至关重要
AI 可以生成大量「能跑」的方案,但可行不等于有价值。Taste matters:在众多可行方案中判断哪个问题、哪个假设、哪份证据真正具有科学价值,这正是人类研究者的核心价值。相应地,能力重心从单纯的编码速度,转向批判性思维、系统抽象、领域判断与人机分工。
案例:EvoX / MetaDE 类任务
AI 可以在一天内生成几十个变异算子变体与配套实验脚本。但研究者必须决定:是改进变异算子、优化评价流程,还是重构搜索空间?并据此设定多目标指标与公平基线。否则得到的只是「能跑」的结果,而不是可信的知识。
核心能力迁移
这张图用能力对比的方式呈现 AI 时代科研能力的重心迁移:当实现可被快速产出,研究者更关键的价值转向提出关键问题、设计可复现实验、判断证据边界,并保证基线、预算与统计检验的公平对齐。
核心能力迁移
这张图用能力对比的方式呈现 AI 时代科研能力的重心迁移:当实现可被快速产出,研究者更关键的价值转向提出关键问题、设计可复现实验、判断证据边界,并保证基线、预算与统计检验的公平对齐。