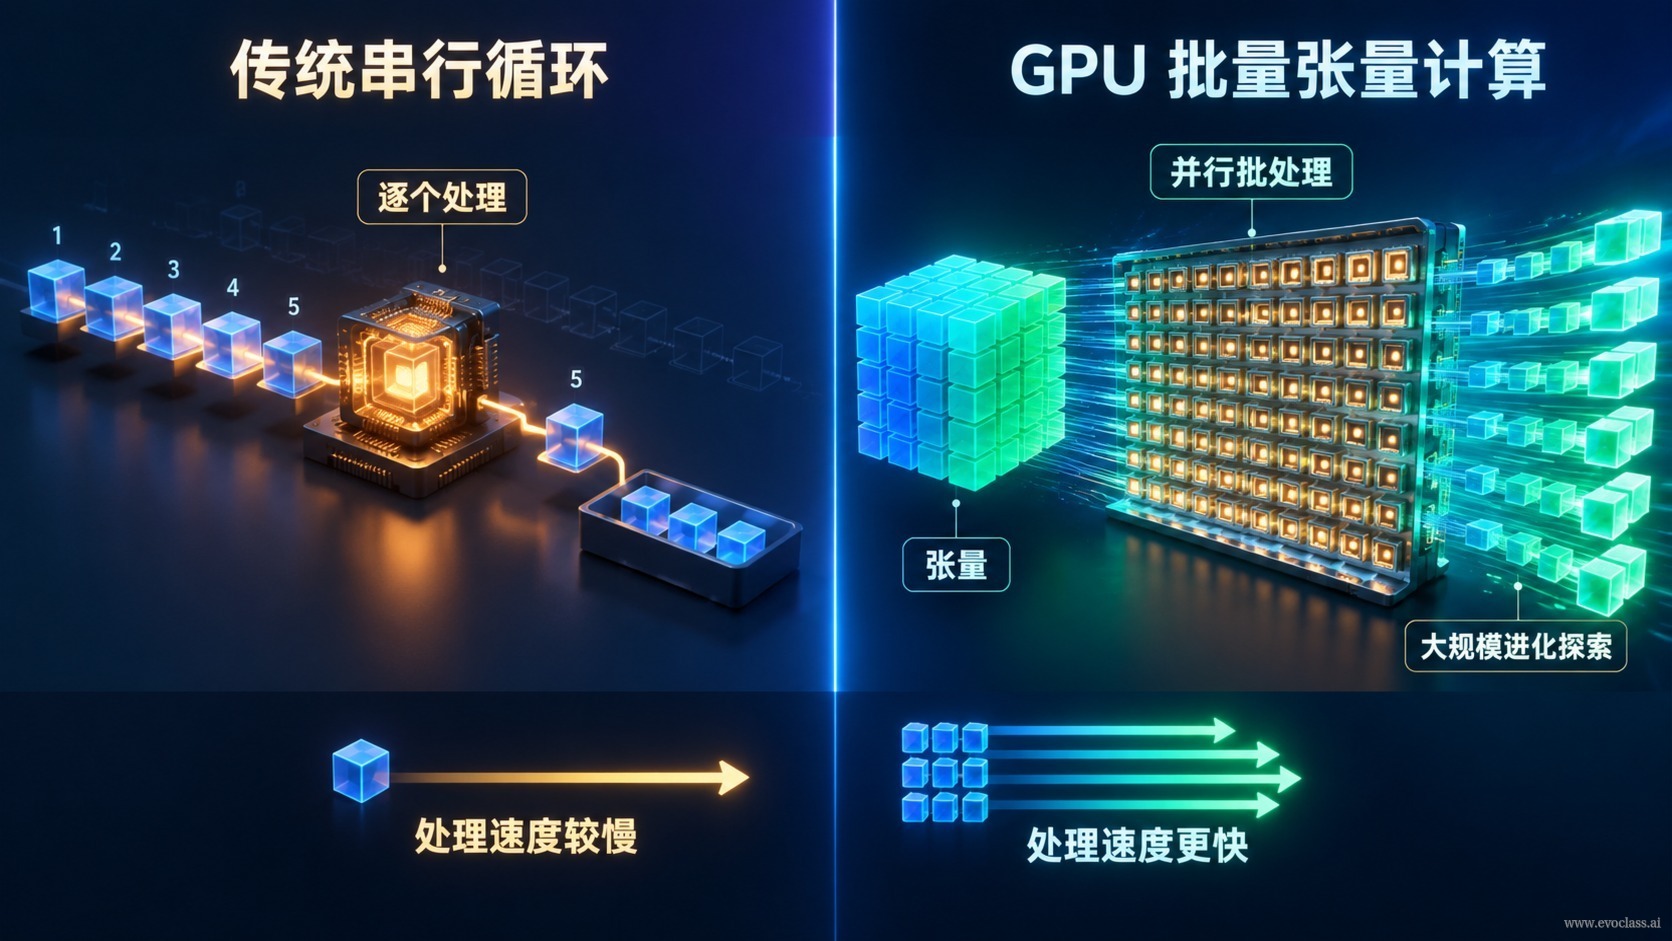
当种群规模从几十扩展到成千上万,演化计算的真正瓶颈就不再是“能否找到好解”,而是“能否在有限时间内评估足够多的候选”。EvoX 给出的工程答案是两条互相支撑的主线:张量化计算把逐个体串行循环改写成批量张量运算,统一架构则把算法、问题、工作流与 Runtime 调度解耦,使这套并行机制可以复用到不同的演化算法与任务上。
为什么多样性需要吞吐
演化搜索依赖种群多样性:候选越分散,跳出局部最优的概率越高。但“维持多样性”本质上是一道算力题——它要求每一代都能对大量候选完成评价与状态更新。如果产生候选的方法仍由人工预先固定、评价仍按个体逐个执行,系统就只能反复走既定套路,多样性带来的收益会被计算吞吐的瓶颈抵消。
方法演化:把“产生候选的方法”也纳入演化
当算力规模打开后,EvoX 把优化对象向上推进一层:不再只求解问题,而是把产生候选解的方法本身纳入演化对象,这就是方法演化。以 MetaDE 为例,内层算法解决实际任务,外层算法则演化内层算法的配置与策略(例如差分进化的变异策略与超参数),并通过 GPU 并行运行大量内层任务,让任务表现反过来指导外层配置的选择;AutoPSO 与 EvoGO 进一步通过组合粒子群组件、利用历史反馈学习候选生成方式,实现从“改参数”到“改算法结构”的跨越。这种内外双层演化天然要求同一代、乃至同一时刻有大量内层任务被批量评价与状态更新,因此对计算吞吐与并行能力提出更高要求。
张量化计算图:把循环换成批量张量
传统串行 CPU 循环通常按个体执行“评价—记录—更新”,每次只触发小规模算子,随之产生三类代价:调度开销高、算子碎片化、GPU 利用率不足。张量化计算图的做法是把种群维护、批量评价与状态更新整体组织为批量张量操作,让同一代甚至多代候选被并行计算。举例来说:同一代包含 N 个候选解时,串行实现按个体循环,而张量化实现把种群组织成一个张量,一次性完成批量评价与并行状态更新,从而显著降低调度开销、提升 GPU 占用率。
统一架构:让并行机制可复用
只把循环改写为张量还不够——如果算法、问题与调度逻辑彼此耦合,换一个演化算法或换一类任务就要重写一遍。统一架构通过把算法、问题、工作流、Runtime 调度等模块解耦,使张量化并行机制能够复用于不同演化算法与任务(如 MetaDE、AutoPSO 等方法演化场景);配合异构算力调度,可对 CPU、GPU 等资源进行批量任务级管理,从而支撑可组合、可扩展的并行探索。
为什么这是“底座”级能力
GPU 与大模型带来的工程底座,使张量化批量计算从局部优化上升为支撑系统级演化探索的基础能力。换句话说,张量化解决的是“跑得快”,开放解耦的统一架构解决的是“换得动”:前者提供吞吐,后者提供可组合、可扩展的复用边界。二者结合,才让高强度、高多样性的并行演化探索真正落地为工程能力。
串行循环与GPU批量张量计算架构对比图
左侧传统CPU串行按个体执行“评价—记录—更新”,只触发小规模算子,带来调度开销高、算子碎片化与GPU利用率不足;右侧把种群维护、批量评价与状态更新整体组织为张量运算,一次完成同代乃至多代候选的计算,并与Runtime调度解耦,使并行机制可复用于不同算法与任务。