大模型已经能够稳定承担强理解、生成与工具调用三类核心工作:把模糊需求解析为结构化任务、产出代码与文档、按需调用检索与仿真工具。因此,把大模型作为智能组件接入科研与工程流程,已经是现实可用的做法。
但必须区分两件事:能力增长与系统适应。模型再强,也只是某一次调用中的能力;真实的工程项目往往持续数月乃至数年,而单个 Agent 的上下文终会耗尽。如果经验无法沉淀,每一轮工作都要从零开始,能力增长也就不会自动转化为系统的长期适应能力。
一、能力组件:大模型究竟提供了什么
- 理解:把目标、约束与上下文解析为可执行的任务描述。
- 生成:产出候选假设、代码、实验设计与文档。
- 工具调用:连接检索、计算、编译与仿真等外部资源。
这三类能力回答的是“单次任务能不能做对”,却回答不了“长期任务能不能持续做对”。
二、把单次能力变成持续演化能力
要在真实世界中长期适应,智能组件必须被放进一个系统级闭环。由于单个 Agent 的上下文终会耗尽,而项目又要跨越多个任务周期持续存在,就需要把演化对象扩展为持续存在的软件世界,并依赖项目级持久化让经验不随单次实验丢失。这个闭环至少包含四个环节:
- 候选产生:由智能组件提出假设、修改或实现;此刻它们只是候选,不是结论。
- 真实检验:候选必须经过真实环境、仿真或实验的检验,并跨过编译、测试、行为检查与上层验收等关卡。
- 成果沉淀:只有通过检验的有效结果才被写入被接纳的项目版本,成为可复用的资产。
- 再演化:后续工作继承已沉淀的成果,在其基础上继续提出候选,进入下一轮循环。
Genesis 这类多 Agent 协作系统就是该闭环的一个实例:参与工作的 Agent 生命周期有限,上层执行者理解目标并递归拆解任务,下层执行者完成局部实现与测试,必要时继续向下递归;候选修改仅作为候选提交,必须通过编译、测试、行为检查与上层验收才被接纳,失败尝试被拒绝,通过验证的成果则写入项目版本,成为后续执行者的历史基础。在编译器重构与科学软件升级等场景中,这种机制展现出极高的可靠性和运行加速比。
三、关键区分:组件与系统闭环
因此,“大模型能力”与“持续演化系统”是组件与系统的关系,而不是替代关系。能力组件负责在单点产生高质量的候选;系统闭环负责判定哪些候选值得留下、如何留下、以及如何被下一轮继承。缺少闭环,能力越强只会产生更多未被检验的候选;缺少强组件,闭环则缺少高质量的候选来源。
常见误区
把“模型能力提升”直接等同于“系统能长期适应”。判断标准不是模型在某次任务中表现多好,而是有效成果能否被稳定沉淀,并被下一轮工作继承。
组件与系统闭环对比
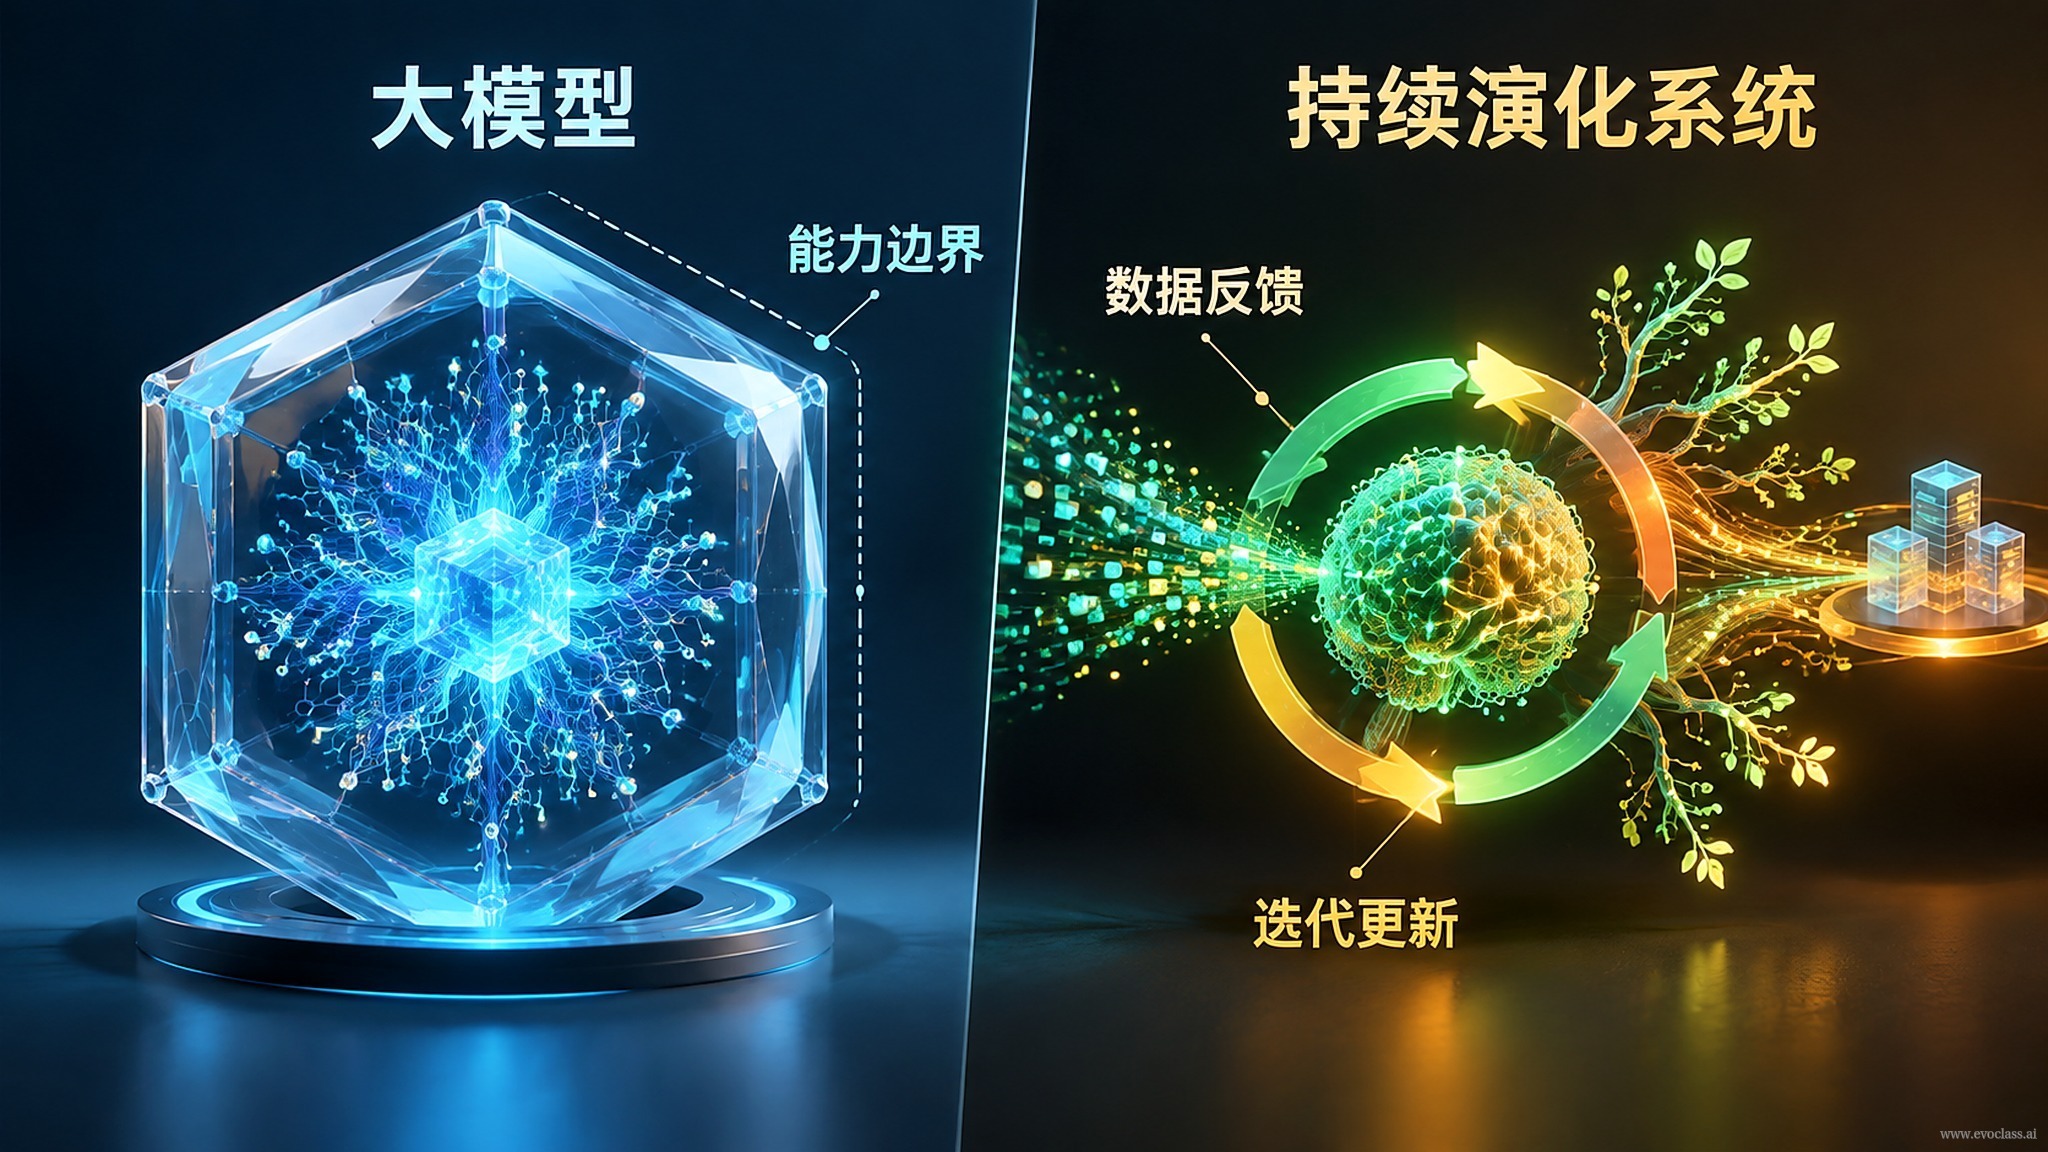
图中把大模型能力与持续演化系统并列对比:左侧的能力组件只在单次调用中产生候选,负责理解、生成与工具调用;右侧的系统闭环通过候选产生、真实检验、成果沉淀、再演化四个环节,判定哪些候选值得写入项目版本并被下一轮继承。
组件与系统闭环对比
图中把大模型能力与持续演化系统并列对比:左侧的能力组件只在单次调用中产生候选,负责理解、生成与工具调用;右侧的系统闭环通过候选产生、真实检验、成果沉淀、再演化四个环节,判定哪些候选值得写入项目版本并被下一轮继承。